


Python神经网络编程性能优化:GPU加速与批量数据处理技巧
深入讲解Python与PyTorch深度学习环境下的性能优化实战,剖析GPU加速计算、DataLoader多进程批量加载、锁页内存异步传输及自动混合精度(AMP)调优技巧。
在基于Python编写和训练神经网络时,很多人常遇到一种看似矛盾的现象:虽然配备了高性能独立显卡,但在训练循环运行期间,nvidia-smi监控显示的GPU利用率(GPU-Util)却长期在0%与100%之间剧烈跳动,平均利用率甚至不足40%。这种算力闲置的根源,绝大多数不在于网络结构的计算复杂度,而在于数据读取、前处理和CPU至GPU的数据传输流水线没有与显卡计算单元实现充分重叠。本文立足于实际工程实践,聚焦于解决数据供给瓶颈与张量运算调度两大核心问题,提供从底层机制分析到完整代码落地的优化方案。
一、性能瓶颈成因:为什么GPU总是“吃不饱”?
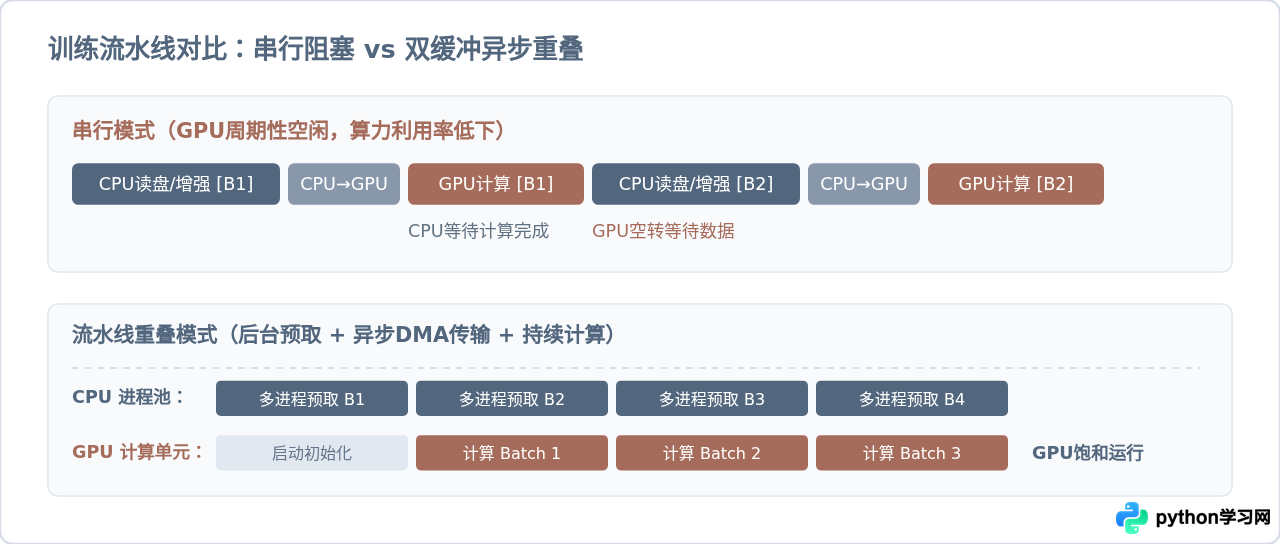
深度神经网络训练由两个基本阶段交替驱动:CPU端的数据准备与GPU端的张量计算。如果采用朴素的Python代码编写训练循环,训练执行模式是严格串行的:CPU从固态硬盘或内存中解压图片并执行数据增强,接着调用传输指令将当前批次数据搬运到显卡显存中,最后GPU开始前向传播与反向传播。在此期间,GPU计算核心必须完全挂起等待数据;而当GPU全速计算时,CPU又往往处于空闲状态。
衡量模型训练效率的核心指标是单位时间内的样本吞吐量(Samples Per Second)。要消除GPU的等待时间,理想的架构是建立双缓冲(Double Buffering)流水线,使CPU在当前第N批次数据于GPU上执行计算的同时,并行在后台读取并预处理第N+1批次数据,并通过异步流(CUDA Stream)提前推送至显存。
二、高效批量数据处理:DataLoader配置核心准则
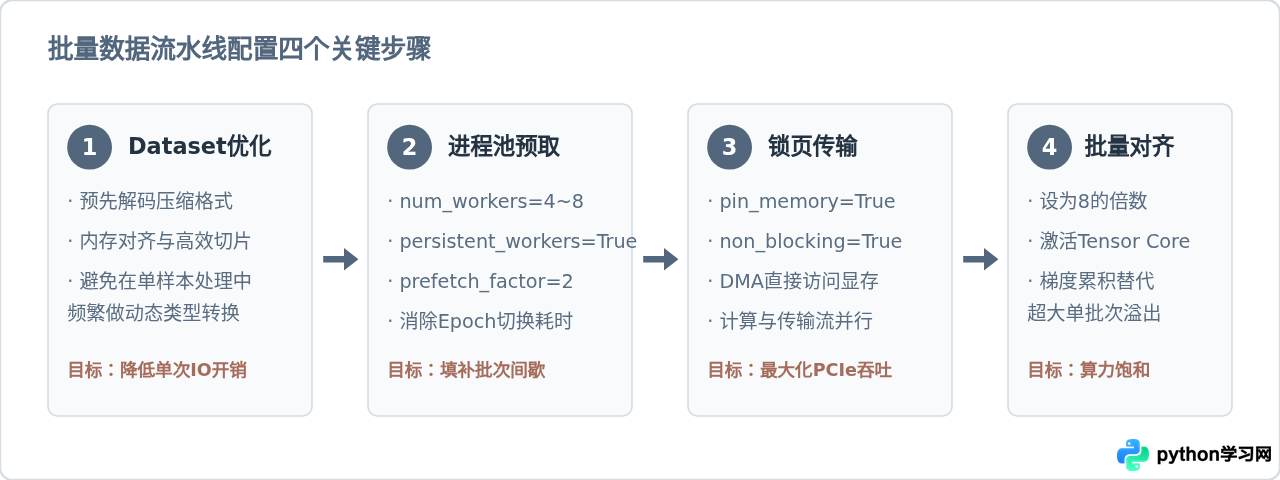
在PyTorch生态中,torch.utils.data.DataLoader是构建数据流水线的核心组件。许多教程中直接使用默认参数构造加载器,但这在真实模型训练中往往会导致严重的I/O瓶颈。优化数据加载需从以下关键参数与步骤切入:
1. num_workers:多进程并行数据加载
Python由于全局解释器锁(GIL)的存在,单线程无法发挥多核CPU的并发计算能力。当num_workers=0时,数据加载与模型计算在同一个主进程中运行。设置num_workers > 0会拉起独立的Worker子进程并行执行Dataset.__getitem__()。经验法则是将其设置为可用物理CPU核心数的70%~100%,或者每张显卡分配4~8个Worker。但过大的数值会导致进程切换开销过大和内存迅速膨胀。
2. pin_memory=True:锁页内存加速主机到设备传输
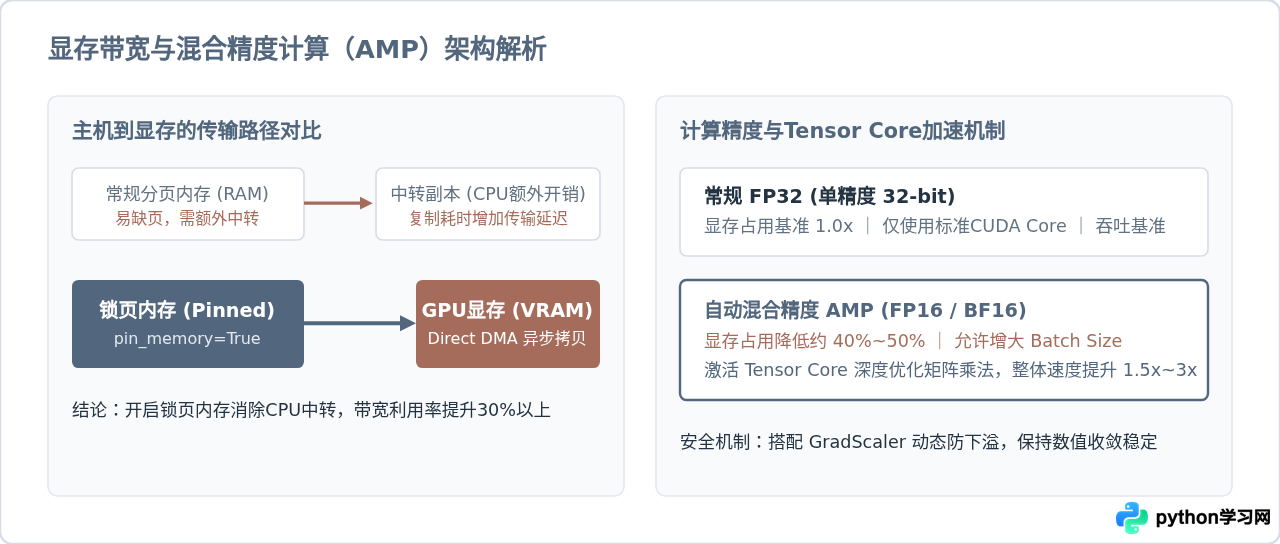
常规操作系统分配的内存是分页内存(Pageable Memory),当显卡需要通过PCIe总线从主机内存读取数据时,CPU必须先将分页内存拷贝到临时锁页内存(Pinned Memory),再通过DMA(Direct Memory Access)引擎传输至显存。开启pin_memory=True后,DataLoader会直接在主机锁页内存中构造张量,使后续的张量拷贝跳过中间暂存,大幅提升PCIe带宽利用率。
3. persistent_workers=True 与 prefetch_factor
默认情况下,每个Epoch结束时,DataLoader都会销毁所有Worker进程并在下一轮重新创建,这种频繁重合进程池的操作在大规模数据集上耗时显著。设置persistent_workers=True可以保持进程常驻。搭配prefetch_factor=2(每个Worker预取2个Batch),能确保GPU取走数据时队列始终处于填满状态。
三、GPU加速与张量传输技巧
解决好CPU端的数据供给后,下一步是优化张量向GPU的搬运方式及模型前向与反向计算的吞吐能力。
1. 异步非阻塞传输(non_blocking=True)
在循环体内部,通常使用inputs = inputs.to(device)将张量从CPU传递至GPU。默认情况下这是一个同步调用:主线程会等待PCIe总线完全搬运完数据后才继续往下执行。在配合pin_memory=True的前提下,使用inputs = inputs.to(device, non_blocking=True)可以触发异步拷贝,数据传输在后台独立的CUDA传输流中执行,使得CPU可以即刻继续调度下一条指令,实现传输与计算的物理并行。
2. 慎用阻塞式同步函数
许多开发者习惯在每个迭代周期打印损失值或记录精度,例如写出print(f"loss: {loss.item()}")或tensor.cpu().numpy()。需要特别注意:.item()和.cpu()属于强制同步操作(Host-Device Synchronization),它们会强制清空GPU命令队列并等待GPU完成当前算子的全部物理计算并返回结果给CPU。如果在训练的核心迭代内频繁调用此类同步操作,会彻底打破CUDA流的异步调度流水线,使GPU利用率出现断崖式下跌。正确做法是累积固定步数(例如每100步)再同步一次,或使用异步日志采集工具。
3. 自动混合精度训练(AMP, Automatic Mixed Precision)
现代GPU计算架构(如NVIDIA Volta、Ampere及更新架构)内嵌了专门处理矩阵乘加运算的Tensor Core单元。在FP16(半精度浮点)或BF16格式下,Tensor Core的吞吐量可达FP32(单精度)的2倍至4倍,同时显存占用直接降低近50%。
PyTorch提供了成熟的torch.amp.autocast与GradScaler接口:在前向传播中自动将卷积、矩阵乘等重算力算子转换为FP16运算,而在Softmax、损失计算等数值敏感区域保留FP32;反向传播中使用动态缩放器(GradScaler)放大梯度,防止FP16下溢。这无需改动网络架构,即可获得近乎翻倍的加速比。
四、端到端优化代码示例
以下为一个符合生产规范的高性能训练循环参考实现。代码整合了多进程预取DataLoader、锁页内存、非阻塞数据传输、自动混合精度及梯度累积机制:
import torch
import torch.nn as nn
from torch.utils.data import Dataset, DataLoader

# 1. 模拟自定义高效Dataset
class SyntheticDataset(Dataset):
    def __init__(self, size=20000, features=128):
        # 预先分配连续内存,避免在getitem内发生不必要的动态复制
        self.data = torch.randn(size, features, dtype=torch.float32)
        self.labels = torch.randint(0, 2, (size,), dtype=torch.int64)

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        return self.data[idx], self.labels[idx]

def run_optimized_training():
    # 确定计算设备
    device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    print(f"当前运行设备: {device}")

    # 启用 cuDNN 自动基准算子选择(针对固定输入尺度的卷积或矩阵运算提速明显)
    if device.type == "cuda":
        torch.backends.cudnn.benchmark = True

    # 2. 构造高吞吐 DataLoader
    dataset = SyntheticDataset()
    train_loader = DataLoader(
        dataset,
        batch_size=256,             # 建议设置为8或16的倍数以对齐硬件调度
        shuffle=True,
        num_workers=4,              # 启用多子进程读取
        pin_memory=True if device.type == "cuda" else False, # 启用锁页内存
        persistent_workers=True,    # 跨 Epoch 保持进程池存活
        prefetch_factor=2,          # 每个 Worker 预取批次数
        drop_last=True              # 丢弃末尾不完整批次,维持张量形状一致
    )

    # 3. 构造简单模型与优化器
    model = nn.Sequential(
        nn.Linear(128, 512),
        nn.ReLU(),
        nn.Linear(512, 2)
    ).to(device)

    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
    criterion = nn.CrossEntropyLoss()

    # 4. 初始化混合精度梯度缩放器(GradScaler)
    scaler = torch.amp.GradScaler('cuda', enabled=(device.type == "cuda"))

    # 梯度累积步数(在有限显存下模拟更大的等效Batch Size)
    accumulation_steps = 2
    epochs = 3

    model.train()
    for epoch in range(epochs):
        running_loss = 0.0
        optimizer.zero_grad(set_to_none=True) # 比 zero_grad() 性能更高

        for step, (inputs, targets) in enumerate(train_loader):
            # 5. 异步非阻塞数据传输
            inputs = inputs.to(device, non_blocking=True)
            targets = targets.to(device, non_blocking=True)

            # 6. 开启自动混合精度前向计算
            with torch.amp.autocast('cuda', enabled=(device.type == "cuda")):
                outputs = model(inputs)
                loss = criterion(outputs, targets)
                # 针对累积步数调整单步损失权重
                loss = loss / accumulation_steps

            # 7. 梯度缩放反向传播
            scaler.scale(loss).backward()

            # 达到累积步数后执行权重更新
            if (step + 1) % accumulation_steps == 0 or (step + 1) == len(train_loader):
                scaler.step(optimizer)
                scaler.update()
                optimizer.zero_grad(set_to_none=True)

            # 累计数值时避免频繁调用 .item() 造成全局流水线同步
            running_loss += loss.detach()

        print(f"Epoch [{epoch + 1}/{epochs}] 训练完成")

if __name__ == "__main__":
    run_optimized_training()
optimizer.zero_grad()会将所有模型参数的梯度张量显式填充为浮点数0.0,这会产生额外的内存写入操作。设置set_to_none=True直接将.grad属性指向None,在下一次反向传播时PyTorch会直接覆盖分配内存,不仅节省显存读写带宽,还能带来约3%~5%的细微提速。
五、性能排查矩阵与调优决策指南
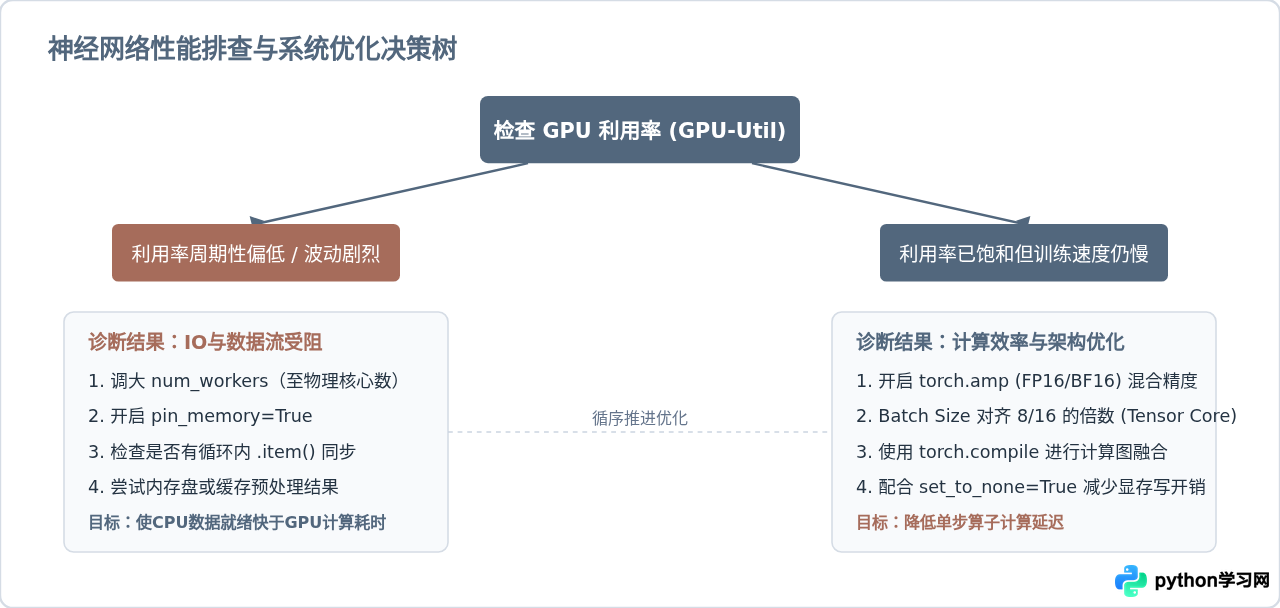
在实际模型工程落地时,当发现训练吞吐未达预期,应按照系统化的诊断顺序排查瓶颈,而非盲目调整批大小。下表梳理了常见现象、底层原因及确切对策:
| 观察现象 (Symptom) | 本质瓶颈 (Bottleneck) | 排查与推荐方案 (Actionable Fix) |
|---|---|---|
| GPU利用率在 0% 和 100% 间交替跳动 | CPU数据读取或前处理耗时显著长于GPU计算 | 调大 num_workers;将图像Resize等轻量操作改为预处理离线存储;开启 prefetch_factor=2 |
| 显存占用极高但计算吞吐(Sample/s)极低 | 算子计算受限于显存带宽,算力未发挥 | 开启 torch.amp.autocast 混合精度;优化模型结构中使用过大通道的浅层网络 |
| CPU内存占用随训练轮次持续递增 | DataLoader Worker 子进程内存泄露 | 检查 __getitem__ 中是否保存了全局大字典或引用了外部对象,避免多进程fork导致的内存写时复制失效 |
| 每个Epoch开始时有长达数秒或数十秒停顿 | 进程池反复销毁与重建开销 | 在 DataLoader 中开启 persistent_workers=True |
| PCIe数据搬运耗时过长,阻塞计算主线程 | 使用分页内存同步拷贝 | 设置 pin_memory=True 并在张量传输时使用 non_blocking=True |
六、总结
深度神经网络的编程性能优化不是孤立的代码微调,而是一个涵盖“磁盘I/O读取 — CPU多进程增强 — 主机锁页传输 — GPU张量核高吞吐运算”的完整管道工程。在实践中,首先应当借助监控定位系统瓶颈究竟卡在CPU端还是GPU端:对于数据瓶颈,重点利用DataLoader(num_workers, pin_memory, persistent_workers)构建异步流水线;对于计算瓶颈,优先采用自动混合精度(AMP)与张量尺寸对齐技巧。将各层级的重叠与异步机制结合运用,能够最大化挖掘硬件算力潜能,显著缩短模型研发与迭代周期。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















