


Python版本对AI库兼容性的影响及升级建议
深入解析Python版本对PyTorch、TensorFlow等核心AI库兼容性的底层影响机制,对比保守版本与前沿版本的实际差异,并提供稳妥的升级评估与操作建议。
在人工智能与机器学习项目开发中,升级Python解释器版本往往不仅意味着语法糖或原生性能的改善,更会直接影响到底层预编译二进制轮子(Wheel)、C/C++扩展接口(C-API/ABI)以及GPU加速驱动栈的协同运作。本文旨在厘清Python主次版本迭代对PyTorch、TensorFlow、JAX等核心计算库的具体制约机制,对比稳定受支持版本与激进新版本的差异,并给出可直接落地的版本选型与平滑升级步骤。
一、底层机制:为什么AI库对Python版本极度敏感
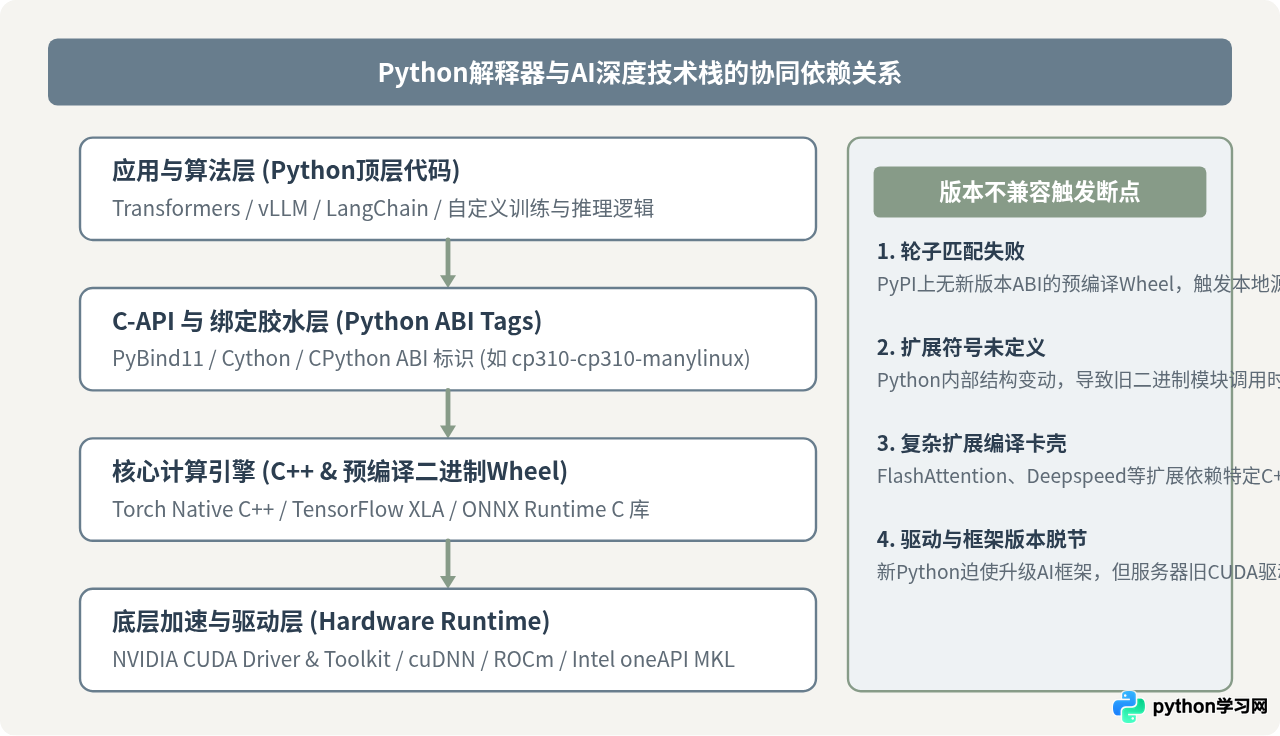
普通的纯Python代码通常具有良好的向前与向后兼容性,但AI核心库的结构截然不同。PyTorch、TensorFlow、ONNX Runtime以及vLLM等现代计算框架,其核心计算引擎与算子调度均采用C++、CUDA甚至汇编语言编写,并通过Python C-API(例如PyBind11或Cython)暴露接口。这种特殊的技术架构使AI库与Python版本形成了强耦合绑定。
具体而言,影响兼容性的底层约束主要集中在以下三个层面:
- CPython C-API 与 ABI 稳定性: Python在不同次版本之间(例如 3.10 到 3.11,或 3.11 到 3.12)并不保证底层的应用二进制接口(ABI)完全向后兼容。解释器内部对象结构体(如
PyTypeObject)或关键宏的变动,会导致依赖特定ABI编译的动态链接库直接失效。 - 预编译Wheel分发机制: 为避免用户在本地安装时从头调用C++与CUDA编译器,主流AI框架会针对特定的Python版本(如
cp310、cp311)和操作系统ABI标准(如manylinux2014)预先在构建机上生成二进制.whl文件。如果用户运行了较新的Python版本而官方尚未发布对应轮子,pip将回退到源码构建流程,而在绝大多数普通机器上缺乏配套的构建工具链往往会导致安装直接中断。 - 硬件加速库与编译工具链协同: PyTorch等框架在发布二进制包时,通常将特定的CUDA Runtime、cuDNN和NCCL版本静态捆绑或指定动态链接。构建这些巨型动态库需要数小时至数天的矩阵构建时间,因此上游社区对最新Python版本的适配往往存在数月到一年的时间窗口滞后。
二、典型故障场景与表现形式
在日常环境配置或部署中,因Python解释器版本不匹配导致的故障往往具有固定的错误特征。识别这些特征有助于快速定位根因:
1. 找不到匹配版本分布(No matching distribution found)
在过高或过低的Python版本中安装特定版本的框架时,pip会提示无法检索到分发包。例如在刚发布不久的Python 3.13环境下尝试安装标准PyTorch:
# 终端执行命令
pip install torch torchvision

# 示例错误输出
ERROR: Could not find a version that satisfies the requirement torch (from versions: none)
ERROR: No matching distribution found for torch
这是因为PyTorch官方仓库的发布资产中,仅包含与当时已测试Python版本(如 cp310、cp311、cp312)对应的Wheel,尚未构建对应更高版本的Wheel包。
2. 构建轮子失败与缺少头文件(Building wheel for ... failed)
当安装某些轻量或周边扩展库(如某些分词工具、特定格式序列化库)时,若没有预编译包,pip会尝试就地编译。如果高版本Python移除了旧版C-API或标准库中已被废弃的模块(例如Python 3.12正式移除了内置的 distutils),编译就会因头文件缺失或宏定义失效而中断:
# 源码编译失败示例
ModuleNotFoundError: No module named 'distutils'
error: command 'gcc' failed with exit status 1
Building wheel for ninja (pyproject.toml) ... error
3. 运行时动态符号错误(undefined symbol)
如果环境中的某些扩展是在前一个Python版本或不同ABI配置下编译的,在运行时导入模块时可能触发动态链接器报错:
# 运行时导入报错示例
ImportError: /envs/myenv/lib/python3.11/site-packages/torch/_C.cpython-311-x86_64-linux-gnu.so:
undefined symbol: _PyGen_Send
三、状态对比:保守稳定版 vs 前沿激进版的权衡
在技术选型中,开发者常常面临两种倾向:一种是倾向于追求最新解释器带来的原生性能提升和新语法;另一种是坚持留在上游支持最广泛的稳定版本。理解两者在AI生态中的关键差异,是做出合理技术决策的前提。
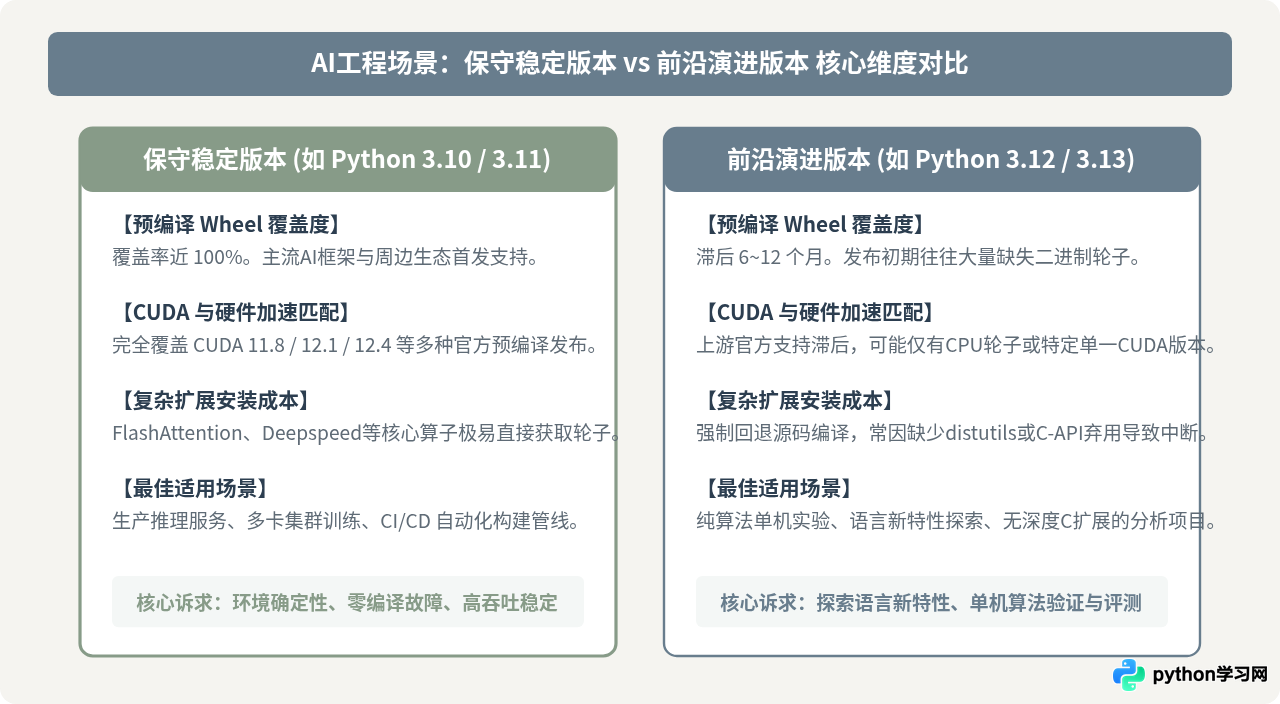
从上图的对比可以看出,差异的核心不在于语言层面的语法优劣,而在于生态成熟度与构建确定性:
- 为什么差异至关重要: 在深度学习场景中,训练任务和在线推理的核心开销集中在GPU显存带宽与Tensor Core张量计算上,Python解释器自身提速对端到端吞吐的影响通常不足5%。然而,一旦因为追求最新Python版本而导致底层算子(例如FlashAttention或特定量化算子)无法编译,计算效率可能会断崖式下跌,甚至完全阻断任务运行。
- 版本生命周期的安全窗口: 行业通用实践通常采用“N-1”或“N-2”策略。例如,当Python 3.13发布时,生产或深度学习主力环境通常推荐选用经过多轮小版本修补且生态轮子极为健全的Python 3.10或3.11。
四、升级评估与规范操作流程
对已有AI项目升级Python版本,不能直接在全局环境或原环境中执行覆盖安装。规范的升级过程应遵循“盘点预先评估、沙盒完全隔离、核心框架优先、冒烟测试闭环”的路径。
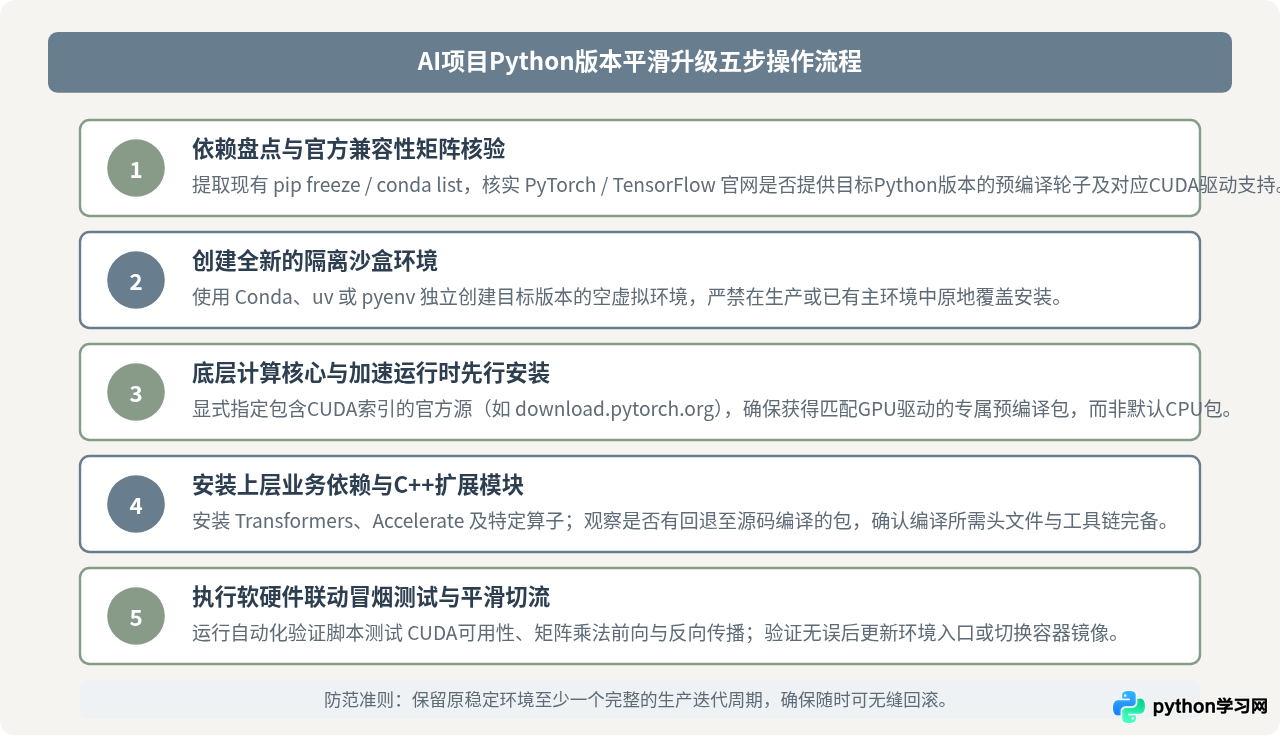
各步骤具体操作示例
第一步:检查当前显卡驱动支持的最高CUDA版本
升级前必须明确当前主机的驱动支持边界。在终端运行:
# 查看驱动与CUDA最高支持版本
nvidia-smi
在输出的右上角会显示 CUDA Version: 12.x,所安装的PyTorch对应CUDA版本不能高于该上限。
第二步:创建独立的沙盒环境(以Conda为例)
# 创建基于 Python 3.11 的新环境,避免污染旧环境
conda create -n ai_py311 python=3.11 -y

# 激活新环境
conda activate ai_py311
第三步:优先安装核心计算框架并指定CUDA加速源
以安装与CUDA 12.1配套的PyTorch为例,必须显式引用官方的Wheel仓库地址:
# 执行精确匹配安装
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
第四步:运行冒烟验证脚本
安装完成后,使用一段简洁的测试脚本检查CUDA识别状态及基础张量计算:
# 验证脚本 check_env.py
import sys
import torch

print(f"Python 解释器版本: {sys.version.split()[0]}")
print(f"PyTorch 框架版本: {torch.__version__}")
print(f"CUDA 是否可用: {torch.cuda.is_available()}")

if torch.cuda.is_available():
    print(f"当前设备: {torch.cuda.get_device_name(0)}")
    # 创建张量并在GPU上执行点积运算
    x = torch.randn(1000, 1000, device='cuda')
    y = torch.matmul(x, x)
    print("GPU张量矩阵乘法运算成功,结果形状:", y.shape)
else:
    print("警告: 当前运行在CPU模式下,请检查CUDA安装!")
在终端执行并确认输出:
# 预期执行输出示例
Python 解释器版本: 3.11.8
PyTorch 框架版本: 2.3.0+cu121
CUDA 是否可用: True
当前设备: NVIDIA A100-SXM4-80GB
GPU张量矩阵乘法运算成功,结果形状: torch.Size([1000, 1000])
五、AI项目版本选型决策路径
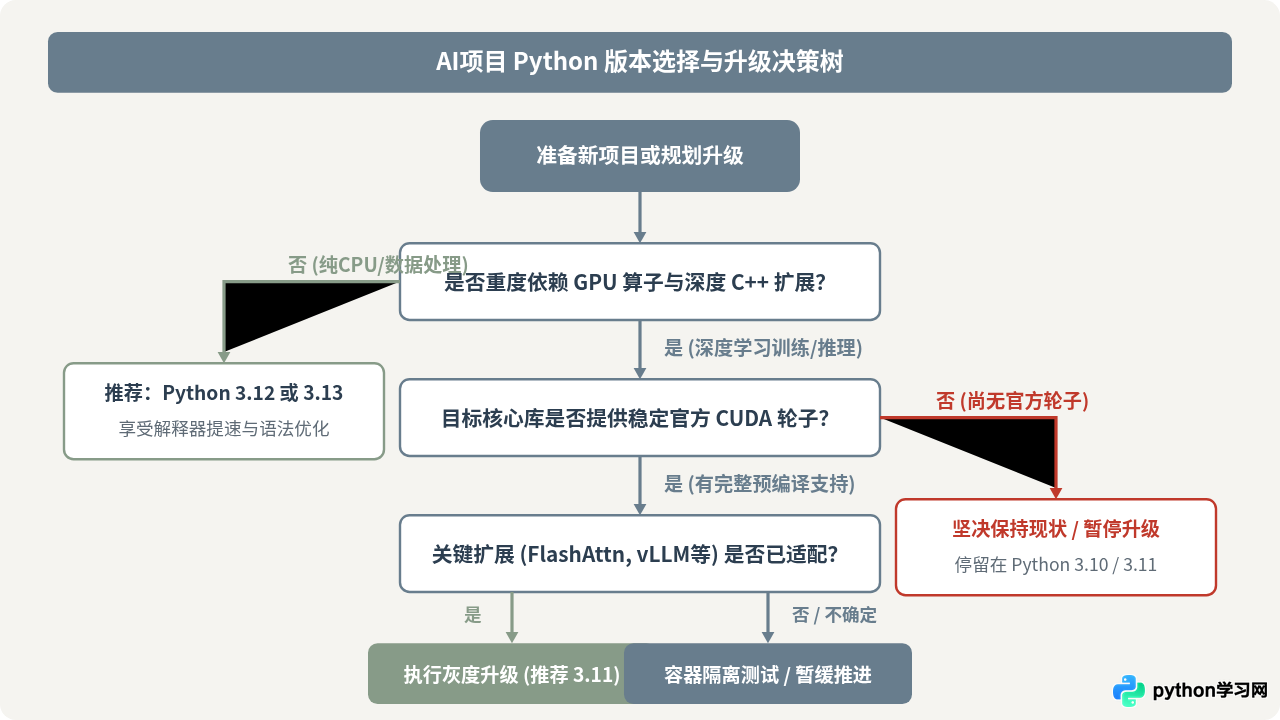
当启动新项目或评审存量项目升级计划时,可以根据以下决策树快速确定最适合的Python解释器版本:
六、长期维护与依赖锁定建议
为了确保AI项目在生命周期内具备可复现性并降低环境演进带来的摩擦,建议采纳以下工程实践:
1. 使用现代包管理工具固化完整环境
传统的 requirements.txt 往往只记录了顶层包名,在重新安装时可能拉取到破坏ABI兼容性的间接依赖版本。推荐使用 uv 或 conda-lock 生成平台专用的锁定文件:
# 使用 uv 编译锁定文件示例
uv pip compile pyproject.toml -o requirements.lock --generate-hashes
锁定文件记录了特定平台(如 manylinux)、特定Python版本和哈希值,能从根本上消除构建漂移。
2. 深度学习生产环境优先采用容器镜像
对于工业级训练与推理服务,直接在宿主机升级Python版本是高危操作。推荐直接采用硬件厂商提供的官方容器底座(如 NVIDIA NGC PyTorch 容器)。NGC容器不仅预先配置了匹配严密的Python解释器、CUDA驱动、cuDNN、NCCL与深度优化算子,还经过了系统级的压力与稳定性验证。升级时仅需变更Docker镜像标签,即可实现毫秒级切换与一键回滚。
总结: 在AI工程中,Python版本的选择是一场关于“生态稳定度”与“环境确定性”的技术决策。除非有明确的语法或核心性能瓶颈需要突破,切勿单纯为了追踪版本数字而盲目升级生产解释器;始终遵循“查验官方Wheel支持 -> 独立沙盒验证 -> 冒烟算子闭环”的流程,才能确保算力资源与模型服务的持续稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















