


Python读取.xls格式Excel报错解决:xlrd版本限制与替代方案
针对Python读取.xls格式Excel时遇到的xlrd版本限制报错问题,系统分析xlrd 2.0.0移除.xlsx支持后的实际边界,以及读取.xls文件的常见报错原因,并提供排查步骤、降级版本、替代解析库与格式批量转换等实用解决方案。
在Python处理旧版Excel文件(.xls格式)时,开发者常遇到类似 xlrd.biffh.XLRDError 或 XLRDError: Excel xlsx file; not supported 的异常。本文直接提供排查逻辑、核心成因说明及四种可行解决路径:辨别真假 .xls 格式、锁定兼容的 xlrd 依赖版本、引入支持旧格式的现代替代库,以及实施批量格式转换。
一、版本变迁与报错成因定位
很多开发者在更新依赖后突然发现原有的数据导入脚本崩溃,这通常源于对 xlrd 版本历史与实际文件格式的误判。
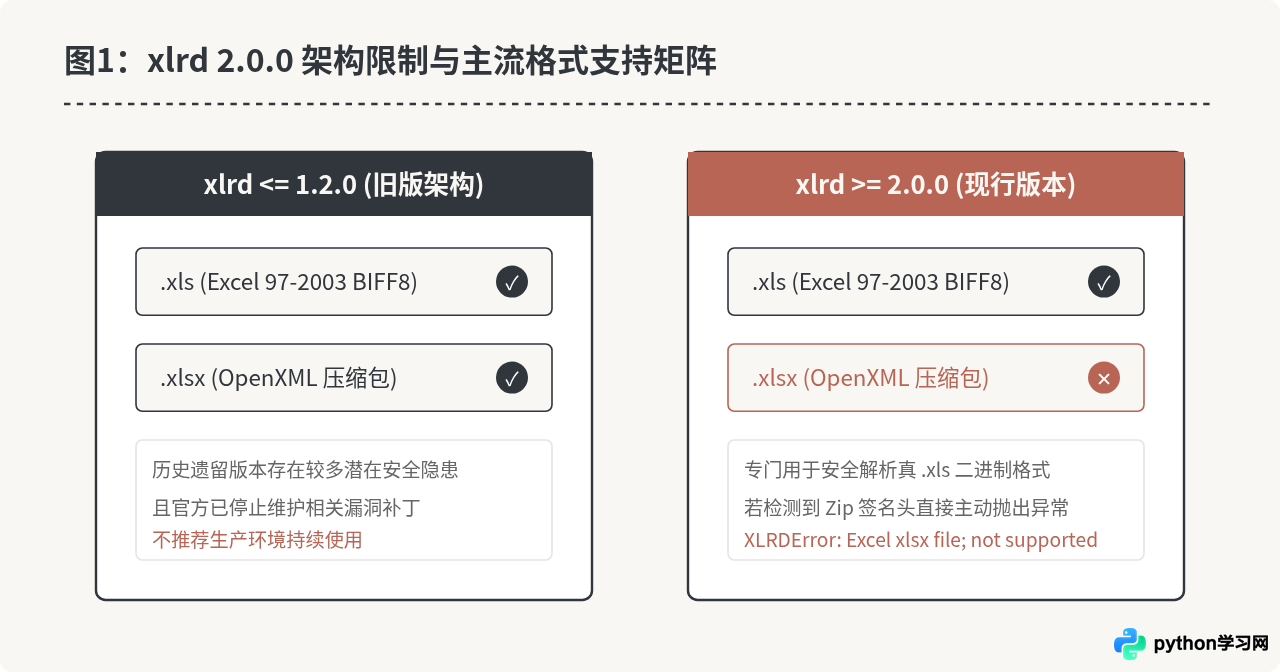
2020年12月,xlrd 发布了 2.0.0 正式版。该版本做出了重大破坏性调整:彻底移除了对 .xlsx 格式的支持,仅保留解析传统的 Excel 97-2003(即 BIFF8 格式的 .xls 文件)功能。这一调整导致了两种常见的报错场景:
- 场景 A:扩展名为
.xls,实际底层为.xlsx(Zip压缩包)。一些业务系统在导出文件时,直接把现代格式保存为.xls后缀。升级后的xlrd>=2.0.0检查文件签名发现实际是 OpenXML 格式,立刻抛出XLRDError: Excel xlsx file; not supported。 - 场景 B:Pandas 默认引擎冲突。在较高版本的 Pandas 中,若未显式指定
engine参数,读取.xls文件时会默认调用当前环境的xlrd。若未安装xlrd或该文件其实为伪装的.xls,也会抛出引擎错误或解析异常。 - 场景 C:HTML 伪装成
.xls。部分老系统导出的.xls实际上是带<table>标签的纯文本 HTML 表格,xlrd尝试使用二进制 BIFF 引擎解析时会报Unsupported format, or corrupt file。
二、报错排查:识别真实的文件签名
遇到报错时,第一步不是盲目修改代码,而是确认目标文件的真实二进制头部(Magic Number)。操作系统上以 .xls 结尾的文件,底层可能对应以下三种形式之一:
| 文件头部十六进制签名 | 实际格式类型 | 对应解析方案 |
|---|---|---|
D0 CF 11 E0 A1 B1 1A E1 |
标准 OLE2/BIFF8(真 .xls) |
使用 xlrd>=2.0.0 或 pyexcel-xls 解析 |
50 4B 03 04 (PK..) |
ZIP 压缩格式(实际为 .xlsx) |
修改后缀或指定 openpyxl 引擎读取 |
3C 68 74 6D 6C (<html) 或纯文本 |
HTML 表格或 CSV 伪装 | 使用 pandas.read_html() 直接提取表格 |
可以通过一段简短的 Python 代码在内存中快速检验文件头,避免猜测:
with open("sample_data.xls", "rb") as f:
    header = f.read(8)

if header.startswith(b"\xd0\xcf\x11\xe0"):
    print("确认:标准二进制 .xls 格式")
elif header.startswith(b"PK\x03\x04"):
    print("警告:实际为 .xlsx 文件,但使用了 .xls 后缀")
elif b"<html" in header.lower() or b"<table" in header.lower():
    print("警告:实际为 HTML 格式表格伪装的 .xls 文件")
else:
    print(f"其他或损坏文件,头字节为: {header.hex()}")
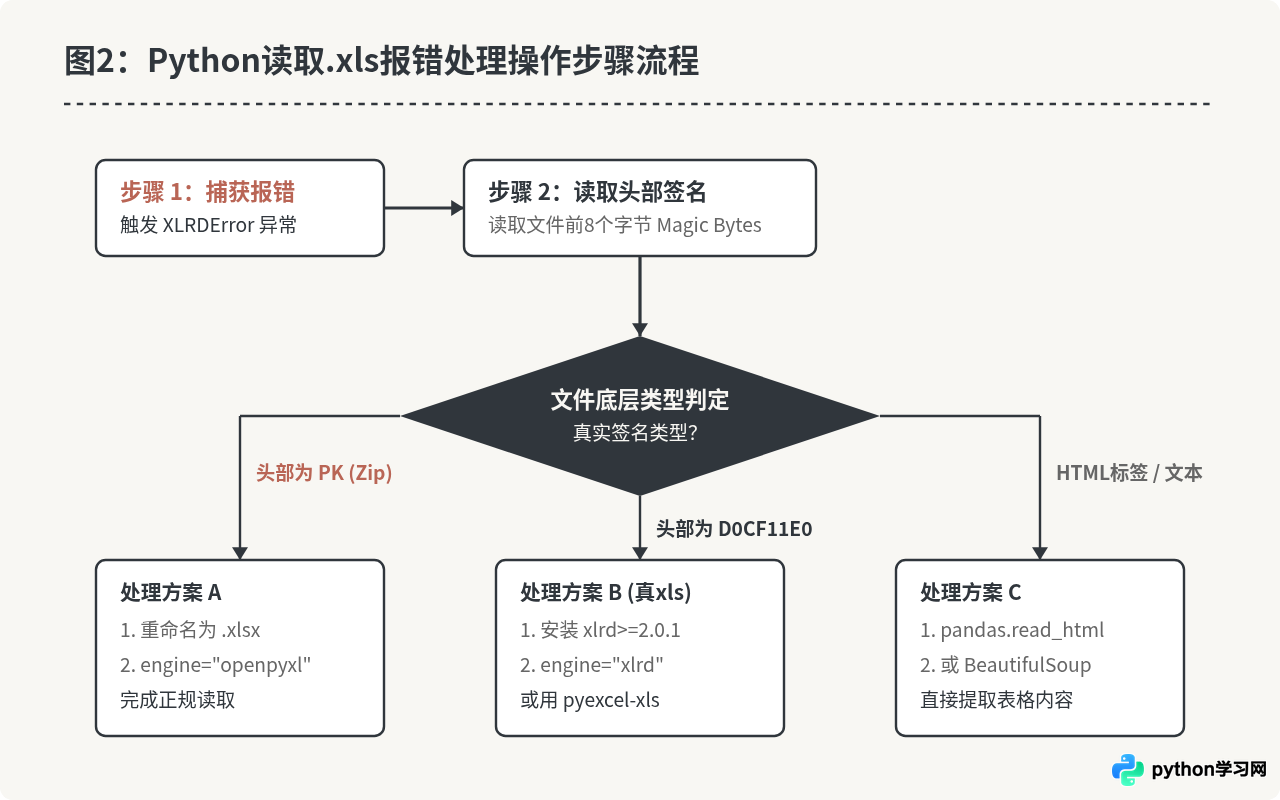
三、排查与处理步骤流程
根据文件头的探测结果,可以按照标准决策流程采取针对性的处置措施。下图清晰展示了排查与修复的具体决策分支:
四、具体解决方案与代码实现
方案 1:确认真实 .xls 格式后,正确配置 xlrd 环境
如果经过检查确认文件是标准的二进制 .xls,报错往往是因为执行环境中没有安装 xlrd,或者依赖冲突。
在当前主流环境中,直接安装最新的 xlrd(版本 >= 2.0.1)即可完整解析真实 .xls:
pip install xlrd pandas在 Pandas 中读取时,显式传入 engine="xlrd",确保执行引擎明确:
import pandas as pd

# 显式指定 xlrd 解析标准的 .xls 文件
df = pd.read_excel("standard_report.xls", engine="xlrd")
print(df.head())注意:如果必须在同一个脚本中兼顾旧版本 .xlsx 且不改动任何旧逻辑,部分人会选择执行 pip install xlrd==1.2.0。但强烈不建议在生产环境长期依赖 xlrd 1.2.0。该版本自2020年起已停止维护,存在已知的安全漏洞(如潜在的拒绝服务与内存异常风险),仅可作为应急过渡使用。
方案 2:如果是伪装成 .xls 的 .xlsx 文件,改用 openpyxl
若文件底层是 ZIP 结构,说明是 .xlsx 格式被错误保存了扩展名。这种情况下,使用 openpyxl 引擎即可正常读取:
import pandas as pd

# 直接使用 openpyxl 引擎解析伪装为 .xls 的现代工作簿
df = pd.read_excel("fake_old_format.xls", engine="openpyxl")
print(df.head())
方案 3:使用 pyexcel-xls / pyexcel 作为替代解析库
在需要轻量处理旧版 .xls 且不希望深度依赖 Pandas 时,pyexcel-xls 是一个极佳的解耦选择。它能够直接将 .xls 文件加载为 Python 标准字典与列表:
pip install pyexcel pyexcel-xlsimport pyexcel as p
# 获得以工作表名称为键的 OrderedDict
records = p.get_book_dict(file_name="data.xls")
for sheet_name, sheet_data in records.items():
print(f"工作表: {sheet_name}, 总行数: {len(sheet_data)}")
for row in sheet_data[:3]: # 查看前3行
print(row)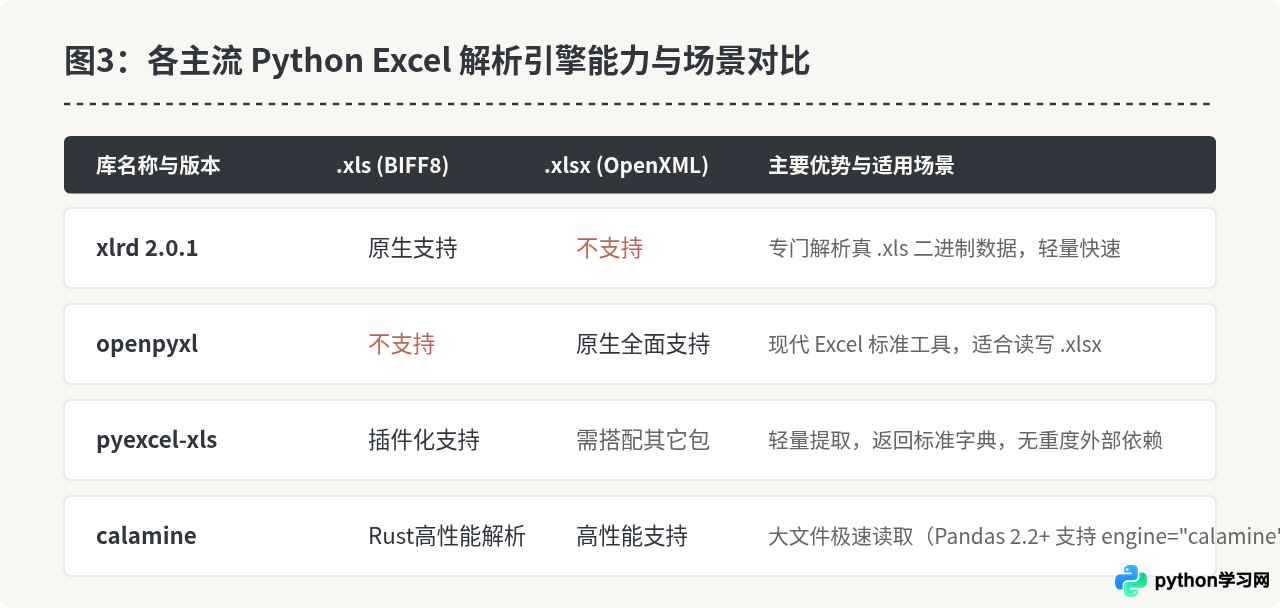
方案 4:批量格式转换(长效维护的最佳实践)
对于企业长期运行的自动化数据管线,反复适配20年前的 .xls 格式会持续增加技术债务。最好的长效方案是在数据入口层将 .xls 自动化转换为 .xlsx。
在 Linux/macOS 服务器端,可以借助无头模式的 LibreOffice 进行安全无损的批处理转换:
# 利用系统级工具批量转换目录下所有 .xls 为现代 .xlsx
libreoffice --headless --convert-to xlsx *.xls
转换完成后,整个工程管线即可完全统一采用 openpyxl 进行稳定处理:
import pandas as pd

# 统一管道处理
df = pd.read_excel("converted_report.xlsx", engine="openpyxl")
五、全生命周期架构与选型建议总结
为了让读者一目了然地确立技术选型策略,下方的总结图系统梳理了从开发调试到长效生产部署的对应规范:
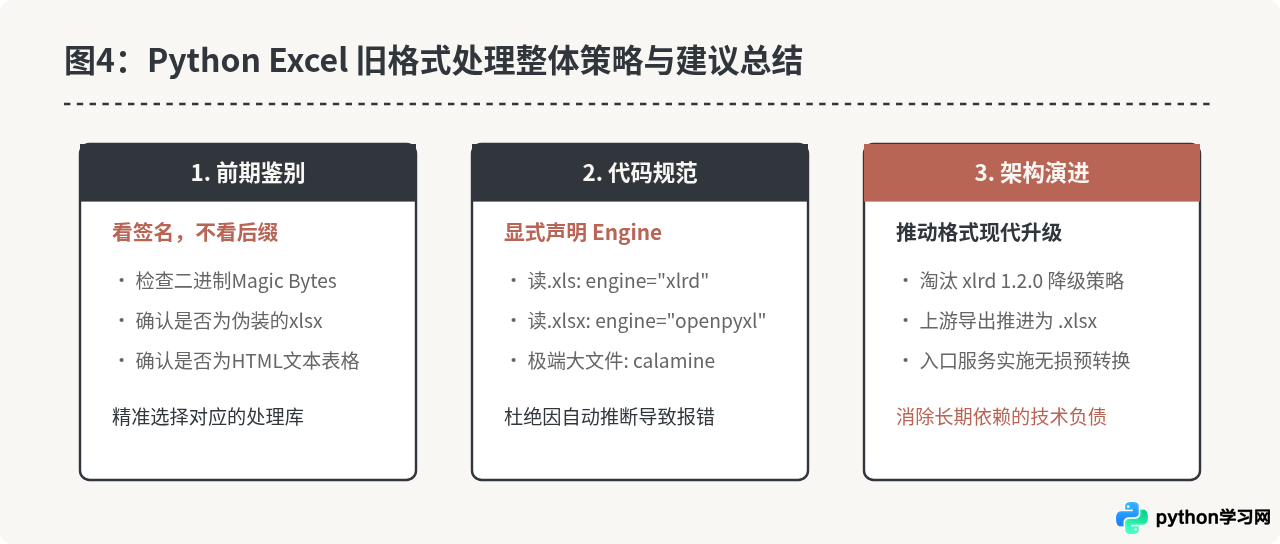
综上所述,xlrd 版本的更新并不是无法读取 .xls,而是对 .xlsx 的格式剥离以及对畸形文件的严格防护。在处理旧格式数据时,只要通过签名校验分辨真伪,显式指定引擎或配合 openpyxl、pyexcel-xls、calamine 等替代工具,即可完全消除此类报错并保持管线稳定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















