


python函数怎么设置可选参数默认值None
详细讲解在Python函数中如何设置可选参数默认值None,涵盖基本定义语法、参数位置规则、可变对象共享陷阱、is None判空边界、区分未传参与显式None的哨兵模式以及Type Hints类型标注的最佳实践。
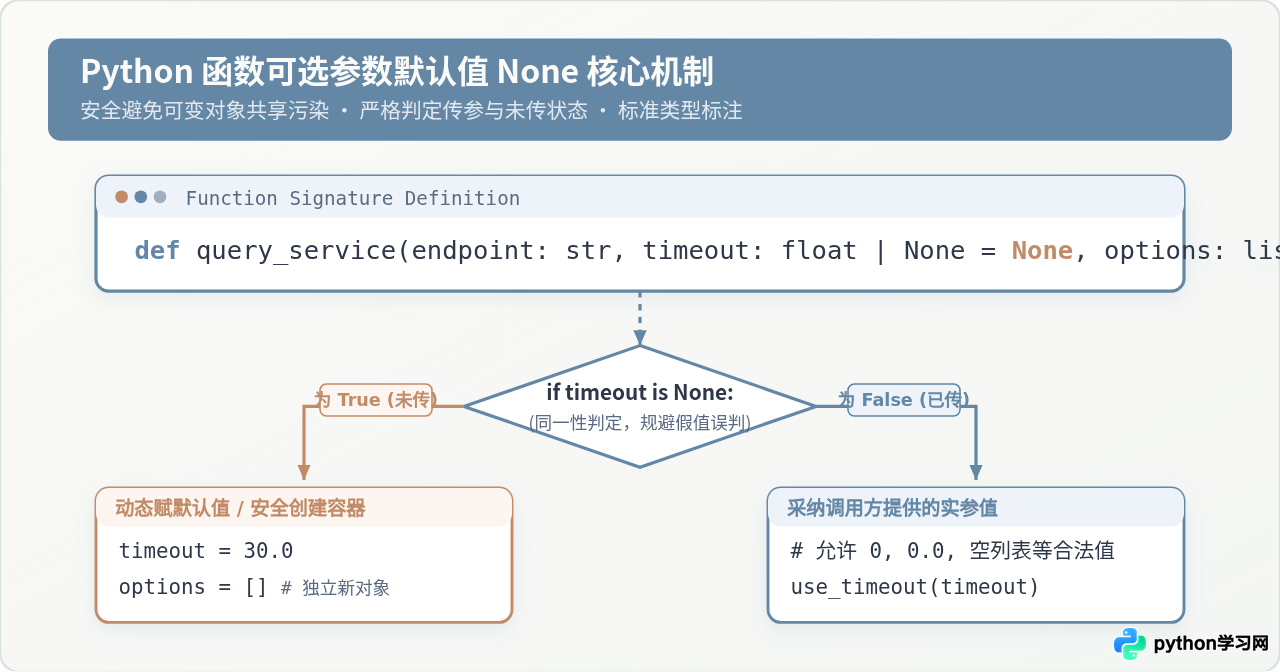
在 Python 中设置可选参数并将默认值设为 None,核心语法是在定义函数的形参列表中使用赋值格式 param=None,并且该参数必须放置在所有无默认值的必选参数之后。在函数体内部,通常结合 if param is None: 进行身份判定,进而动态赋予容器初值或触发备用逻辑。这种设计不仅是 Python 官方推荐的编程范式,也是安全规避可变对象共享污染、处理动态配置和规范函数接口的标准解决方案。
一、基础语法:如何声明与调用参数默认值 None
在 Python 中,带有默认值的形参即为“可选参数”(Optional Argument)。调用函数时,如果调用者提供了该参数,Python 会使用调用者传入的值;如果省略该参数,Python 则自动将其绑定为默认值 None。
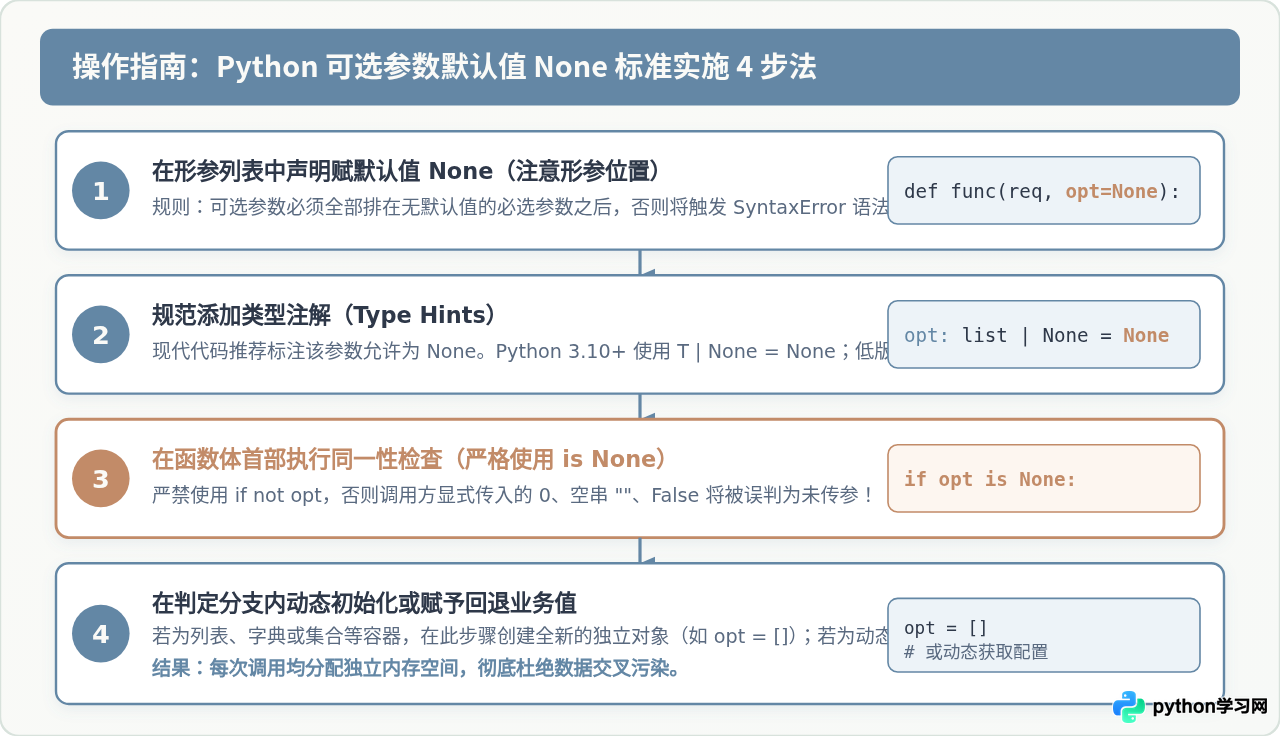
1. 标准定义格式与位置规则
Python 对参数的排列顺序有着严格的语法约束:所有带有默认值的可选参数必须排列在所有没有默认值的必选参数之后。
# 正确示范:必选参数在前,带默认值 None 的可选参数在后
def create_user(username, email, nickname=None, tags=None):
    print(f"用户名: {username}, 昵称: {nickname}, 标签: {tags}")

# 错误示范:带默认值的参数不能出现在必选参数前面
# def invalid_func(nickname=None, username):  # 会抛出 SyntaxError
如果在带默认值的形参后面定义普通必选参数,解释器在语法解析阶段就会直接抛出语法错误:SyntaxError: non-default argument follows default argument。这是因为位置传参从左向右匹配,一旦中间断开默认值,解释器将无法确定实参应与哪一个形参对应。
2. 实参传递的四种常见形式
定义带有 nickname=None 的函数后,调用端具有极大的灵活性:
- 完全省略该参数:直接调用
create_user("alice", "alice@test.com"),函数内部接收到的nickname值为None。 - 按位置传递实参:调用
create_user("alice", "alice@test.com", "小爱"),按序将"小爱"赋给nickname。 - 使用关键字传参:调用
create_user("alice", "alice@test.com", nickname="小爱"),明确指定形参名称,可读性更佳。 - 显式传递 None:调用
create_user("alice", "alice@test.com", nickname=None),主动显式传入None。
*,例如 def func(req, *, opt_a=None, opt_b=None):,强制调用端以关键字方式传参,防止因位置混淆引发传值错误。
二、深度解析:为什么必须用 None 替代可变对象 [] 或 {}
很多初学者在编写函数时,当期望参数默认值为空列表或空字典时,会直觉性地写成 def func(data=[]) 或 def func(options={})。在 Python 中,这是一种极具破坏性的经典反模式(Mutable Default Argument Trap)。
1. Python 默认参数的计算机制
关键在于执行时机:Python 的函数定义是可执行语句。当模块被加载、解释器解析到 def 语句时,默认参数表达式只会被计算一次,并将其直接绑定在该函数对象的 __defaults__ 内部属性中。
这意味着,如果在函数定义中使用 items=[],这个列表对象在内存中是唯一的单例。每一次未传入该参数的函数调用,都会指向完全相同的堆内存地址。
# 危险陷阱演示:使用可变对象作为默认值
def bad_append(val, box=[]):
    box.append(val)
    return box

# 测试连续调用
print(bad_append("A"))  # 输出: ['A'],看似正常
print(bad_append("B"))  # 输出: ['A', 'B']!前一次调用的数据残留在列表中!
print(bad_append("C"))  # 输出: ['A', 'B', 'C']!数据发生跨调用交叉污染
2. 使用 None 作为哨兵解决共享污染
None 是 Python 中的不可变单例对象。将其作为默认参数声明在函数签名中时,不会产生任何副作用。真正的容器创建被推迟到了函数被执行的运行时,从而确保每次调用都拥有全新、隔离的内存空间。
# 正确方案:默认值使用 None,函数内部动态创建
def good_append(val, box=None):
    if box is None:
        box = []  # 仅在本次调用运行时分配新列表,生命周期仅限当前函数栈
    box.append(val)
    return box

print(good_append("A"))  # 输出: ['A']
print(good_append("B"))  # 输出: ['B'],调用间完全隔离,安全无污染
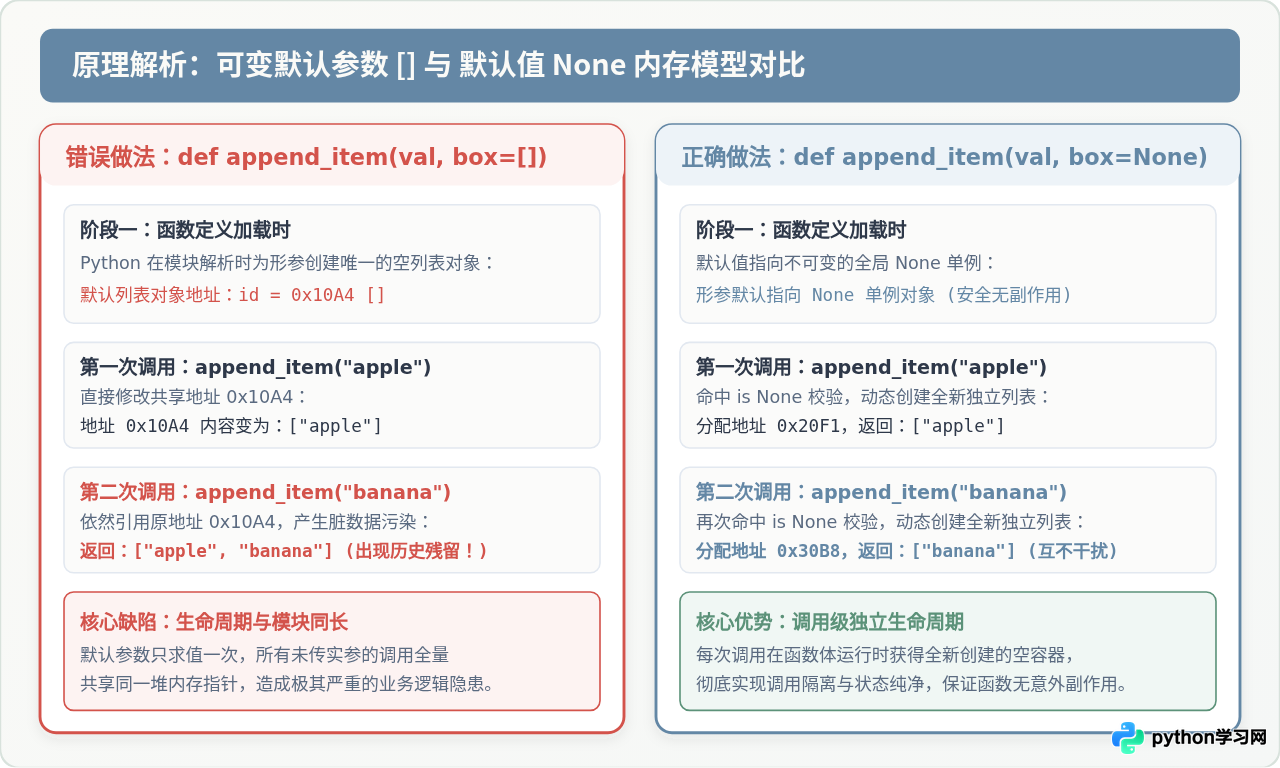
[] 外,字典 {}、集合 set() 以及自定义可变类的实例,若直接作为形参默认值,都会引发完全相同的内存共享污染问题。一律采用 param=None 并在内部初始化是 Python 开发的标准准则。
三、函数内部处理:为什么必须用 is None 而非 not
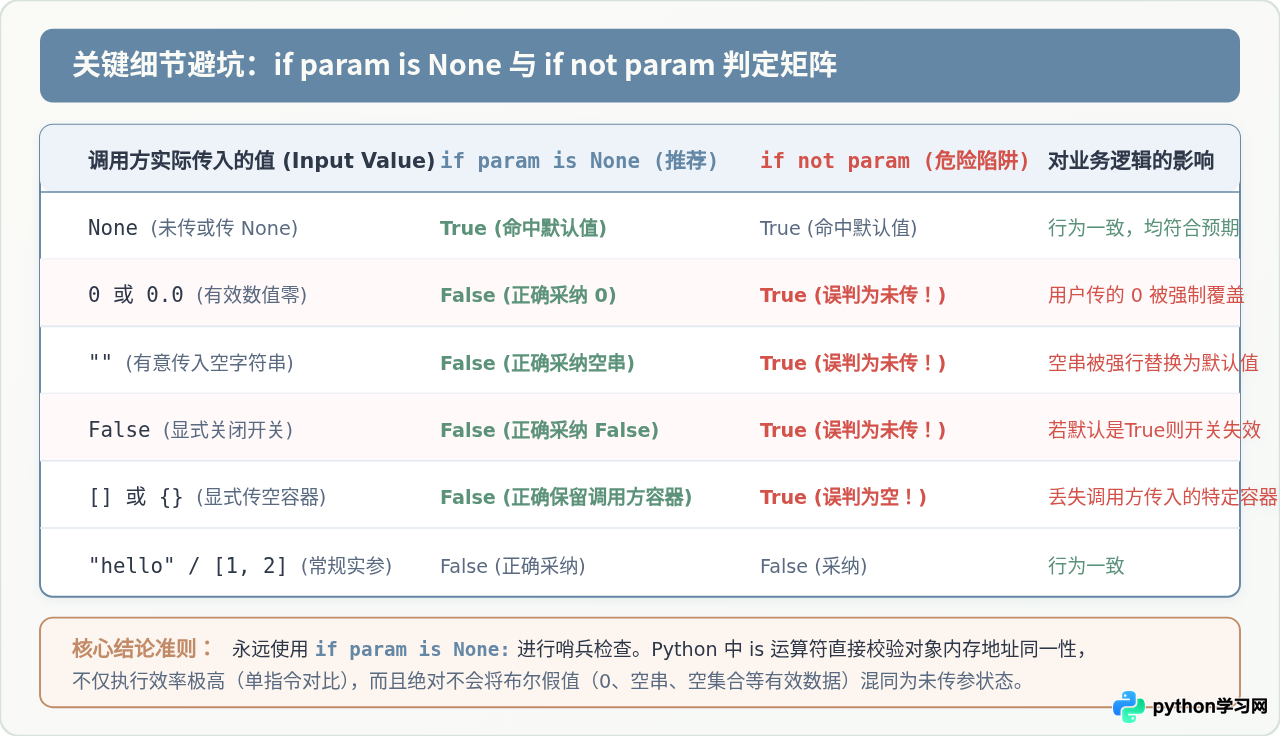
在函数体内部判定调用方是否传递了有效值时,不少开发者习惯写成 if not param:。这种写法在大多数场景下看似可用,但在遇到“合法假值”时会引发极其隐蔽的逻辑缺陷。
1. Python 假值(Falsy)的隐蔽陷阱
在 Python 中,除了 None 之外,数值 0、0.0、空字符串 ""、布尔值 False 以及空容器 []、{} 在布尔上下文判断中均会被评估为 False。
如果函数的业务逻辑允许调用方传入数值 0 或空字符串,使用 if not param: 会导致合法输入被粗暴地误判为“没有传参”,从而被默认配置无情覆盖。
# 错误写法:使用 if not 导致 0 被错误覆盖
def set_retry_count(retries=None):
    if not retries:
        retries = 3  # 期望设置默认重试 3 次
    return f"重试次数设定为: {retries}"

print(set_retry_count())   # 重试次数设定为: 3 (符合预期)
print(set_retry_count(5))  # 重试次数设定为: 5 (符合预期)
# 致命 Bug:调用方明确要求“不要重试”,传入 0
print(set_retry_count(0))  # 错误输出: 重试次数设定为: 3!用户的 0 被覆盖了!
2. 规范做法:严格采用同一性比较 is None
由于 None 在全局是唯一的单例对象,使用 is None 比较的是变量的内存地址指针(Identity),执行速度极快(底层单字节指令对比),且只会在入参严格为 None 时才触发真值分支。
# 正确写法:严格使用 is None
def set_retry_count_safe(retries=None):
    if retries is None:
        retries = 3
    return f"重试次数设定为: {retries}"

print(set_retry_count_safe(0))  # 正确输出: 重试次数设定为: 0
四、进阶模式:如何区分“未传参”与“显式传入 None”
在某些特殊业务场景中,None 本身具有实际的业务意义。例如在更新数据库记录的接口中:
- 调用方不传该参数:代表“不修改该字段,保持原值”;
- 调用方显式传入 None:代表“将该数据库字段清空置为 NULL”。
此时,如果直接使用 val=None 作为默认值,函数内部将彻底无法区分用户究竟是“没传”还是“想清空”。解决该问题的经典工业模式是哨兵对象模式(Sentinel Pattern)。
# 1. 在模块级别创建一个唯一的私有哨兵对象
_UNSET = object()

# 2. 将默认参数绑定为该哨兵对象
def update_user_field(user_id, email=_UNSET):
    if email is _UNSET:
        return f"用户 {user_id}: email 保持原样,无需更新"
    if email is None:
        return f"用户 {user_id}: email 字段将被置为 NULL(清空)"
    return f"用户 {user_id}: email 更新为 {email}"

# 测试场景验证
print(update_user_field(101))                # 用户 101: email 保持原样,无需更新
print(update_user_field(101, email=None))   # 用户 101: email 字段将被置为 NULL(清空)
print(update_user_field(101, "new@qq.com")) # 用户 101: email 更新为 new@qq.com
通过 object() 实例化得到的独一无二的内存地址作为哨兵,既保留了默认参数的便利性,又赋予了代码精确辨别参数存在性的能力。
五、现代类型注解(Type Hints)规范
随着现代 Python(PEP 484 / PEP 604)对静态类型检查的普及,为带有 None 默认值的参数编写准确的类型注解已成为工程规范。
1. Python 3.10+ 标准写法(推荐)
自 Python 3.10 起,引入了管道符 | 联合类型语法,简洁直观:
# Python 3.10+ 推荐语法
def send_notification(
    title: str,
    content: str,
    cc_list: list[str] | None = None,
    priority: int | None = None
) -> bool:
    if cc_list is None:
        cc_list = []
    # 执行通知发送逻辑...
    return True
2. Python 3.5 - 3.9 兼容写法
在较低版本 Python 中,需要从 typing 模块导入 Optional 或 Union:
from typing import Optional, List

# Python 3.9 及以下兼容语法
def fetch_records(
    limit: int = 20,
    filters: Optional[List[str]] = None
) -> list:
    if filters is None:
        filters = []
    return []
Optional[T] 在 Python 类型系统中等价于 Union[T, None],它仅仅表示“这个变量的类型允许是 T 或者 None”,并不意味着该参数在调用时可以省略。只有显式添加了 = None 默认赋值表达式后,静态类型检查器(如 mypy、Pyright)和 IDE 才会允许调用方不传该参数。
六、总结与工程选型决策
为 Python 函数设置可选参数并在默认值中运用 None,是编写高质量、无状态污染和高容错代码的基石。在具体开发中,可以依照以下决策路径选择最合适的参数设计方式。
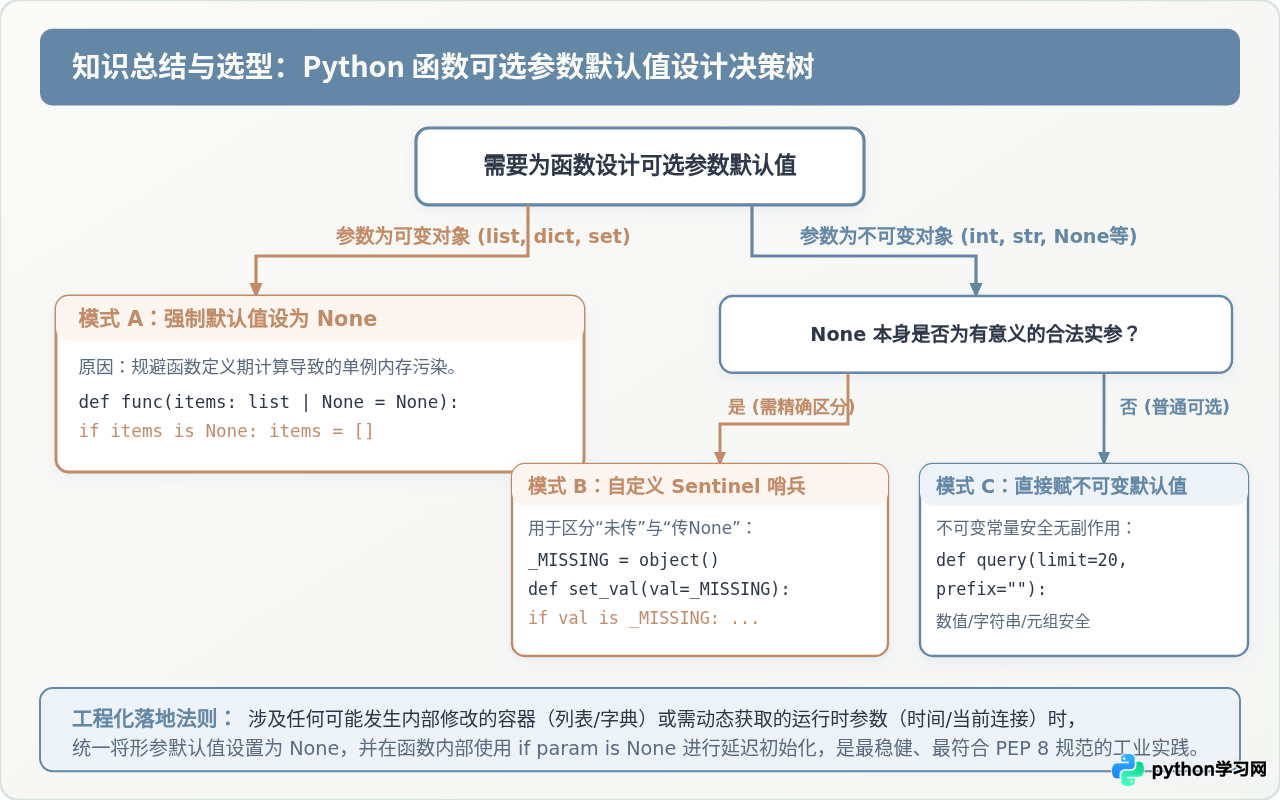
代码自查清单(Checklist)
- 位置正确:所有带默认值的参数是否都排在无默认值的必选参数之后?
- 拒绝可变默认:形参默认值列表中是否存在
[]、{}或自定义可变实例?(如有,必须立即重构成= None)。 - 判空精确:函数体内部检查是否严格使用了
is None,而非存在误判隐患的if not arg? - 类型匹配:使用类型标注时,是否包含了
| None或Optional[...]? - 边界识别:若
None属于合法的业务输入,是否已使用object()哨兵机制完成精确分流?
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















