


Python requests上传文件时怎么自定义文件名和Content-Type
全面讲解在Python中使用requests库上传文件时自定义文件名与Content-Type的规范方法,深入剖析元组参数结构、内存流上传、多文件处理及边界错误排查。
requests.post() 上传文件时,自定义文件名与 Content-Type 的标准解法是将 files 字典的值配置为三元组 (filename, file_object, content_type)。通过该格式,无论本地文件实际命名为何、或是直接从内存二进制流(如 io.BytesIO)上传,均可精确控制 HTTP 请求分段头部中的 filename 声明和 Content-Type 媒体类型,避免服务端因校验缺失或格式推断错误而抛出 400 与 415 异常。
一、核心场景与直接解法
在日常与第三方开放接口对接时,经常会遇到以下两类典型诉求:
- 本地文件与传输名称解耦:本地磁盘上的临时文件名为
tmp_upload_9812.dat,但接口强制要求文件名为billing_report_2026.csv。 - 服务端存在严格的 MIME 校验:上传
.json或.png文件时,若由 requests 自动根据文件后缀猜测,有时会退化为默认的application/octet-stream,导致服务端直接判定“不支持的文件格式”并拒绝处理。 - 内存数据直接传输:文件生成在内存中(例如动态导出的 Excel 字节或图像裁剪后的缓冲数据),没有本地真实路径,必须手动为虚拟文件指定名称及对应的媒体类型。
针对以上需求,最简洁且合规的代码实现如下:
import requests

url = "https://api.example.com/v1/files/upload"

# 使用三元组:('自定义文件名', 文件对象/字节流, '自定义Content-Type')
with open("local_cache.tmp", "rb") as f:
    files = {
        "file": ("quarterly_report.pdf", f, "application/pdf")
    }
    response = requests.post(url, files=files)

print("上传状态码:", response.status_code)
通过这行元组定义,requests 在底层拼装 HTTP multipart/form-data 报文时,便会严格按照指定的参数填充各段协议头,而不会受本地文件后缀或文件名的干扰。
二、底层机制:HTTP Multipart 报文与 requests 参数映射
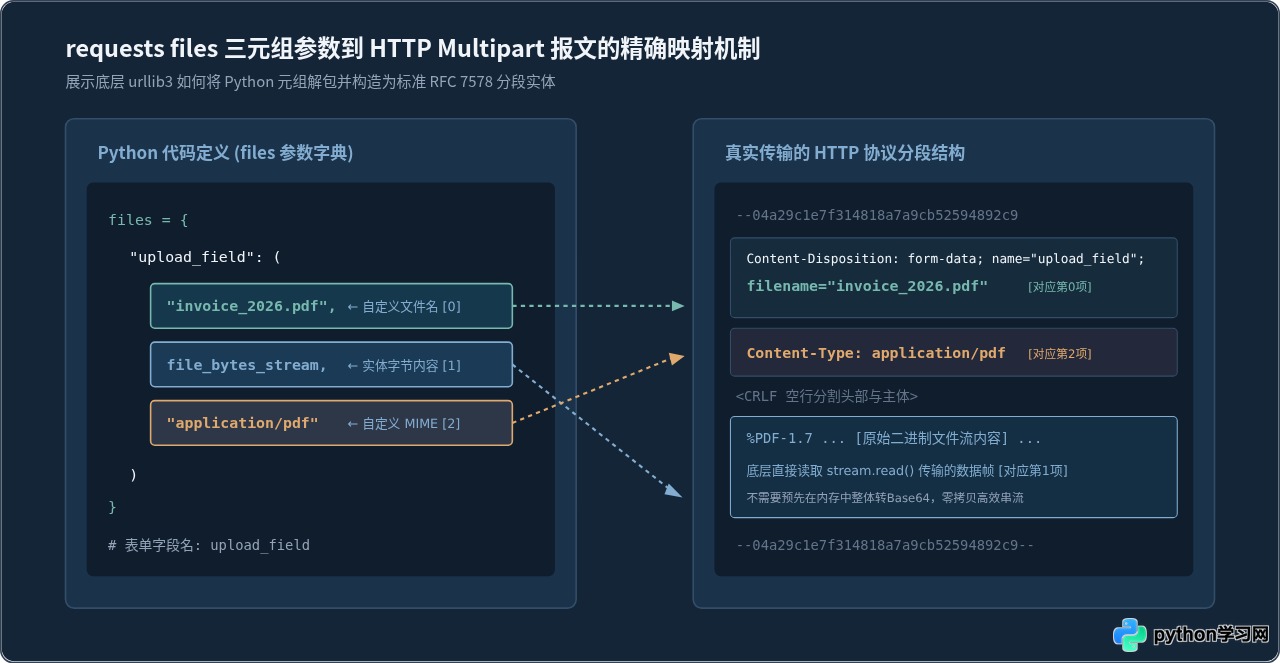
为了理解为什么三元组能精确生效,我们需要看一下 HTTP 协议中的 multipart/form-data 是如何工作的。常规的文件上传请求并非一个单纯的字节体,而是由一个唯一的随机边界串(Boundary)将整个请求体切分为若干个相互独立的实体分段(Part)。
每个实体分段自身都拥有小型的协议头,其中最关键的两个便是:
Content-Disposition:指定分段的表单字段名(name)以及对服务端公开的文件名(filename)。Content-Type:指定该分段二进制内容的真实媒体类型(MIME Type)。
当我们传入三元组时,requests 底层依赖的 urllib3 模块会分别读取三元组中的第 0 项、第 1 项和第 2 项,并精准填入对应的分段协议位置。下图详细展示了代码入参到最终 HTTP 传输报文的映射关系:
三、参数形态全景:从简易值到四元组
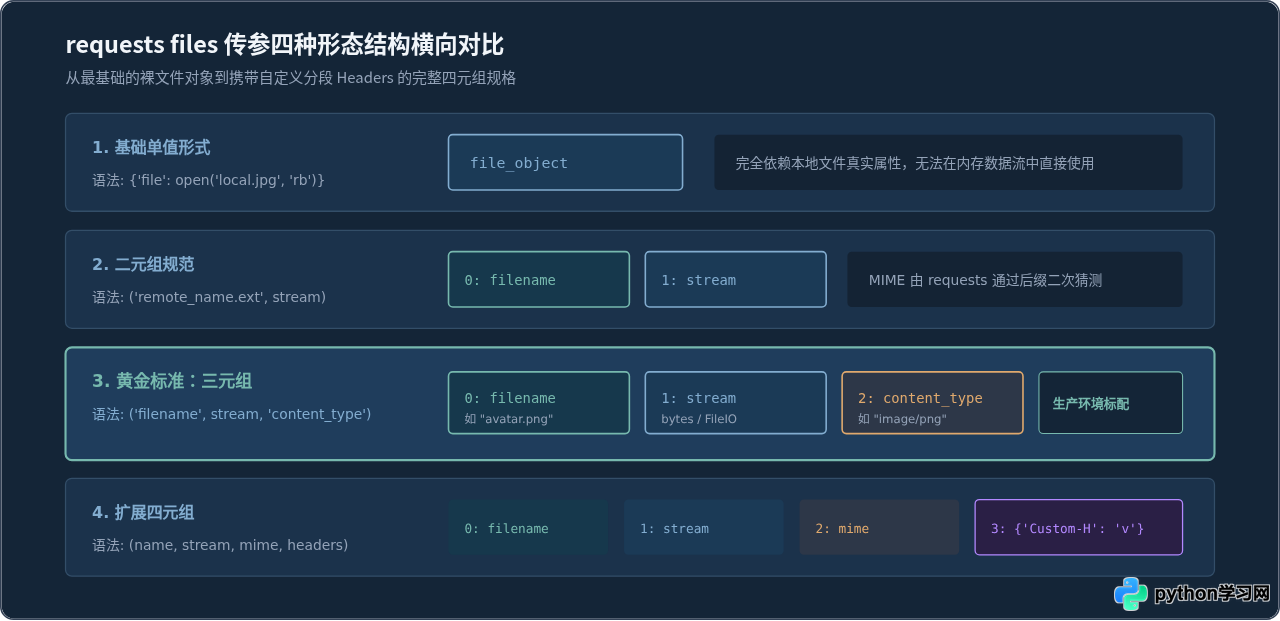
requests.post 的 files 字典拥有极其灵活的传参规范。了解不同维度的元组支持,可以帮助我们在面对复杂接口时选择最精简稳健的写法:
| 配置形式 | 元组结构 | 文件名行为 | Content-Type 行为 | 典型适用场景 |
|---|---|---|---|---|
| 单对象 | file_object |
自动读取 getattr(f, 'name') |
根据文件名后缀猜测,猜不出默认为 octet-stream | 快速调试、对文件名与MIME无严格要求 |
| 二元组 | (name, stream) |
强制使用指定名称 | 根据指定名称的后缀猜测 | 需重命名但 MIME 属于标准常见后缀 |
| 三元组 | (name, stream, mime) |
强制使用指定名称 | 强制使用指定 MIME | 生产环境推荐:严格校验与内存流传输 |
| 四元组 | (name, stream, mime, headers) |
强制使用指定名称 | 强制使用指定 MIME | 分段需携带自定义头(如 Content-Transfer-Encoding) |
四、标准化实现流程与多源上传代码
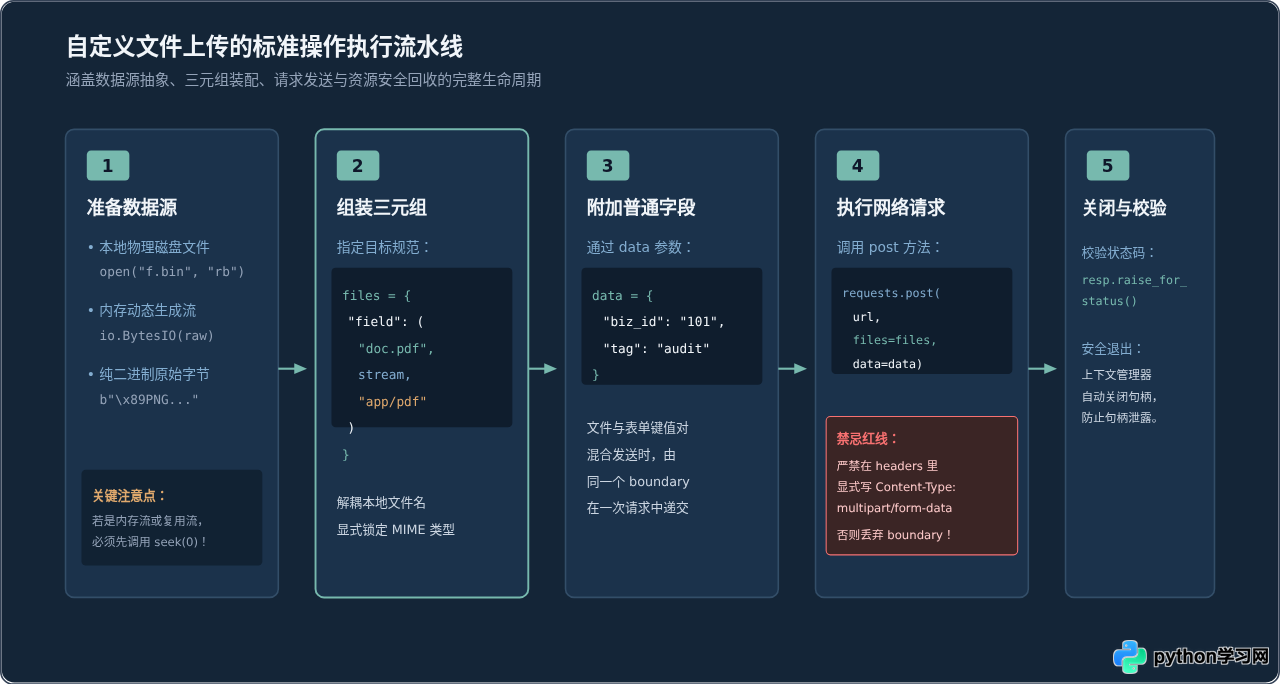
为了让上传逻辑具备极高的健壮性,我们可以把整个操作拆分为清晰的标准化流水线:从输入源准备、构建三元组包装器、附加同表单业务参数、直到发起请求与回收句柄。
1. 内存流(io.BytesIO)自定义上传代码
在图像处理(如 PIL 生成)、报表生成(如 openpyxl 或 pandas 写入缓冲)场景中,直接将数据保存在内存中上传,能极大提升 I/O 效率并降低临时文件残留风险:
import io
import requests

# 模拟在内存中生成一份 CSV 报表二进制数据
csv_content = "user_id,amount,timestamp\n1001,89.50,2026-10-17\n1002,120.00,2026-10-17\n"
memory_file = io.BytesIO(csv_content.encode("utf-8"))

# 关键:确保流指针归零,否则 requests 读取到的将是空数据
memory_file.seek(0)

target_url = "https://api.example.com/v1/reports/upload"

files = {
    # 参数映射:字段名 -> (指定接收文件名, 内存流对象, 指定MIME类型)
    "report_file": ("daily_metrics_20261017.csv", memory_file, "text/csv")
}

data = {
    "system_source": "billing_cron_job",
    "dry_run": "false"
}

response = requests.post(target_url, files=files, data=data)
print("服务端响应内容:", response.json())
2. 同一个接口上传多个文件并分别定制
当一个表单需要同时上传多份不同用途的文件时,files 字典可以声明多个键,或者同一个键挂载由三元组组成的列表:
import requests

url = "https://api.example.com/v1/identity/verify"

with open("scan_front.png", "rb") as front_file, open("scan_back.jpg", "rb") as back_file:
    # 场景 A: 不同字段名对应不同的定制文件
    files = {
        "id_card_front": ("national_id_front.png", front_file, "image/png"),
        "id_card_back": ("national_id_back.jpg", back_file, "image/jpeg")
    }

    # 场景 B: 服务端要求同一个字段名(如 'attachments')接收多个文件
    # files = [
    #     ("attachments", ("doc1.pdf", open("d1.pdf", "rb"), "application/pdf")),
    #     ("attachments", ("doc2.pdf", open("d2.pdf", "rb"), "application/pdf"))
    # ]

    response = requests.post(url, files=files)
    print("上传完成:", response.status_code)
五、深度排查与高频避坑指南
在自定义文件名与 Content-Type 的实践中,开发者最容易遇到三类隐蔽错误。了解这些现象的起因,能帮助我们在数秒内定位问题根源:
初学者极易犯的典型错误是:既然是上传表单,就在 headers={'Content-Type': 'multipart/form-data'} 中手动定义。这一行为会立刻导致上传彻底失败!
原因在于:标准的 multipart 请求必须携带用于分段的随机边界参数,例如 Content-Type: multipart/form-data; boundary=358b1d42a9ec...。一旦你在外部字典强行指定了无 boundary 的 multipart/form-data,便会覆盖 requests 自动生成的动态头部,服务端因找不到 boundary 无法解析请求体,必然返回 400 Bad Request。
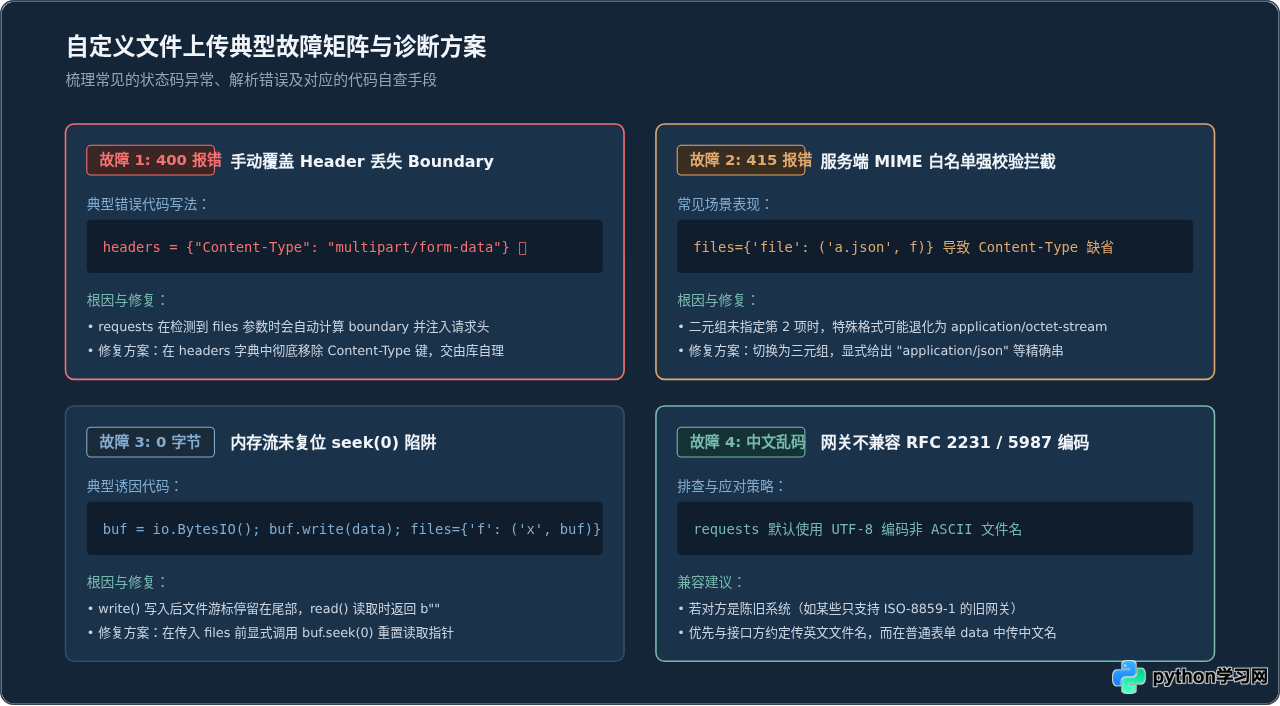
中文文件名编码的特别说明
在较新版本的 urllib3 中,如果元组的第 0 项传入包含中文字符的字符串(如 ("测试报告.xlsx", stream, "...")),系统会自动按照国际标准进行编码声明。
然而在实际工程中,许多遗留服务端架构的网关(如较老版本的 Java Servlet 容器或未正确配置字符集的 Nginx)可能在解析 filename*="UTF-8''..." 时出现中文被截断或乱码的问题。如果遇到此类对接障碍,最稳妥的工程实践是:
- 三元组的文件名使用唯一的英文安全标识符(例如
upload_uuid.xlsx); - 在
data={"original_name": "财务年度报告.xlsx"}中携带原始中文全称,由服务端业务层完成重命名与记录。
六、全文核心总结与备忘清单
在 Python requests 文件上传中,自定义文件名和 Content-Type 的核心心智模型非常明确:
- 核心语法:始终采用
files={'field_name': ('custom_name.ext', file_obj_or_bytes, 'mime/type')}的三元组结构。 - MIME 自定义:三元组的第 2 项(Content-Type)会原封不动地输出到 HTTP 分段的
Content-Type头中,有效绕过 requests 的默认后缀猜测。 - 内存流上传:利用
io.BytesIO搭配三元组,可以彻底告别在服务器磁盘生成临时文件的操作,但切记在上传前执行seek(0)。 - 协议头管理:只在
headers中设置鉴权 Token、User-Agent 等业务头,严禁手动写入Content-Type: multipart/form-data,确保 boundary 的自动计算不受破坏。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















