


免费开源教程 vs 付费Python书籍:初学者该怎么选择?
深入对比免费开源教程与付费Python书籍在知识结构、时效性、排错成本及学习反馈等维度的关键差异,为零基础初学者提供明确、可执行的选型判断逻辑与双轨学习方案。
初学 Python 时,资源形式的选择并不存在绝对的高下之分,核心取决于你当下的学习目标与认知承载力。免费开源教程胜在零启动门槛、版本时效极高,并且能快速满足“跑通第一行代码”与“排查具体报错”的即时反馈需求;而经过正规出版审校的付费书籍,则在概念推导的严密性、前后知识的连续性以及工程思维的建立上具备不可替代的结构优势。对于绝大多数初学者,最理性的方案并非孤立地二选一,而是看清两者的核心差异,在不同的学习阶段匹配恰当的媒介。
一、核心维度剖析:信息结构与反馈周期的本质差异
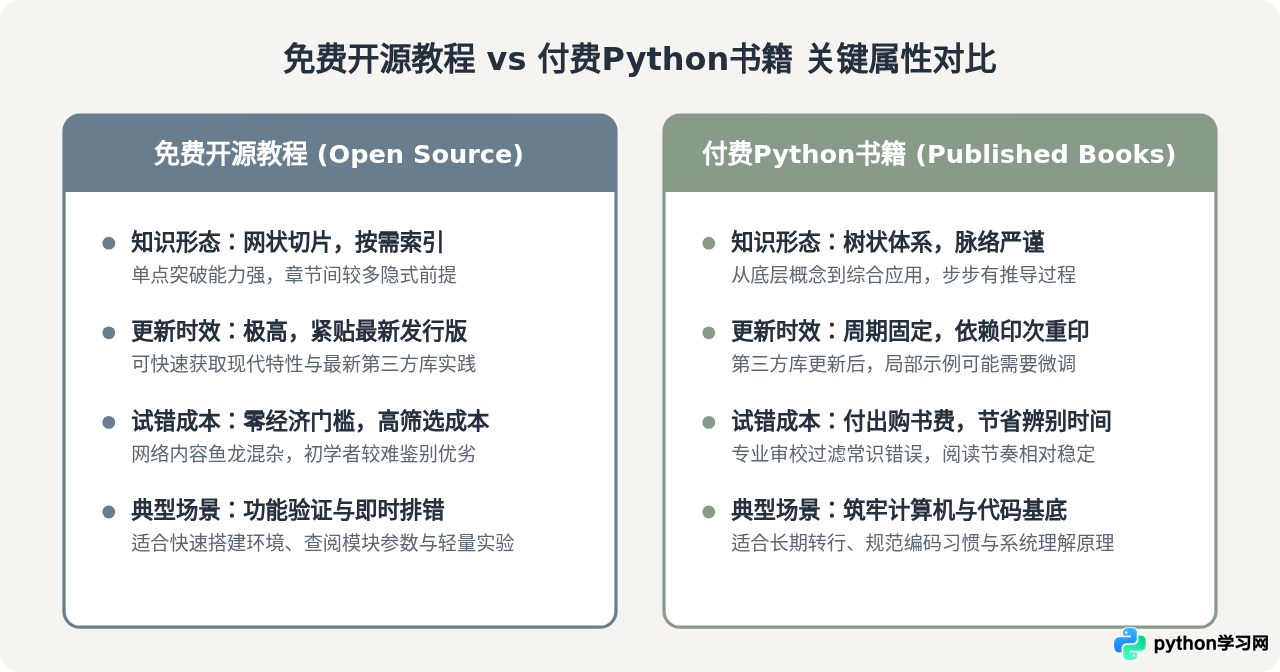
免费开源项目(如 GitHub 上的知识库、开源文档或个人博主整理的教程)与出版社发行的体系化技术书籍,在底层设计目的上存在根本区别。理解这些区别,有助于建立合理的学习预期,避免因选错材料而产生挫败感。
首先是知识的组织密度与连贯性。一本书籍在立项到出版的流程中,作者必须按照“由浅入深、前置铺垫、后置印证”的递进逻辑组织章节,每一章所用的变量、语法和设计范式都有严格的统一标准。而开源教程多由单篇或若干主题拼合而成,往往默认读者具备某种未明说的环境前提,章节之间容易出现概念断层。
其次是时效性与生态同步度。Python 语言及其生态(如包管理工具 uv、标准库模块变化、类型注解支持)迭代活跃。开源教程与官方文档几乎能够与 Python 最新版本保持同步,示例可以直接反映现代主流写法;而纸质书籍从完稿、三审三校到印刷发行至少经历半年到一年,书中涉及的第三方库安装命令或个别 API 可能已发生变更。
二、免费开源教程的优势、边界与适用场景
免费开源教程涵盖官方文档的入门指南(如 Python Tutorial)、社区贡献的交互式教学仓库(如 GitHub 上的各类 100-Days 项目)以及高质量个人技术博客。
1. 为什么它适合快速启动?
首先是操作链路短。很多开源教程配套了 Web 端交互运行环境(如基于 Pyodide 或 JupyterLite 的在线运行容器),初学者无需在个人电脑上折腾环境变量、PATH 路径或操作系统权限,点开网页就能运行 print("Hello, World!")。这种即时正向反馈能够有效降低前 24 小时的入门弃学率。
其次是针对具体问题的检索效率极高。当你遇到 ModuleNotFoundError: No module named 'requests' 这类错误时,书籍无法根据你的具体环境给出定制解答,而开源问答与教程社区能精准命中具体操作系统下的排查手段。
2. 免费教程的天然短板
- 隐式知识跳跃:作者常假设读者“已经装好 Git”“默认熟悉命令行基本操作”,导致没有 Linux/终端背景的初学者卡在第一步无法继续。
- 代码规范标准不一:不少个人整理的教程编写于早期版本,混杂了非 PEP 8 标准的命名习惯或已废弃的旧式语法(如遗留的
%字符串格式化而非现代f-string)。 - 收藏夹停滞效应:因为完全免费且易于获取,初学者极易囤积几十个开源仓库与书签,形成“已保存即已掌握”的认知幻觉,缺乏线性推进的纪律约束。
三、付费 Python 书籍的价值深度与常见盲区
优秀的付费书籍(如《Python编程:从入门到实践》等口碑入门专著)通常凝聚了资深教学者数年打磨的课程框架,并配有专业技术编辑与测试人员全量跑通代码示例。
1. 书籍的核心溢价在哪里?
书籍的核心价值不是“代码片段”,而是认知脚手架(Scaffolding)。好的作者清楚读者在学到第 4 章“列表切片”时容易出现什么索引越界疑问,在第 7 章“用户输入与 while 循环”时怎样过渡最平滑。它提供的是一条由浅入深的确定性路径,省去了读者在搜索引擎中反复横跳、拼凑信息的注意力损耗。
此外,书籍通常会贯穿一到两个完整的综合实战项目(例如一个完整的数据可视化工具或轻量 Web 应用),教读者如何组织多文件目录、编写模块化代码与处理常规配置,这是零散的网页教程难以承载的系统训练。
2. 付费书籍容易踩的坑
- 版本时差引发的环境阻滞:纸质书的代码如果使用的是特定历史版本的第三方库,在读者本地直接执行
pip install安装最新版时可能会报废弃警告或接口不兼容。如果读者完全不懂如何查看版本,容易陷入卡顿。 - “字典型”大部头带来的挫败:部分初学者盲目追求厚重权威的案头参考手册,这类书籍重在语法细节的穷尽罗列,并不适合从头按页精读,极易在前 100 页耗尽学习动力。
四、初学者该怎么选?四步评估决策流程
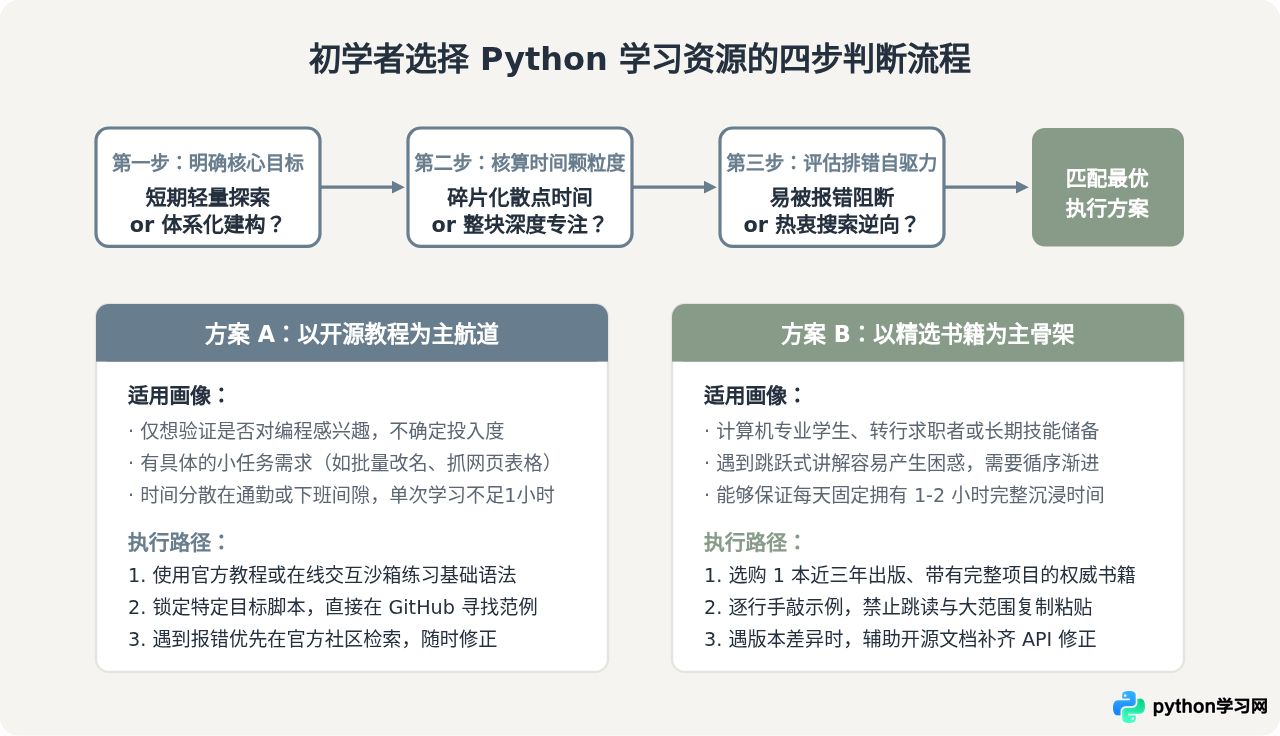
初学者可以根据“时间预算、目标诉求、排错自驱力、经济意愿”四个核心指标,快速确立自己应采取的主攻方向。
五、实操进阶:构建“主干+分支”的双轨学习模型
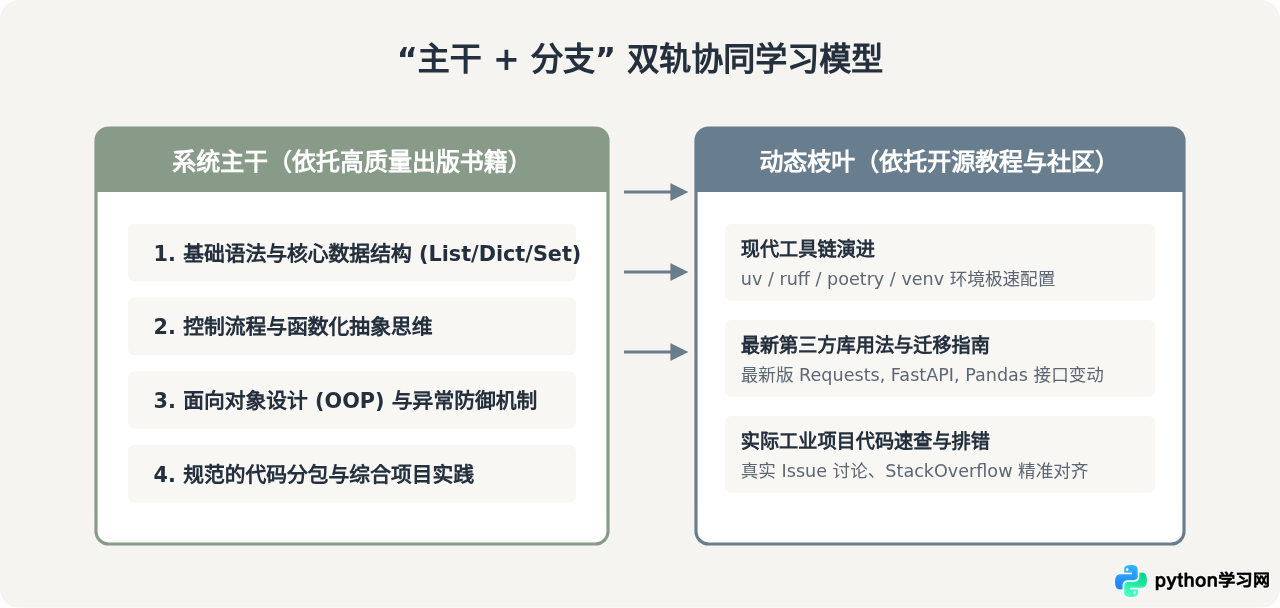
在实际学习中,将两者对立起来是初学者最常犯的错误。最省时、效果最扎实的做法是构建“以书籍为系统主干,以开源教程为动态枝叶”的双轨协同模型。
书籍负责搭好知识骨架:数据结构类型、控制流程、函数封装、作用域机制、类与对象设计。无论 Python 版本如何演进,这些语言核心机制在过去十几年中高度稳定,书籍在这部分能提供最耐心的推导和规范范式。
开源教程则负责解决生态分支与现实对接:现代包管理工具(如从 pip 到 uv 或 poetry 的演变)、最新第三方库接口、与操作系统环境的连接、以及开源社区的常用开发模版。遇到书中的某个第三方库方法被标记为 Deprecated 时,直接检索对应的官方开源文档,用最新的写法替换掉旧示例。
具体实操建议:双轨模式如何落地?
- 第 1 到 7 天:不必急于购书。直接选用一份口碑良好且支持在线执行的开源教程(或官方教程前 5 节),花 3 到 5 个小时动手把基础数据类型和简单函数敲一遍,验证自己对终端输出与逻辑控制是否具备兴趣。
- 第 2 周到第 6 周:选定一本口碑极佳的畅销基础书,将其列为核心教材。关掉冗杂的自媒体信息流,每天固定跟读一节并手敲所有案例代码。遇到书中过时的第三方库依赖,只针对该依赖搜索对应的 GitHub 官方 README 快速修正。
- 第 7 周及以后:脱离教材,进入以开源社区为主的“项目驱动期”。寻找感兴趣的 GitHub 开源小项目(如轻量爬虫、办公自动化脚本或简单的 RESTful API 服务),阅读他人的规范源码并根据需求做出修改。
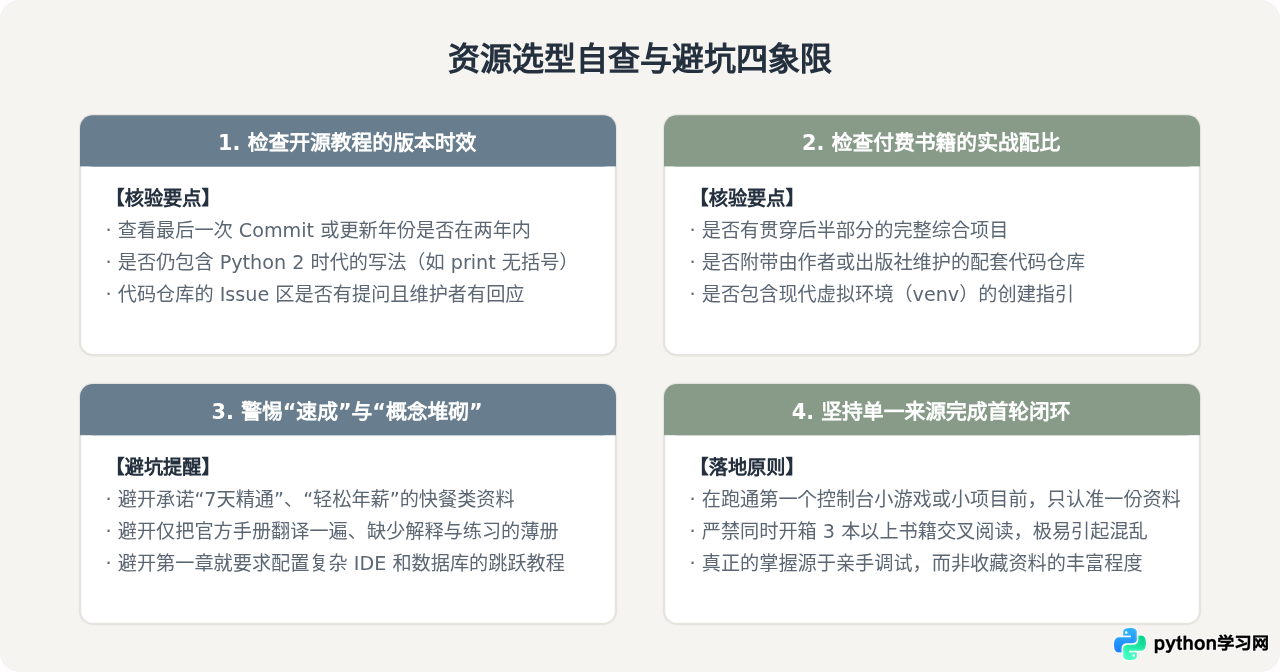
六、选型避坑指南:四项自查标准
在挑选具体教程或书籍时,初学者很容易陷入“看目录感觉很全就下单”或“看到热门推文就收藏”的误区。以下四条检查标准可以帮你快速过滤低质资源:
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















