


Python字符串处理入门:切片与格式化的3个简单例题
面向Python初学者的字符串处理入门指南,通过切片与f-string格式化的核心语法解析及3个实用例题,帮助读者快速掌握字符串提取、对齐与规整技巧。
一、字符串切片的核心机制与坐标理解
Python中的字符串是一个有序的字符序列。所谓“切片”,就是通过指定起始位置、结束位置以及步长,从原始字符串中提取出指定的连续或间隔子串。其通用语法形式为:string[start:stop:step]。
理解切片最容易踩坑的地方在于区间边界。Python切片严格遵守左闭右开原则:包含 start 对应的字符,但不包含 stop 对应的字符。换言之,实际提取的范围是 [start, stop)。此外,Python支持双向索引:从左向右计数从 0 开始累加;从右向左计数则从 -1 开始递减。
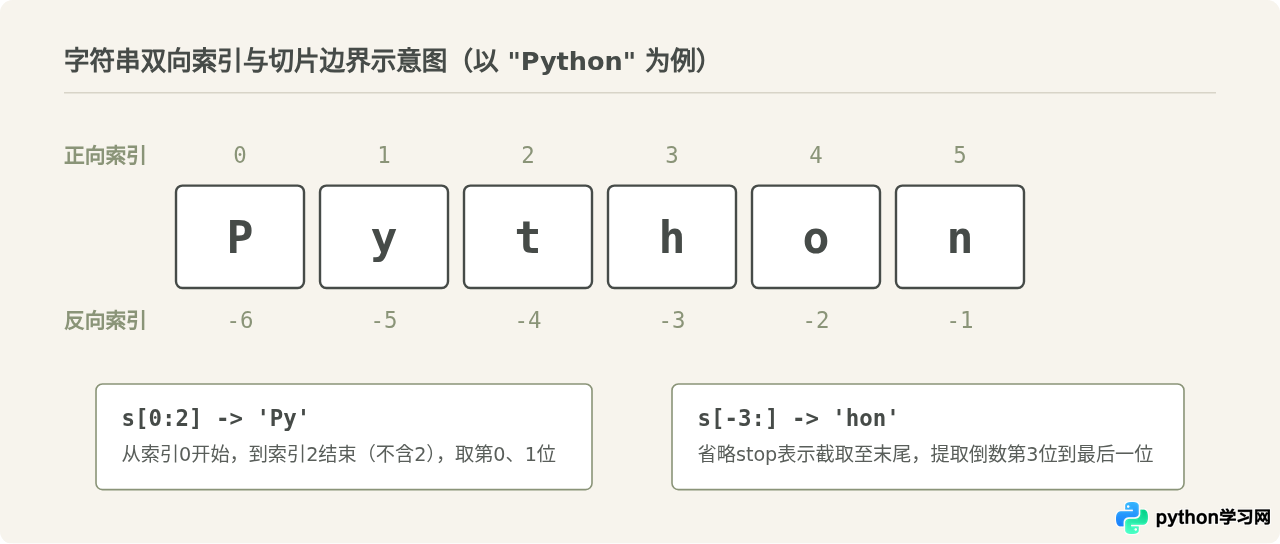
切片语法中还有三个关键默认值:当省略 start 时,默认从字符串头部(索引0)开始;当省略 stop 时,默认截取到字符串末尾;当省略 step 时,步长默认为 1。若将步长设为 -1,则表示从右向左反向提取。
二、f-string 字符串格式化的常用控制规则
Python 3.6引入的 f-string(格式化字符串字面值)是目前最推荐的格式化方式。只需在字符串前加前缀 f 或 F,并在花括号 {} 内填写变量或表达式即可。
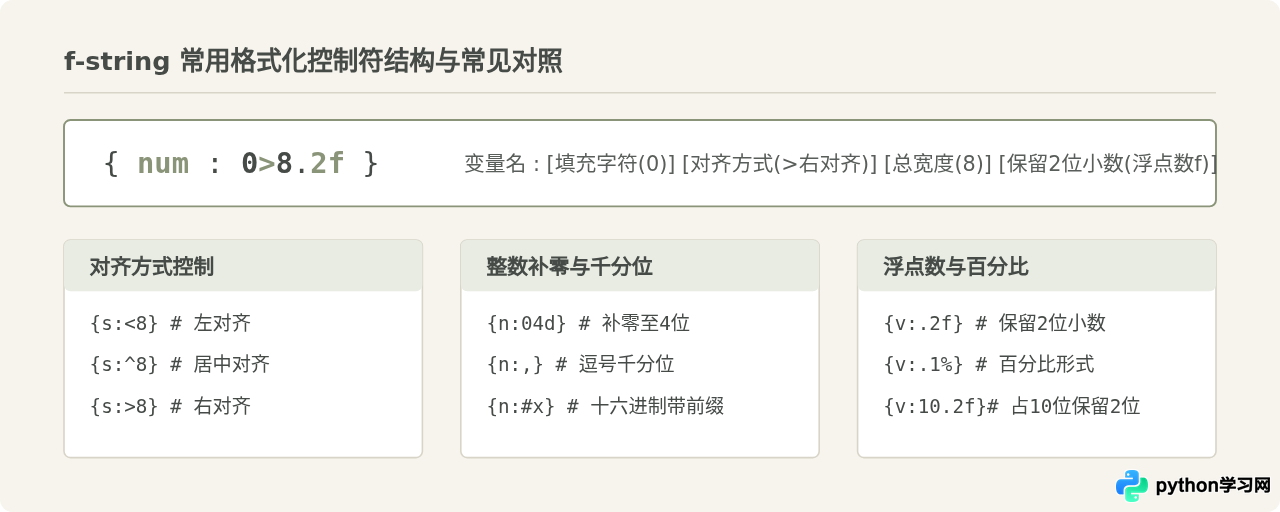
如果需要对显示样式进行精细化控制,可以在变量名后附加冒号 :,并书写格式控制说明符(Format Specifier),基本结构为:{变量:填充字符 对齐方式 宽度 精度 类型}。
三、3个简单例题解析与实操演练
为了让读者切实掌握切片与格式化的组合应用,下面精选3个开发中极高频出现的小场景进行演示。每个例题都包含明确的需求分析、完整代码与执行结果。
例题 1:固定编码解析与字符串反转
业务场景:系统中有一批规范格式的设备编号,格式固定为 DEV-20261017-X89。我们需要完成两项操作:
- 分别提取出设备前缀(DEV)、生产日期(20261017)以及批次码(X89);
- 对提取出的批次码进行反转,用于校验算法。
# 设备编号解析示例
code = "DEV-20261017-X89"

# 1. 利用切片提取指定位置字符
prefix = code[0:3]       # 从0到3(不含3)
date_str = code[4:12]    # 从4到12(包含8位日期数字)
batch = code[13:]        # 从13截取到末尾

# 2. 利用负步长 -1 进行字符串反转
reversed_batch = batch[::-1]

print(f"设备类型: {prefix}")
print(f"生产日期: {date_str}")
print(f"原始批次: {batch} -> 反转批次: {reversed_batch}")
设备类型: DEV
生产日期: 20261017
原始批次: X89 -> 反转批次: 98X
在上述代码中,code[13:] 巧妙省略了结束边界,这样即便批次号长度偶然发生变动(例如升级为4位),也能完整提取。而 batch[::-1] 是 Python 中反转字符串的经典惯用法,无需引入任何额外函数。
例题 2:对齐排版整齐的数据报表
业务场景:从字典列表中读取商品销售数据,由于品名长短不一、金额小数位数不同,如果直接用逗号或空格输出,控制台打印会犬牙交错。我们需要利用格式化输出工整对齐的表格。
# 销售数据对齐排版示例
products = [
    {"name": "笔记本", "price": 4999.0, "qty": 3},
    {"name": "人体工学无线鼠标", "price": 128.5, "qty": 12},
    {"name": "高清显示器", "price": 1299.99, "qty": 2},
]

# 打印表头:品名左对齐宽16,单价右对齐宽10,数量右对齐宽6,小计右对齐宽12
print(f"{'商品名称':<14} {'单价(元)':>10} {'数量':>6} {'小计(元)':>12}")
print("-" * 48)

for item in products:
    total = item["price"] * item["qty"]
    # 格式化每行:文字左对齐,金额保留2位小数并右对齐
    print(f"{item['name']:<14} {item['price']:>10.2f} {item['qty']:>6d} {total:>12.2f}")
商品名称             单价(元)   数量     小计(元)

------------------------------------------------

笔记本               4999.00      3     14997.00

人体工学无线鼠标       128.50     12      1542.00

高清显示器           1299.99      2      2599.98
通过指定 :>10.2f,不仅限制了输出为标准货币形式的两位小数,还预留了10个字符的总宽度,使数值右侧小数点整齐对齐。
例题 3:敏感信息脱敏与补零流水号生成
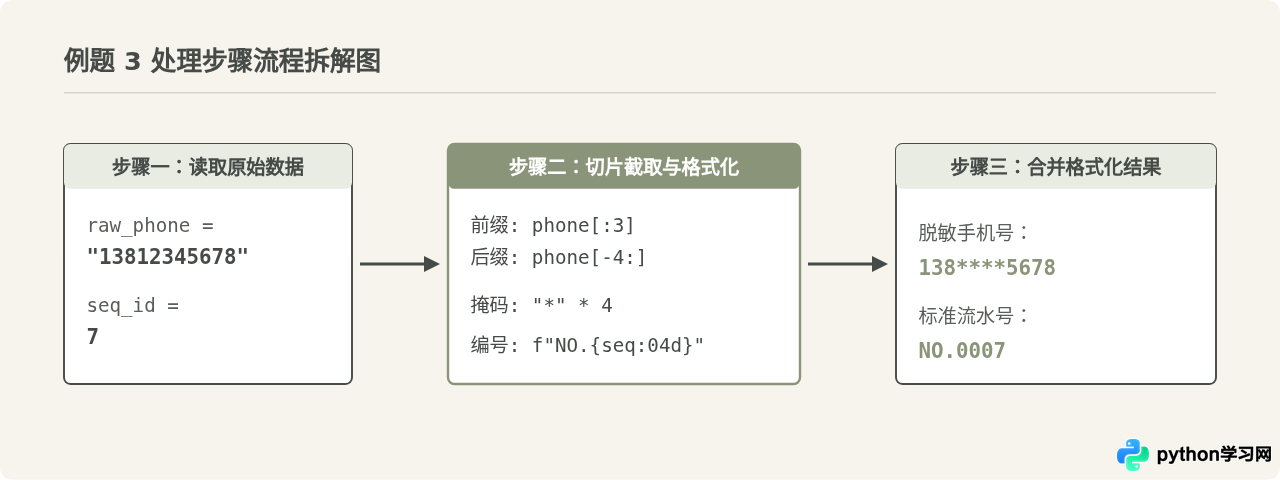
业务场景:在用户信息展示系统中,手机号需要保留前3位与后4位,中间4位使用星号隐藏;同时需要为每条记录附加一个固定4位长度的流水号(不足前面补零)。
# 敏感信息脱敏与补零示例
def mask_phone_and_format_seq(phone_number: str, seq: int) -> str:
    # 切片提取前3位与后4位,中间拼接4个星号
    masked_phone = f"{phone_number[:3]}****{phone_number[-4:]}"
    # 格式化流水号:4位宽度,不足左侧自动补零
    formatted_seq = f"NO.{seq:04d}"
    return f"{formatted_seq} | 用户手机: {masked_phone}"

# 测试数据
records = [
    ("13812345678", 1),
    ("15998765432", 28),
    ("18600001111", 305)
]

for phone, seq_num in records:
    print(mask_phone_and_format_seq(phone, seq_num))
NO.0001 | 用户手机: 138****5678
NO.0028 | 用户手机: 159****5432
NO.0305 | 用户手机: 186****1111
四、初学者容易混淆的关键认知辨析
这种推测表面看起来合乎直觉,但在Python中是不成立的。直接使用单索引访问字符(如 text[100])如果超出范围,会立刻引发 IndexError: string index out of range 异常;但切片操作(如 text[0:100])拥有天然的边界容错机制。如果切片范围超过了字符串最大长度,Python会自动截断在实际存在的字符边界,返回完整的有效子串而不报错。
初学者经常写出类似 s[1:5:-1] 这样的代码,结果发现返回的是空字符串 ""。原因在于:步长 step 决定了查找扫描的方向。当 step = -1 时,扫描方向是从右向左递减的,因此 start 的位置必须在 stop 的右侧(即 start > stop)。如果要倒序提取索引1到4的字符,应当写为 s[4:0:-1]。
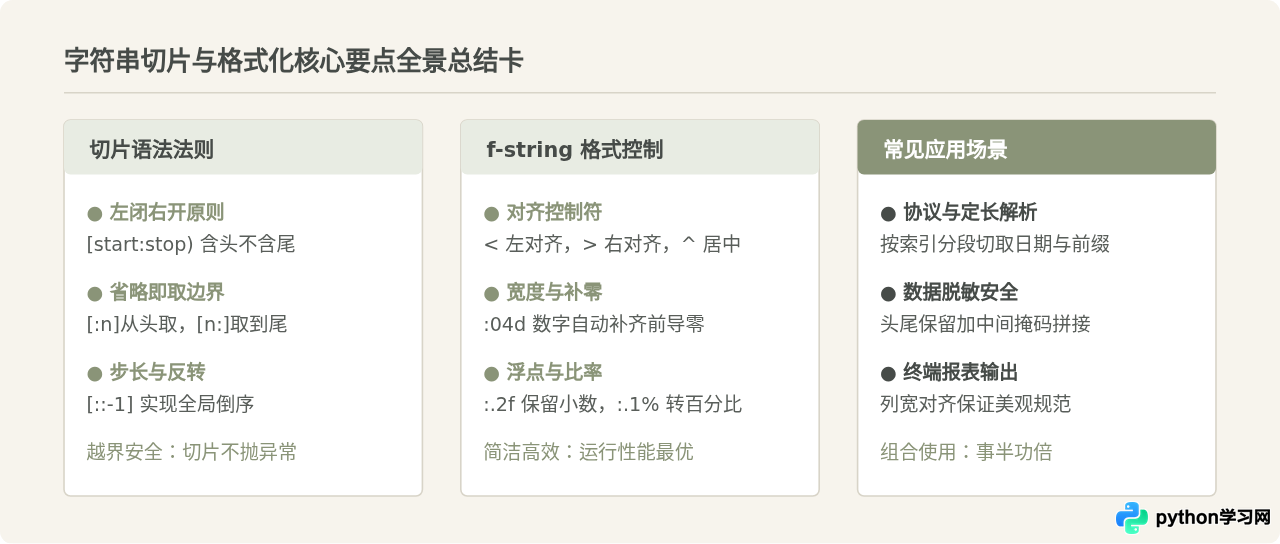
五、知识要点全景总结
Python 字符串处理之所以优雅高效,正是因为切片与 f-string 提供了简洁而强大的表达力。下表概括了本文的核心语法与关键实践要点。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















