


Python人工智能进阶选大模型还是计算机视觉?
针对Python开发者在人工智能进阶方向上的困惑,从硬件算力门槛、技术栈差异、落地场景与就业形态等多维度对比大语言模型与计算机视觉,提供清晰的选型决策树与实践验证路径。
一、技术栈与核心能力维度的全面对比
计算机视觉与大语言模型虽然同属深度学习分支,并在底层共享反向传播与张量计算的基本范式,但在数据表示形式、模型优化重心以及工程化交付路径上存在根本差异。理解这些差异是做出理性选择的第一步。
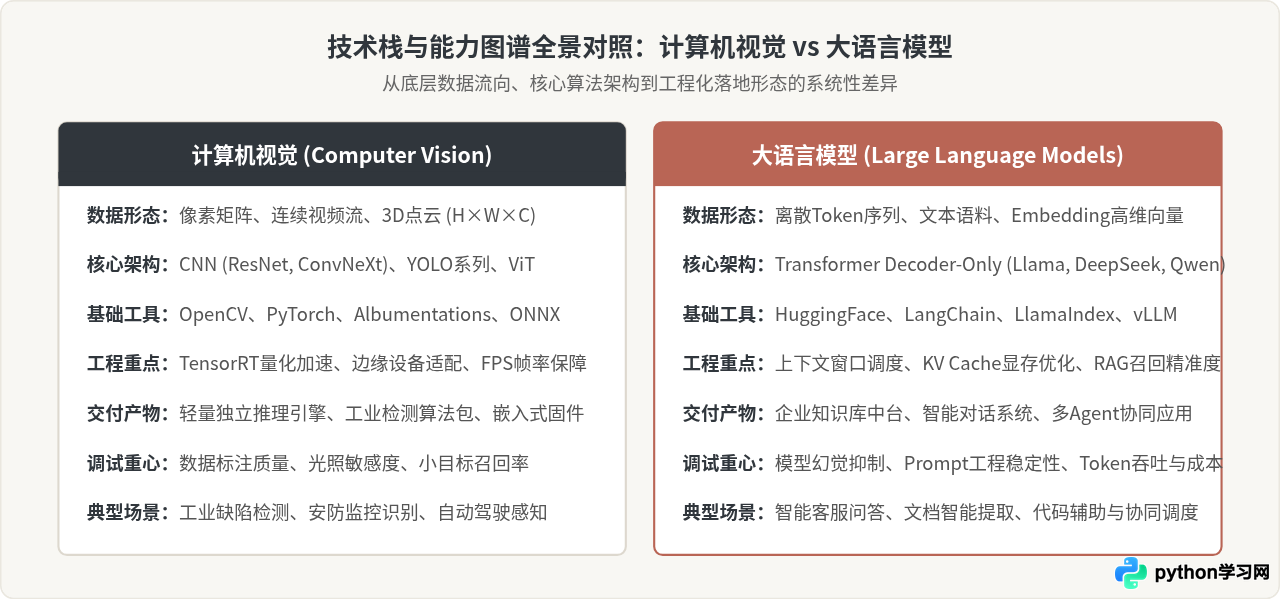
计算机视觉的核心处理对象是多维网格结构的数据(如高宽与通道组成的图像张量 H×W×C 或连续视频流)。其工程重点长期聚焦于如何在有限的计算资源下兼顾检测精度与高帧率(FPS)。开发者需要熟练掌握 OpenCV 图像预处理、Albumentations 数据增强、CNN(如 ResNet)与单阶段检测器(如 YOLO 系列)的调优,最终通过 TensorRT、ONNX Runtime 等工具将模型量化编译为能够在工控机或嵌入式板卡上平稳运行的固件。
大语言模型的核心处理对象则是离散的 Token 序列以及由嵌入层映射的高维语义向量。在工程实践中,大多数进阶开发者的工作并不涉及从零预训练基础模型,而是围绕预训练基座展开应用层构建。重点在于上下文窗口管理、检索增强生成(RAG)、Prompt 结构化约束、基于 LoRA/QLoRA 的参数高效微调,以及利用 vLLM 或 Ollama 实现高并发推理服务调度。
二、算力门槛与硬件成本的真实差距
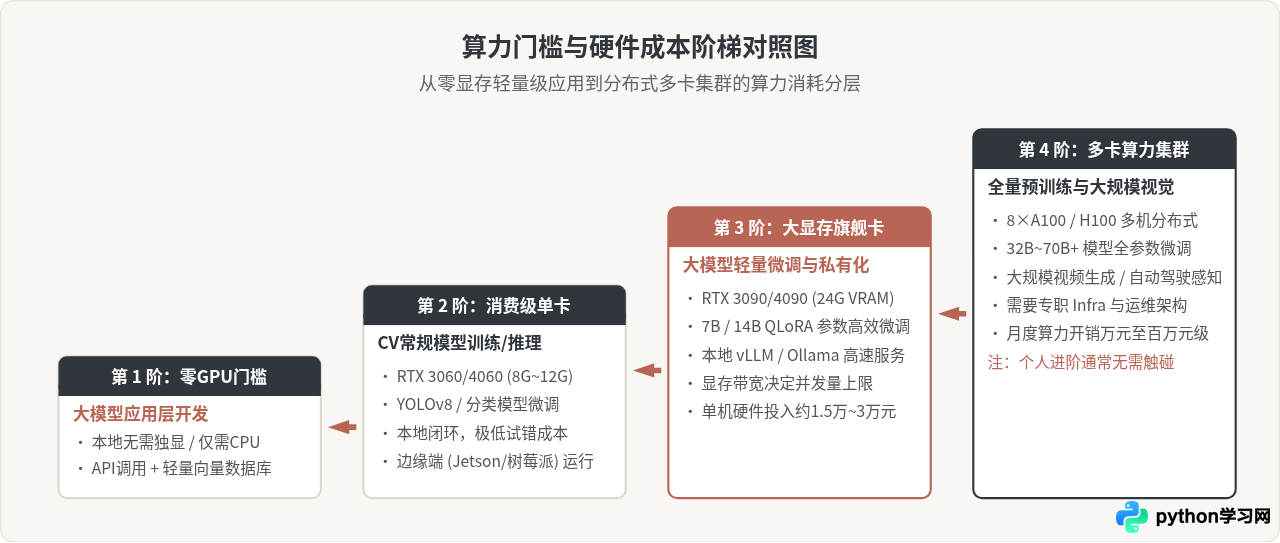
很多学习者在技术选型时常陷入“算力焦虑”。事实上,两个方向对硬件的要求并非绝对的高与低,而是呈现出不同的成本阶梯结构。
在计算机视觉领域,由于绝大多数落地场景都要求在边缘设备或工控机上运行,模型的轻量化研究已经非常成熟。例如,使用单张配置 8GB 显存的消费级显卡(如 RTX 3060 或 RTX 4060),就能轻松完成 YOLOv8 目标检测模型(Nano 或 Small 版本)从数据集标注、训练、验证到导出的全流程。而在纯推理阶段,借助 OpenVINO 或 ONNX Runtime,在普通的现代 x86 或 ARM CPU 上即可达到 30 FPS 以上的实时处理速度。
大语言模型则呈现出明显的两极分化。如果你专注于应用层开发(如构建基于外部 API 的企业知识库、客服问答或多智能体工作流),本地开发机器几乎不需要配备独立显卡,仅需按 Token 消耗付费即可开始构建复杂的业务系统。然而,如果你计划在本地进行开源大模型(如 7B 或 8B 参数级别)的私有化微调,即便采用 4-bit 量化的 QLoRA 技术,也至少需要 16GB 至 24GB 显存(如单张 RTX 3090 或 RTX 4090)。若涉及更大参数量模型(如 32B 或 70B)或全参数微调,则必须依赖企业级多卡集群(如 A100/H100),硬件门槛成倍攀升。
三、进阶选型的四步执行工作流
为了避免陷入无休止的概念对比与犹豫,建议按照以下四个标准化步骤,结合自身实际情况进行系统排查与验证:
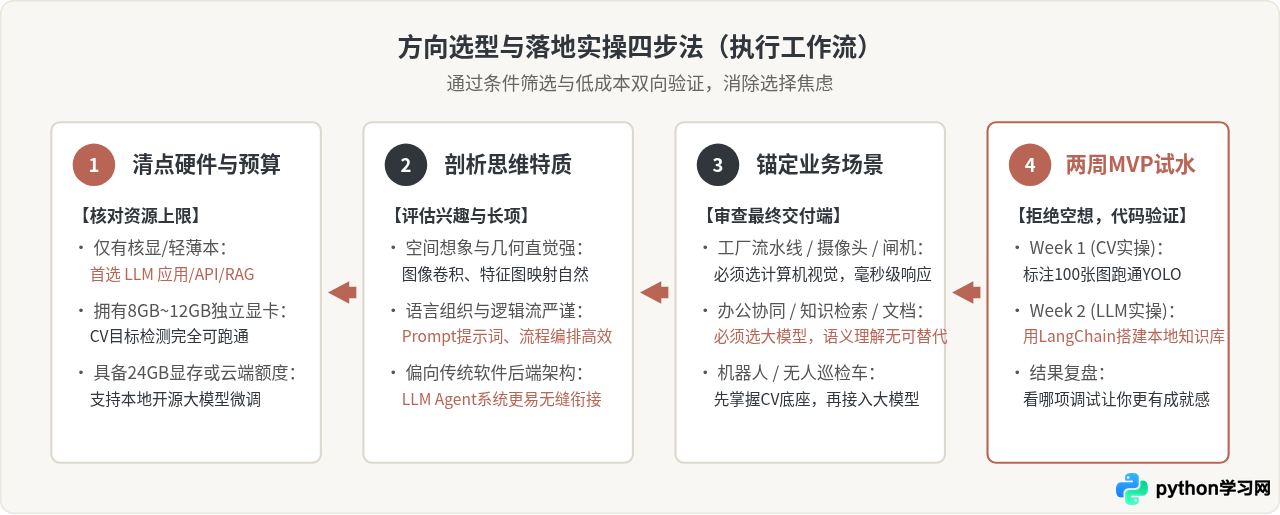
- 步骤一:清点硬件资产与预算投入。 检查当前主力开发机的显卡配置。如果只有轻薄笔记本或核显,强行在本地跑大模型微调或重型卷积训练会非常低效,此时应当优先选择基于 API 的大模型应用方向;若配有 RTX 3060 以上独显,则两个方向的本地学习环境均已就绪。
- 步骤二:评估个人思维偏好与知识底座。 计算机视觉高度依赖二维坐标变换、矩阵滤波、几何透视等具象数学思维;大语言模型则更考验文本信息抽取、上下文语义逻辑、正则解析与分布式系统调用能力。
- 步骤三:匹配你身处行业的最终交付形态。 如果你所在的行业或业务强依赖物理世界感知(如制造业外观品控、交通卡口车辆分析、智能零售客流统计),计算机视觉几乎是必选方向;如果是金融研报分析、法律合规审核、电商智能客服与协同办公软件,大模型能更直接地产生商业价值。
- 步骤四:执行为期两周的双向最小可行项目(MVP)实操。 用一周时间走通一个轻量级目标检测任务,再用一周时间搭建一个企业知识库问答 Demo。切身的编码、调参和报错排查体验,比任何理论分析都更具说服力。
四、双方向最小原型(MVP)验证代码示例
为了帮助读者直观感受两个方向在代码编写与调试过程中的差异,下面分别给出可在本地独立运行的最小验证代码。
1. 计算机视觉原型:基于 YOLOv8 的轻量目标检测推理
在终端中执行依赖安装:pip install ultralytics opencv-python。该示例演示了如何从加载模型、输入图像矩阵到解析空间包围框坐标的完整过程。
# cv_inference_demo.py
# 运行环境:Python 3.9+,已安装 ultralytics 与 opencv-python
import cv2
from ultralytics import YOLO

# 1. 载入官方轻量级预训练权重 (约 6MB,首次运行会自动从官方源拉取)
model = YOLO('yolov8n.pt')

# 2. 模拟或读取待检测图像
# 在实际项目中,可替换为 cv2.VideoCapture(0) 读取摄像头实时画面
image_path = 'sample.jpg'
image = cv2.imread(image_path)

if image is not None:
    # 3. 执行前向推理,设定置信度阈值
    results = model(image, conf=0.4)

    # 4. 解析目标类别、坐标与概率
    for r in results:
        boxes = r.boxes
        for box in boxes:
            cls_id = int(box.cls[0])
            label_name = model.names[cls_id]
            conf_val = float(box.conf[0])
            xyxy = box.xyxy[0].tolist()  # 像素级边界框 [xmin, ymin, xmax, ymax]
            print(f"识别目标: {label_name:<10} 置信度: {conf_val:.2f} 坐标: {xyxy}")
else:
    print("未能正确加载图像,请检查文件路径是否正确。")
CV 调试要点: 计算机视觉调试的核心难点往往不在于模型调用代码本身,而在于输入分辨率与网络步长匹配、不同光照条件下的数据分布漂移,以及后处理中非极大值抑制(NMS)阈值的微调。
2. 大语言模型原型:基于标准接口构建本地文档 RAG 问答
在终端中执行依赖安装:pip install openai。该示例使用标准的 OpenAI 协议格式,既可直接接入云端模型服务,也可以零代码修改直接连接本地通过 Ollama 或 vLLM 暴露的本地兼容端点(如 http://localhost:11434/v1)。
# llm_rag_demo.py
# 运行环境:Python 3.9+,已安装 openai
from openai import OpenAI

# 1. 初始化统一客户端对象
# 若使用本地开源模型,可将 base_url 改为 http://localhost:11434/v1,api_key 填任意字符
client = OpenAI(
    base_url="https://api.openai.com/v1",
    api_key="your-api-key-here"
)

# 2. 本地私有知识库文档片段集合
knowledge_chunks = [
    "退换货规范:购买之日起7个自然日内,商品包装完好可申请无理由退货。",
    "质保政策:主板与核心芯片享受三年免费官方保修,消耗品不在保修范围。",
    "发票开具:订单确认收货后48小时内,系统将自动向绑定邮箱发送电子增值税普通发票。"
]

def query_knowledge_base(question: str, docs: list[str]) -> str:
    # 3. 构造结构化系统提示词与检索上下文注入
    context_str = "\n".join([f"[{idx+1}] {item}" for idx, item in enumerate(docs)])
    system_prompt = (
        "你是一名严谨的售后客服助手。请仅根据下列参考资料回答用户问题。"
        "如果资料中未提及相关信息,请明确回答'根据现有资料无法确认',切勿编造虚假条款。\n"
        f"参考资料:\n{context_str}"
    )

    # 4. 发起带有结构约束的对话调用
    response = client.chat.completions.create(
        model="gpt-3.5-turbo",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": question}
        ],
        temperature=0.1  # 调低随机度以保证回答稳定性
    )
    return response.choices[0].message.content

# 5. 执行测试问答
user_q = "我在第5天想要退货,请问符合政策吗?发票什么时候能收到?"
print("助手回复:\n", query_knowledge_base(user_q, knowledge_chunks))
LLM 调试要点: 大模型工程的调试核心在于系统提示词对模型输出格式与边界的约束、长文本检索切分(Chunking)的粒度平衡,以及如何通过元数据过滤和重排序(Rerank)降低幻觉率。
五、选型总结与未来多模态融合趋势
不可忽视的是,计算机视觉与大语言模型并不是非此即彼的对立关系。随着视觉语言大模型(VLM,如 CLIP、Qwen2-VL、GPT-4o)的快速演进,两者的边界正在加速重叠。例如,在自动驾驶系统、具身智能(Embodied AI)机器人以及多模态视频内容理解中,系统往往需要同时具备底层的视觉空间感知能力和顶层的大模型逻辑规划能力。
然而对于个人技术进阶而言,同时铺开两个庞大领域往往会导致精力分散、浅尝辄止。最稳妥的策略是:根据当前手头最具确定性的项目需求确定“主攻锚点”,将另一个方向作为“协同辅助”。下面的四象限决策矩阵概括了不同业务与算力约束下的推荐选择:
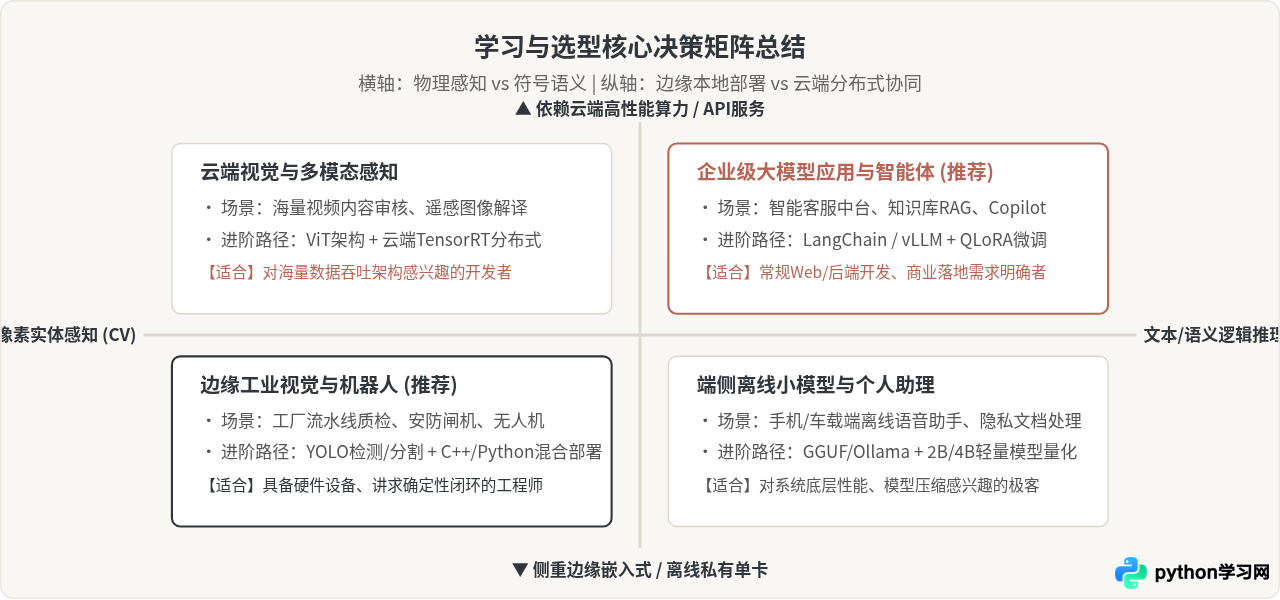
综上所述,技术进阶的核心不在于盲目追赶最新的技术名词,而在于让技术能力与具体的工程交付场景紧密挂钩。从硬件成本、业务痛点和个人思维习惯出发,通过两周的最小可行项目验证,你将自然找到最契合自己的 Python 人工智能进阶之路。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















