


面试问matplotlib和seaborn该怎么分工怎么答?
针对Python数据分析与数据科学技术面试中常见的Matplotlib与Seaborn分工问题,从底层架构共生关系、项目工作流分工、工业级协同代码模板到高频追问防踩坑要点进行系统化解答。
一、面试官到底在考什么?明确答题重心
当面试官提出“Matplotlib 和 Seaborn 该怎么分工”时,通常并非单纯考察记忆几个绘图函数的名称,而是在探查以下三项核心能力:
- 技术栈层级认知:候选人是否清楚 Seaborn 的底层就是 Matplotlib,能否意识到两者并非互斥关系;
- 项目生命周期意识:在不同开发阶段(数据探索 vs 业务汇报)是否具备合理的工具选型与效率权衡意识;
- 底层微调能力:当高阶库无法满足像素级报表定制要求时,候选人是否具备穿透到底层 API 解决问题的实操经验。
如果直接回答“Seaborn 更好看,所以平时全用 Seaborn”,很容易被判定为只停留在新手调包阶段;若回答“Matplotlib 功能全,所以只用 Matplotlib”,又暴露了开发效率低下、忽视现代数据科学工具链的问题。
二、底层机制与架构差异:基石与高阶封装
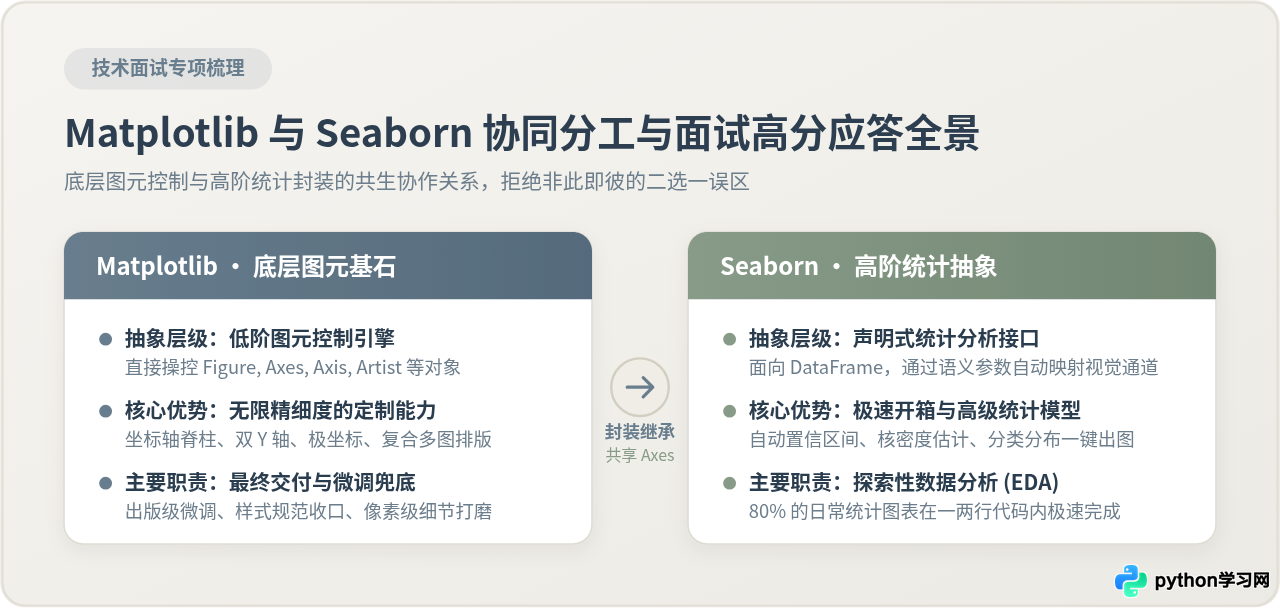
理解两者的分工,必须先厘清它们在 Python 数据可视化生态中的调用链条。Matplotlib 是一个完备的二维绘图引擎,其核心由画板(Figure)、坐标系(Axes)、坐标轴(Axis)和具体图元(Artists,如折线、矩形、文字)构成;它遵循类似画布图层的命令式或面向对象绘制逻辑。
Seaborn 并不是从零编写渲染引擎,而是专门针对统计分析场景在 Matplotlib 上搭建的高阶声明式接口。它深度整合了 Pandas DataFrame 与 Scipy 统计模型,允许开发者通过语义字段直接映射视觉属性。
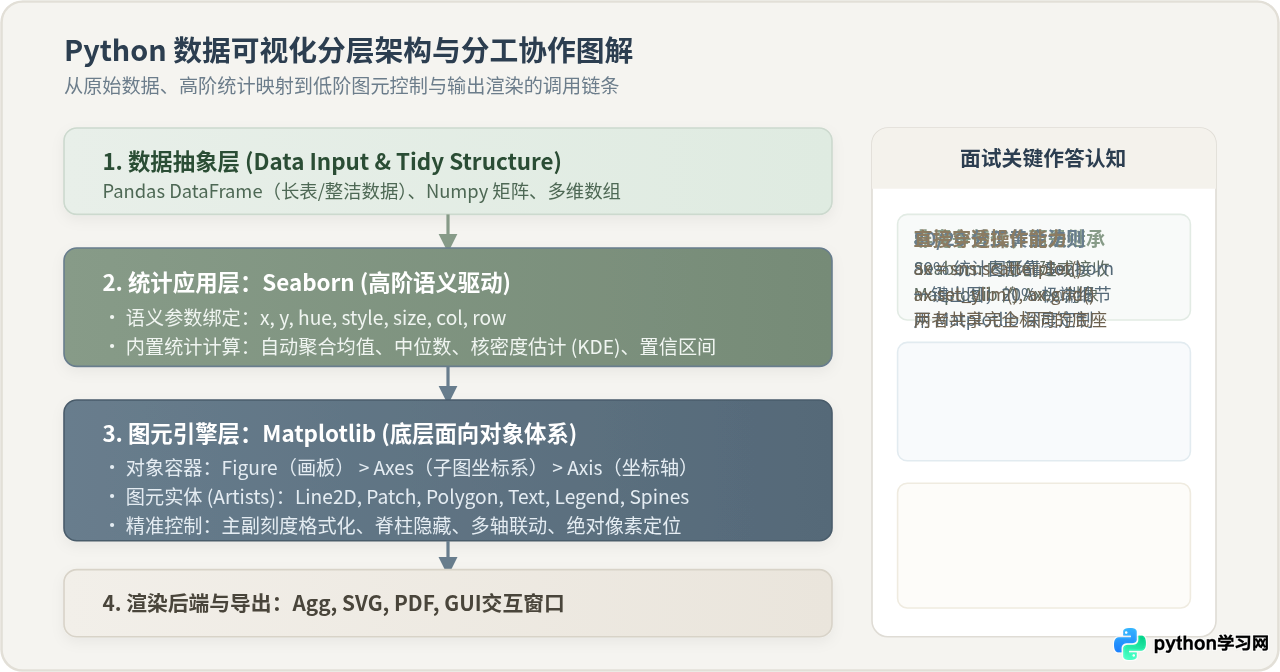
在相同的数据分析任务下,两者的核心差异集中体现在以下三个维度:
| 对比维度 | Matplotlib | Seaborn |
|---|---|---|
| 数据抽象层级 | 面向标量数组(Numpy 数组、List),需手动计算均值、聚合指标与误差棒 | 面向整洁数据(Tidy DataFrame),传入列名即可自动完成分组与统计估算 |
| 代码与开发成本 | 多变量分组需手写 for 循环拆分数据并手动管理图例标签 |
声明 hue、style、col 即可一行代码完成维度拆解 |
| 图元控制精细度 | 掌控全部图元生命周期(主副刻度格式化、脊柱隐藏、复合几何绘制) | 封装了常见统计图表形态,极端边缘排版需求需回退到底层对象 |
三、现场作答“三步推进法”:逻辑推导与话术展开
在面试现场,建议采用由浅入深、层层递进的“三步推进法”组织答案。这样既能给出干脆明确的定性,又能展现从分析到工程落地的纵深。
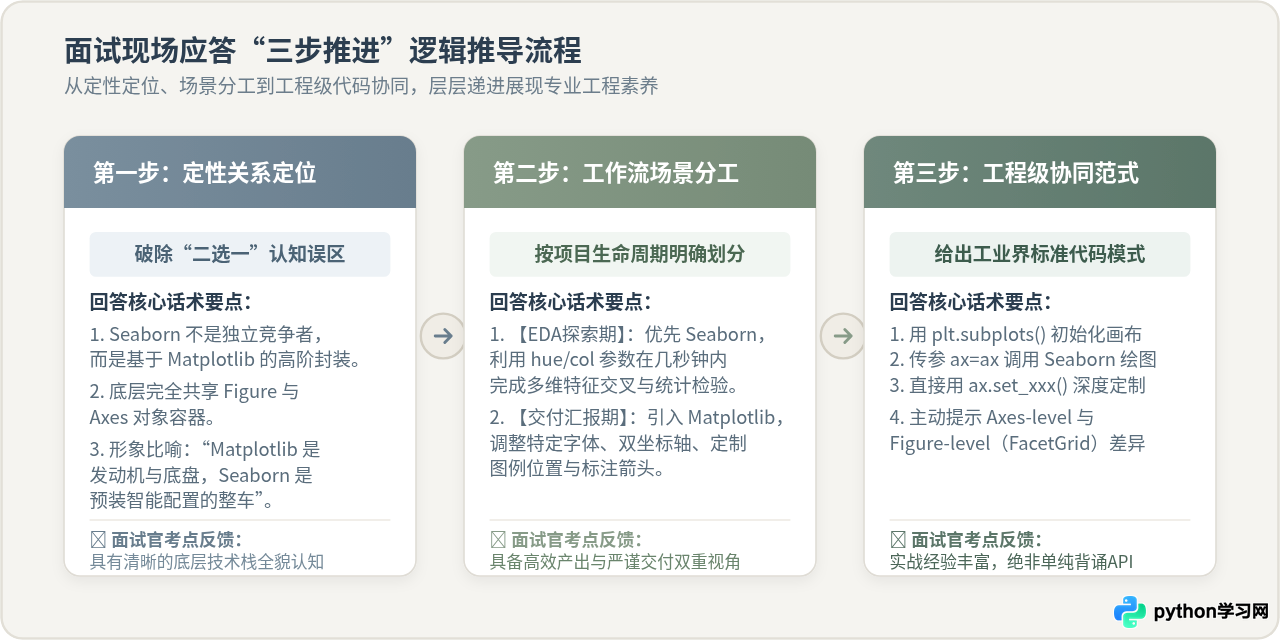
第一步:定性关系定位(破除对立认知)
开口第一句话先定性:“Seaborn 不是 Matplotlib 的替代品,而是构建在其之上的高阶统计封装,二者共享完全相同的底座对象(Figure 与 Axes)。在技术栈定位上,Matplotlib 是底层的绘图引擎与图元基石,而 Seaborn 是面向数据分析的高效表达工具。”
第二步:拆解工作流分工(生命周期划分)
接着结合项目实际流程说明具体分工:
- 探索性数据分析(EDA)阶段:业务要求是“快”与“多角度”。Seaborn 能够在极短时间内绘制分布图、箱线图、热力图和散点矩阵,自动计算置信区间,迅速发现异常值与变量关联。
- 报表交付与出版汇报阶段:业务要求是“准”与“严”。此时必须引入 Matplotlib 对坐标轴标签旋转、主副刻度密度、网格虚线、标题间距、边框脊柱等进行像素级规范化微调。
第三步:展示工程级协同落地(代码与对象传递)
最后展示高级实操细节:“在工程实践中,我通常采用协同模式——先用 Matplotlib 显式初始化带有指定尺寸和子图布局的 fig, ax,再把 ax 传给 Seaborn 绘图函数完成复杂的统计图形渲染,最后直接调用 ax.set_xxx() 方法完成样式收口。”
四、代码实战:从对比到协同的最佳实践
口述思路之后,如果面试官要求写出关键代码,或者在白板/线上编辑器中演示,以下两组具体代码能够充分说明两者的效率差异与协作范式。
1. 效率对照:绘制带分组的多变量散点图
如果使用原生 Matplotlib 绘制一个按类别分组着色、并自动生成图例的散点图,开发者必须手动遍历唯一类别、做数据切片、分批调用 scatter,代码较为繁琐:
# Matplotlib 原生做法:需手动维护循环与图例
import matplotlib.pyplot as plt

categories = df['category'].unique()
colors = ['#687D8D', '#879B88', '#D9822B']

fig, ax = plt.subplots(figsize=(6, 4))
for cat, color in zip(categories, colors):
    subset = df[df['category'] == cat]
    ax.scatter(subset['x'], subset['y'], label=cat, color=color, alpha=0.8)
ax.legend(title='Category')
ax.set_xlabel('Feature X')
ax.set_ylabel('Feature Y')
而如果使用 Seaborn,借助其声明式语义映射机制,只需直接指定 hue 列名,底层会自动完成类别提取、调色板映射和图例组装:
# Seaborn 做法:声明式语义映射,一行完成聚合与渲染
import seaborn as sns

ax = sns.scatterplot(data=df, x='x', y='y', hue='category', palette='crest')
2. 工业界标准范式:Seaborn 出图 + Matplotlib 微调
在实际项目中,最推荐的代码编写范式是显式面向对象协同。这种写法避免了 pyplot 全局状态机的副作用,同时兼顾了快速出图与精细控制:
import matplotlib.pyplot as plt
import seaborn as sns

# 1. Matplotlib 面向对象初始化:掌控画布规格
fig, ax = plt.subplots(figsize=(8, 4.5), dpi=100)

# 2. Seaborn 负责核心统计图表生成,绑定外部 ax
sns.boxplot(
    data=df,
    x='department',
    y='salary',
    hue='education',
    palette=['#687D8D', '#879B88'],
    ax=ax
)

# 3. Matplotlib 穿透微调:精修坐标轴与图元细节
ax.set_title("各部门不同学历员工薪资分布对比", fontsize=13, fontweight='bold', pad=12)
ax.set_xlabel("所属业务部门", fontsize=10.5)
ax.set_ylabel("月度综合薪资 (k)", fontsize=10.5)

# 隐藏上方与右侧多余边框脊柱(符合现代扁平美学)
ax.spines['top'].set_visible(False)
ax.spines['right'].set_visible(False)

# 细化网格与图例位置
ax.grid(axis='y', linestyle=':', alpha=0.6)
ax.legend(title="学历背景", frameon=True, facecolor='#FAF9F6')

# 4. 出版级保存
fig.tight_layout()
fig.savefig("salary_distribution.png", dpi=300)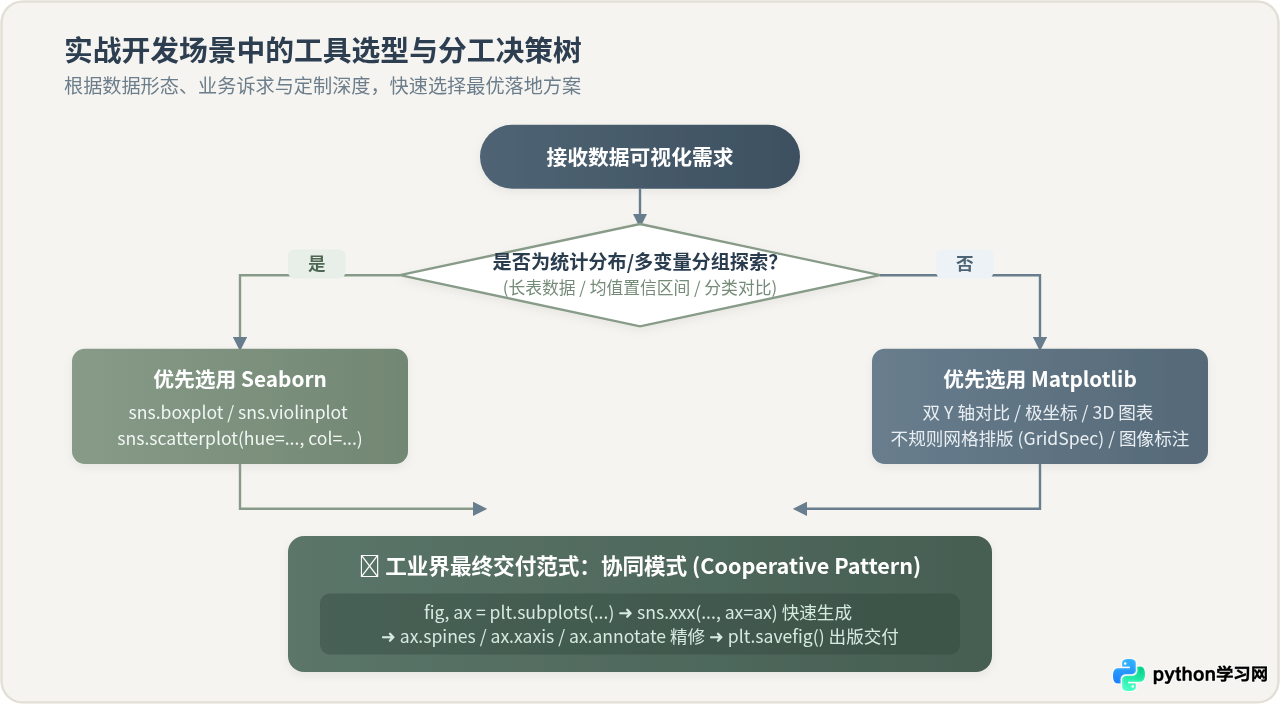
五、高频追问与防踩坑要点
面试官在听完基础分工后,往往会通过几个进阶问题测试应聘者是真正踩过坑还是仅背诵了博客。以下四个高频追问务必提前准备:
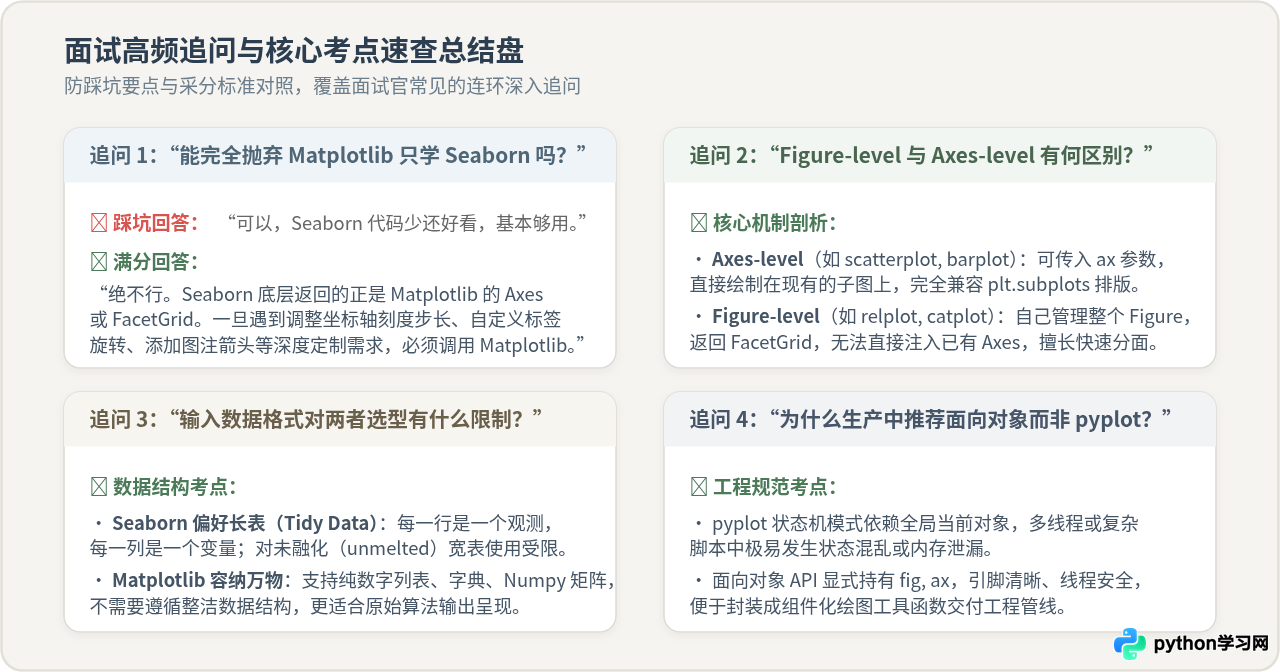
追问 1:既然 Seaborn 更好看更省事,能完全抛弃 Matplotlib 吗?
答题要点:绝对不能。Seaborn 的几乎所有绘图函数,最终返回的都是 Matplotlib 的 AxesSubplot 或 FacetGrid 对象。一旦面临非标准需求——例如双 Y 轴对比(twinx())、自定义刻度格式器(FuncFormatter)、局部放大镜头效果,或者公司统一视觉规范(特定的网格颜色、脊柱粗细、水印标注)时,Seaborn 本身不提供这些参数,必须通过调用 Matplotlib 原生 API 解决。
追问 2:Seaborn 中 Axes-level 与 Figure-level 函数有什么本质区别?
答题要点:这是体现技术深度的绝佳采分点。
- Axes-level 函数(如
scatterplot、histplot、boxplot):它们接受外部传入的ax参数,只在单一坐标系内作图,可以无缝嵌入plt.subplots(2, 2)的复杂网格中; - Figure-level 函数(如
relplot、displot、catplot):它们会自行创建并管理整个 MatplotlibFigure,返回FacetGrid对象。这类函数擅长通过col和row参数快速生成矩阵分面图,但不能通过ax=ax参数直接塞进现有的子图中。
追问 3:输入数据结构对两者选型有什么限制?
答题要点:Seaborn 强烈依赖整洁数据(Tidy Data / 长表格式),即“每一行代表一个观察样本,每一列代表一个变量”。如果手头的数据是宽表(例如列名是日期、单元格是各城市数值),在 Seaborn 中直接使用会非常别扭,通常需要先调用 pd.melt() 转换为长表;而 Matplotlib 则不限制数据结构,可以直接传入多维矩阵、标量列表或字典进行绘制。
在讨论 Matplotlib 时,主动说明在工程开发中避免使用 plt.plot() 这类 pyplot 全局状态机,而是坚持使用 fig, ax = plt.subplots() 面向对象模式。这能清晰展示你的代码具备良好的封装性,便于写入数据管道与自动化任务,防止多图绘制时出现状态串扰与内存驻留。
六、满分现场应答模版(提炼与背诵版)
🎯 现场 1 分钟结构化应答提纲参考
“关于 Matplotlib 和 Seaborn 的分工,我认为它们是底座与高阶封装的共生协作关系,而不是二选一的竞争关系。
在定位层面,Matplotlib 提供了完整的面向对象图元引擎,拥有对画布、坐标轴、脊柱和刻度的绝对控制力;Seaborn 则在此基础上深度结合了 Pandas 和统计模型,通过声明式语法实现了极高的数据抽象。
在实际工作流中,我们团队遵循 80/20 分工法则:在前期探索性数据分析(EDA)阶段,优先使用 Seaborn,通过 hue、col 等参数在几秒钟内完成多特征分布与统计置信度分析;在后期的业务交付与生产级报表阶段,使用 Matplotlib 显式初始化面向对象的 fig, ax,交由 Seaborn 绘制核心统计内容,最后利用 Matplotlib 的 API 对坐标轴标签、网格排版及图元标注进行像素级微调与导出。
这种分工既保证了探索分析的高周转效率,又保留了出版级定制的最终兜底能力。”
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















