


Python使用正则表达式同时按多种字符分割字符串
系统讲解在Python中使用re.split()按多种字符或复杂规则同时分割字符串的方法,涵盖字符集、多字符分支、捕获分组区别及连续分隔符处理等实用技巧。
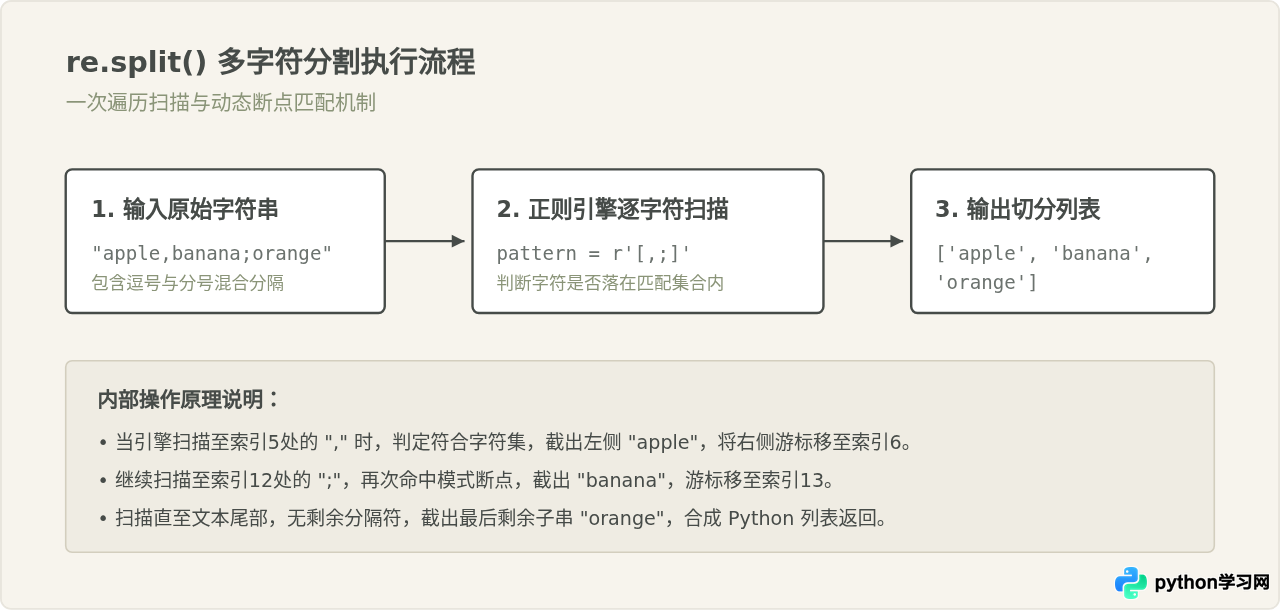
在日常文本处理中,我们经常遇到待处理字符串中混合存在多种分隔符号的情况,例如一段包含逗号、分号、空格以及制表符的原始数据。Python 原生内置的 str.split() 只能传入一个固定的分隔符,无法单次根据多个不同符号进行切割。针对这一需求,标准库中的 re.split() 函数提供了直接而灵活的解决方案。通过编写简洁的正则表达式规则,程序可以在一次扫描中同时匹配所有目标字符并将文本精准切分。
一、基础方案:使用字符集一次匹配多种单字符
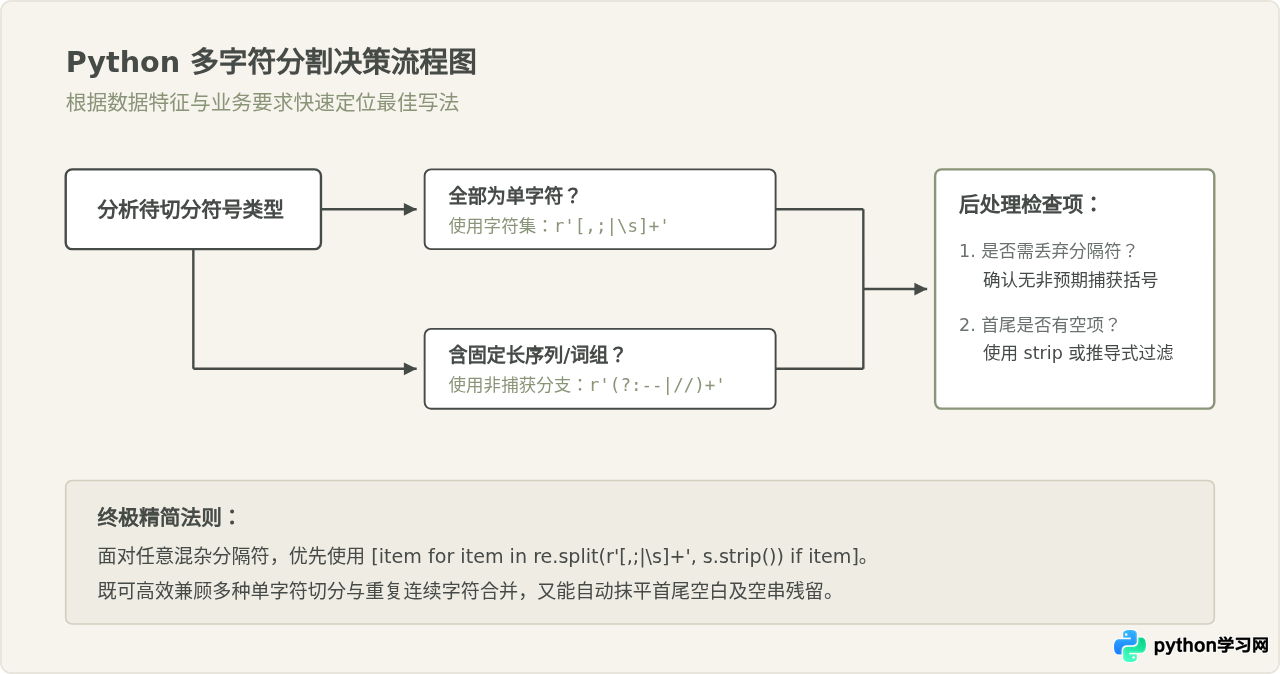
当所有的目标分隔符都是单个字符(例如半角逗号 ,、半角分号 ;、竖线 | 或空白符 \s)时,最直接的方式是使用正则表达式的方括号字符集语法 [...]。
在字符集语法中,方括号内的所有字符都处于逻辑“或”的关系。正则表达式引擎只要遇到方括号内列出的任意一个符号,就会将其作为切分点截断字符串。例如表达式 r'[,;|\s]' 表示只要遇到逗号、分号、竖线或任意空白字符即切开文本。
import re

# 原始文本包含逗号、分号、竖线和空格
raw_text = "apple,banana;orange|grape melon"

# 使用字符集匹配任意一种单字符分隔符
result = re.split(r'[,;|\s]', raw_text)
print(result)在编写正则表达式字符串时,建议始终在引号前加上前缀 r(原生字符串,Raw String)。这样可以防止 Python 语法层面对反斜杠 \ 进行转义,确保类似 \s(空白符)或 \t(制表符)的规则能原封不动地传递给正则引擎解析。
二、进阶场景:包含多字符序列与特殊符号的切分
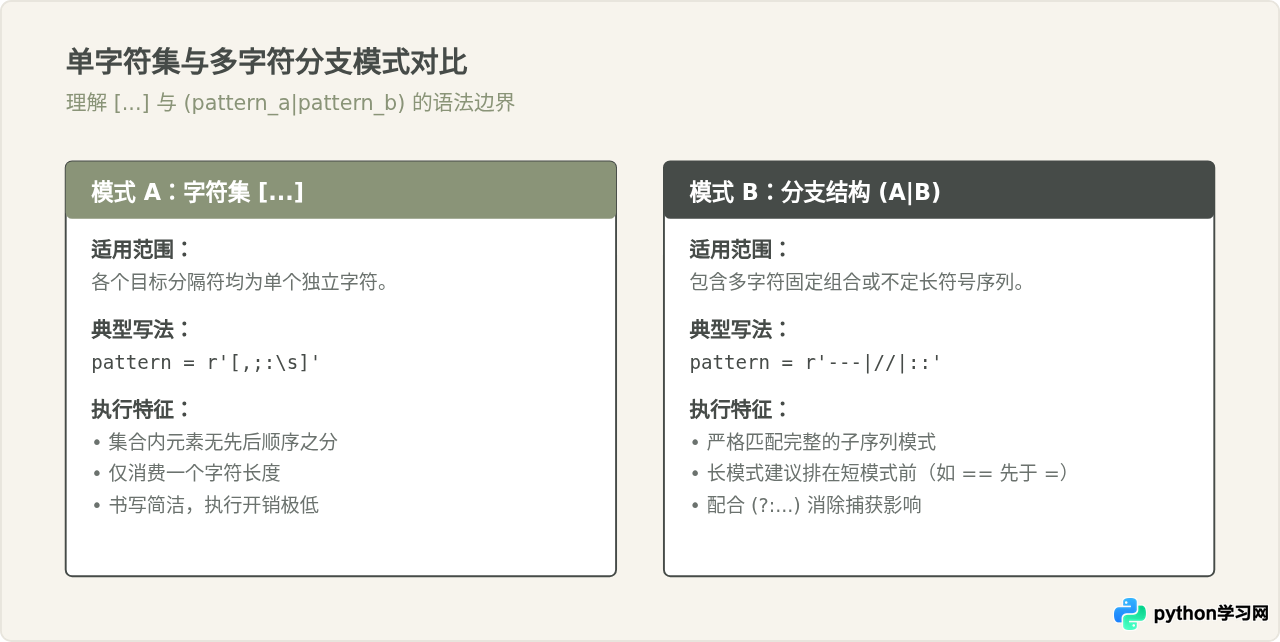
在实际业务中,分隔符往往不限于单个英文字符。有时分隔符是多个字符构成的固定词组或符号串,例如 ---、//、:: 以及中文字符。此时直接使用方括号 [...] 会出现意料之外的错误。
1. 字符集与逻辑分支的区别
常见误区是把形如 [--|//|::] 写入方括号中,误以为它表示匹配 -- 或 //。实际上,方括号 [...] 仅表示单个字符的集合。如果写入 [--//::],正则引擎会把减号、斜杠、冒号作为独立的单个符号拆解,导致文本中任何一个孤立的斜杠或减号都会被当成分隔符切断。
当需要匹配多字符组合时,必须使用管道符号 | 构成逻辑或(Alternation)的分支结构,并配合非捕获括号 (?:...) 将多个多字符模式合并:
import re

# 包含双斜杠、三短横和冒号的复杂字符串
log_data = "INFO//DatabaseConnected---Port::8080---User//Admin"

# 错误写法:r'[-/:]' 会把单独的 - 或 / 也切开
# 正确写法:使用 | 明确表达多字符组合
result = re.split(r'//|---|::', log_data)
print(result)2. 转义特殊正则元字符
如果希望以点号 .、星号 *、加号 +、问号 ?、反斜杠 \ 或竖线 | 等本身在正则表达式中具备特殊含义的符号作为分隔符,必须使用反斜杠显式转义。例如以逗号和竖线切分时,竖线在分支中表示“或”,若要匹配字面值竖线,应写作 \|,或者置于字符集 [,\|] 内。
三、关键陷阱:捕获括号保留了分隔符
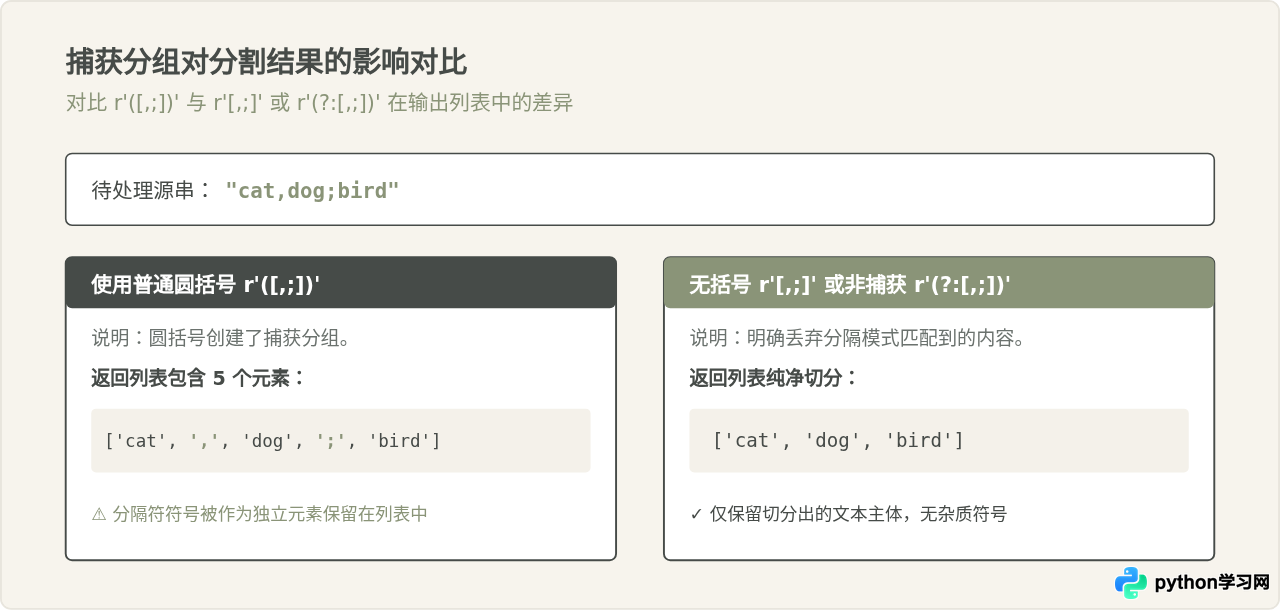
在使用 re.split() 时,最常见的意外问题就是返回的列表中多出了分隔符本身。初学者常疑惑:为什么按照相同符号分割,结果里却夹杂着匹配到的逗号和分号?
1. 捕获分组机制解析
这是由 Python 正则引擎关于捕获分组(Capturing Parentheses)的规定决定的:如果在分割模式中使用了圆括号 (...),并且未声明为非捕获模式,re.split() 会把匹配到的每个分组内容也作为独立元素一并塞入返回列表。
import re

text = "alpha,beta;gamma"

# 陷阱写法:带捕获圆括号
res_capture = re.split(r'([,;])', text)
print("捕获圆括号结果:", res_capture)

# 标准写法:使用字符集或非捕获分组 (?:...)
res_no_capture = re.split(r'[,;]', text)
print("常规切分结果: ", res_no_capture)2. 如何避免与何时利用
只要我们仅需要切分后的数据主体,就应当:
- 能用字符集
[...]解决时,直接书写字符集,无需在外层包裹圆括号。 - 必须使用括号控制优先级时(如多字符分支),使用非捕获语法
(?:...),例如r'(?:--|//)'。问号冒号?:明确指示引擎只匹配不捕获。
反之,若业务确实需要在分割文本的同时保留分隔标记(例如数学表达式求值时,切出数字的同时需要保留加减乘除运算符),则可以主动利用捕获括号这一机制。
四、处理连续分隔符与首尾空白的最佳实践
在现实数据源中,多个分隔符号经常会挨在一起出现,或者出现在字符串的最前和最后。如果未做特殊设置,re.split() 可能会产生大量空字符串 ''。
1. 为什么会产生空字符串
假设字符串为 "A,,B",正则规则为 r'[,]'。当引擎切开第一个逗号后,在第一个逗号与第二个逗号之间,其实存在长度为 0 的内容。正则引擎会诚实地将这段空内容作为 '' 加入列表中。同理,若字符串以分隔符开头或结尾,首尾两侧也会产生空字符串。
2. 使用量词 + 合并连续符号
如果业务要求只要相连的分隔符号一律视作单个分割点,只需要在字符集或非捕获分支后添加量词 +(表示匹配一次或多次):
import re

# 连续出现逗号、分号及空格
dirty_string = "Beijing, ,Shanghai;;;Guangzhou| |Shenzhen"

# 未加加号:产生多个空字符串
print("单次匹配:", re.split(r'[,;|\s]', dirty_string))

# 加上加号:将连续的一个或多个分隔符整体视作一个分割点
print("贪婪合并:", re.split(r'[,;|\s]+', dirty_string))3. 处理首尾分隔符:结合 strip() 与列表推导式
如果连续分隔符出现在字符串的开头或结尾,即使添加了 +,由于左侧或右侧确实存在断点,依然可能在首尾留下一个空字符串。最稳妥、高效的生产级写法是先对原始字符串进行两端清理,或者通过推导式过滤:
import re

source = ",,red, green;;blue|,"

# 方案一:切分前先 strip 清理两端常见符号
cleaned_source = source.strip(",;|\s ")
tokens_1 = re.split(r'[,;|\s]+', cleaned_source)
print("方案一结果:", tokens_1)

# 方案二:利用列表推导式或 filter 过滤空值
tokens_2 = [item for item in re.split(r'[,;|\s]+', source) if item]
print("方案二结果:", tokens_2)五、控制分割次数:maxsplit 参数
与内置方法 str.split() 类似,re.split() 提供了 maxsplit 参数,用于限制最大切分次数。该参数默认为 0,表示“切分全部”。
在只需提取键值对或前几列属性的场景中,限制分割次数可以避免不必要的多余切分,并保证保留后续剩余文本的完整性:
import re

header_and_body = "User:Tom;Role:Admin;Notes:He likes Python, C++, and Go"

# 仅切分前两次,保留 Notes 字段内的所有内部符号
fields = re.split(r'[:;]', header_and_body, maxsplit=4)
print(fields)六、全流程决策与方案总结
为帮助读者在实际编码中快速选择最合理的正则分割策略,下表整理了常见场景与对应方案:
| 场景需求 | 推荐模式(Pattern) | 代码示例与要点 |
|---|---|---|
| 切分逗号、空格、分号等单字符 | r'[,;\s]+' |
使用方括号字符集,加上 + 吸收连续重复分隔符。 |
切分包含多字符的固定标记(如 --- 或 //) |
r'(?:---|//|\s)+' |
使用管道 | 连结,用 (?:...) 避免产生捕获列表。 |
| 切分包含正则元字符(如点、星号、竖线) | r'[,\.\|\*]+' |
对元字符添加反斜杠转义,确保按字面值匹配。 |
| 切分的同时需要保留分隔符号 | r'([,;])' |
主动使用捕获圆括号,分隔符将按出现顺序交替存放在列表中。 |
| 只切分前 N 项,保留后续文本完整性 | 设定 maxsplit=N |
传入显式整数限制切分步数,避免破坏后续嵌套数据。 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















