


Python读取CSV常见报错:FileNotFoundError与UnicodeDecodeError排查
针对Python使用内置csv模块或pandas读取CSV时最常见的FileNotFoundError与UnicodeDecodeError两大报错,本文提供成因剖析、排查流程、修复代码及最佳实践规范。
csv 模块或第三方库 pandas 读取外部 CSV 文件时,最常遇到的两类阻碍是 FileNotFoundError(路径未找到)与 UnicodeDecodeError(文本解码失败)。这两类错误并非代码逻辑存在严重缺陷,而是由于“操作系统当前工作目录与相对路径偏差”以及“磁盘物理编码与解释器解码参数不匹配”所致。本文提供清晰的根因定位方法、标准化排查步骤与稳健的修复代码。
一、FileNotFoundError:路径找不到的根因与排查步骤
当执行 open('data.csv') 或 pd.read_csv('data.csv') 时,如果 Python 返回类似 FileNotFoundError: [Errno 2] No such file or directory: 'data.csv',说明解释器在所检索的目标路径下未能定位到该物理文件。
初学者常误以为“只要 Python 脚本与 CSV 放在同一个文件夹,就能直接通过文件名读取”。事实上,Python 解析相对路径的基准并不是当前 .py 脚本所在的目录,而是启动 Python 进程时所在的当前工作目录(Current Working Directory, CWD)。在 VSCode、PyCharm 等编辑器中直接点击“运行”或者通过终端在根目录执行不同层级的脚本时,当前工作目录通常是项目根目录,而非子文件夹。
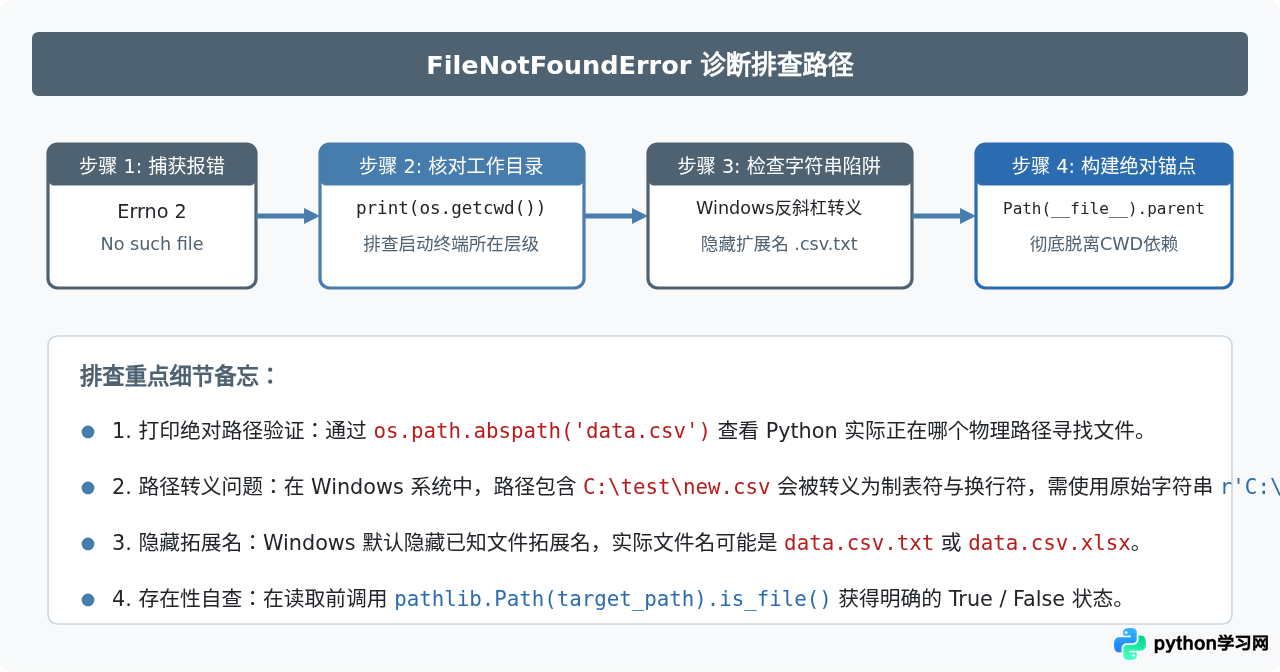
常见排查与修复方案
为了避免受工作目录变动的影响,工程中最稳健的做法是以当前代码文件自身的位置为基准定位资源文件。使用标准库 pathlib.Path 可以跨平台优雅处理:
from pathlib import Path
import pandas as pd

# 1. 获取当前脚本所在的绝对目录
BASE_DIR = Path(__file__).resolve().parent

# 2. 拼接目标 CSV 文件路径(支持子目录,如 BASE_DIR / "data" / "users.csv")
csv_path = BASE_DIR / "users.csv"

# 3. 校验文件是否存在
if not csv_path.is_file():
    raise FileNotFoundError(f"未找到目标文件,请确认路径: {csv_path}")

# 4. 执行安全读取
df = pd.read_csv(csv_path)
print(f"成功读取 {len(df)} 行数据")
在 Jupyter Notebook 中执行时,__file__ 变量并不存在,直接使用 Path.cwd() 即可,因为 Notebook 默认的工作目录就是当前 .ipynb 文件所在的文件夹。如果在命令行独立运行脚本,务必优先使用 Path(__file__).resolve().parent。
二、UnicodeDecodeError:字符编码冲突的成因与识别
当文件成功定位后,执行读取时可能弹出如下报错:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd6 in position 0: invalid start byte
或者在 Windows 默认环境下提示:
UnicodeDecodeError: 'gbk' codec can't decode byte 0x80 in position ...: illegal multibyte sequence
计算机在磁盘中存储文本时,本质上是一串二进制字节(Bytes)。读取文件时,程序必须依照某种既定的编码规则(Encoding)将字节映射回人类可读的文字字符。报错的直接原因在于:文件保存时所用的编码格式,与 Python 打开文件时指定的解码规则不一致。
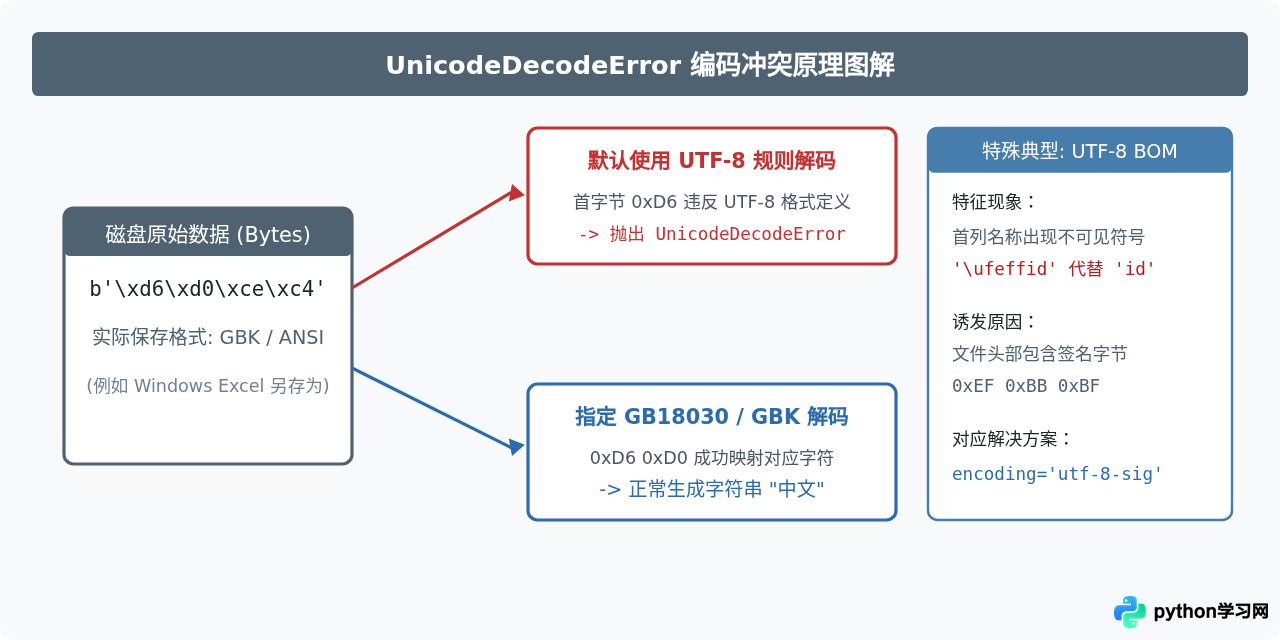
导致编码冲突的三大现实场景
-
Windows 简体中文版 Excel 导出的 CSV:Microsoft Excel 默认导出的“CSV (逗号分隔)”通常使用系统本地代码页 ANSI(即
GBK或CP936编码)。如果 Python 脚本在 Linux、macOS 或设置了 UTF-8 模式的环境下直接按utf-8解析,在遇到第一个汉字时就会立即抛出UnicodeDecodeError。 -
包含 UTF-8 BOM 签名:部分系统或旧版编辑器保存的 UTF-8 文件在开头写入了 3 个字节的 BOM(
\xef\xbb\xbf)。如果按普通utf-8读取,虽然不会崩溃,但表头的第一个字段名会被污染为\ufeffcolumn_name,导致后续通过键名访问时出现KeyError。 -
生僻字与特殊符号截断:标准
GB2312收录汉字较少,GBK收录较全,而GB18030是国家标准超集,收录了更多少数民族文字和生僻字。如果用gbk打开包含人名生僻字的 CSV,仍可能偶尔出现解码失败。
三、编码报错的快速排查与选型决策流程
遇到编码报错时,切勿盲目尝试 errors='ignore'。忽略错误会导致部分字符被无提示吞掉,破坏 CSV 文件的逗号分隔符与字段对齐,导致整行数据错位。正确的做法是按顺序推导并指定真实编码。
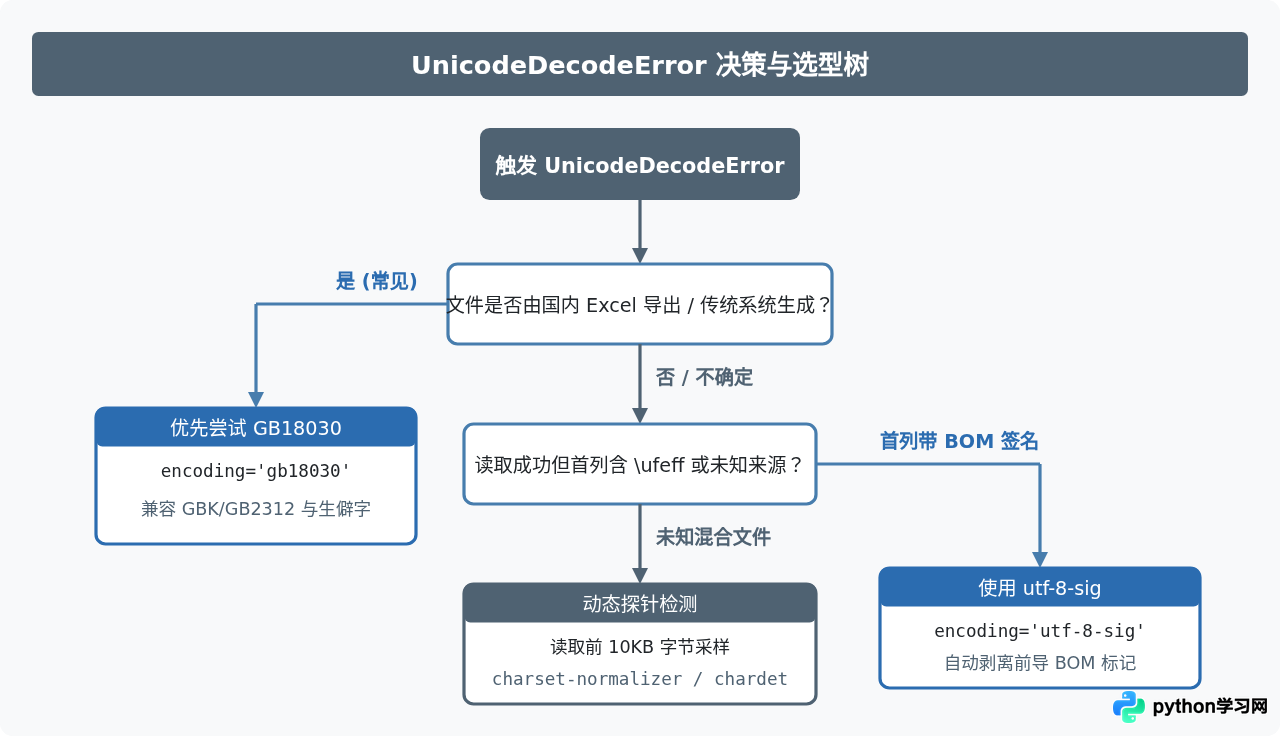
标准读取与自动探测代码示例
对于已知为中文环境导出的文件,推荐直接将编码设定为覆盖面更广的 gb18030:
import csv
import pandas as pd

# 示例 1: 使用内置 csv 模块读取 GBK / GB18030 文件
with open('sales_data.csv', mode='r', encoding='gb18030', newline='') as f:
    reader = csv.DictReader(f)
    for row in reader:
        print(row)

# 示例 2: 使用 pandas 读取带 BOM 或 GB18030 的数据
try:
    df = pd.read_csv('sales_data.csv', encoding='utf-8')
except UnicodeDecodeError:
    # 捕获后降级尝试 gb18030
    df = pd.read_csv('sales_data.csv', encoding='gb18030')
若程序需要批量接入用户上传的不可控 CSV 文件,可以通过二进制读取文件头(通常只需读取前 10KB~50KB 字节)进行编码采样分析,避免将整个大文件读入内存:
from pathlib import Path
import charset_normalizer  # 或 import chardet

def detect_csv_encoding(file_path: Path, sample_size: int = 20480) -> str:
    """采样检测文件的真实编码"""
    with open(file_path, 'rb') as f:
        raw_bytes = f.read(sample_size)

    result = charset_normalizer.detect(raw_bytes)
    detected_encoding = result.get('encoding')

    # 若无法确定或置信度较低,兜底回退至 utf-8 或 gb18030
    return detected_encoding or 'utf-8'

target_file = Path('incoming_data.csv')
best_encoding = detect_csv_encoding(target_file)
print(f"探测到目标文件编码: {best_encoding}")

df = pd.read_csv(target_file, encoding=best_encoding)
四、排查总结与防御性读取规范
为了将这两类错误在生产环节彻底隔绝,下表汇总了问题表现、核心成因与标准化预防手段:
| 报错类别 | 典型错误特征 | 核心诱因 | 推荐解决方案 |
|---|---|---|---|
| FileNotFoundError | [Errno 2] No such file or directory |
相对路径受执行端 CWD 偏移影响;Windows 路径反斜杠转义;文件名隐藏后缀。 | 使用 Path(__file__).resolve().parent 构造绝对锚点;使用原始字符串 r'...'。 |
| UnicodeDecodeError | 'utf-8' codec can't decode byte 0xd6... |
Windows Excel 默认 ANSI/GBK 导出;多字节汉字超出标准 ASCII/UTF-8 边界。 | 显式指定 encoding='gb18030';带 BOM 文件指定 encoding='utf-8-sig'。 |
| 隐藏属性污染 | 首字段键名变为 \ufeffid,产生 KeyError |
UTF-8 签名头(Byte Order Mark)未被剥离。 | 将 encoding='utf-8' 改为 encoding='utf-8-sig' 即可透明去除签名。 |
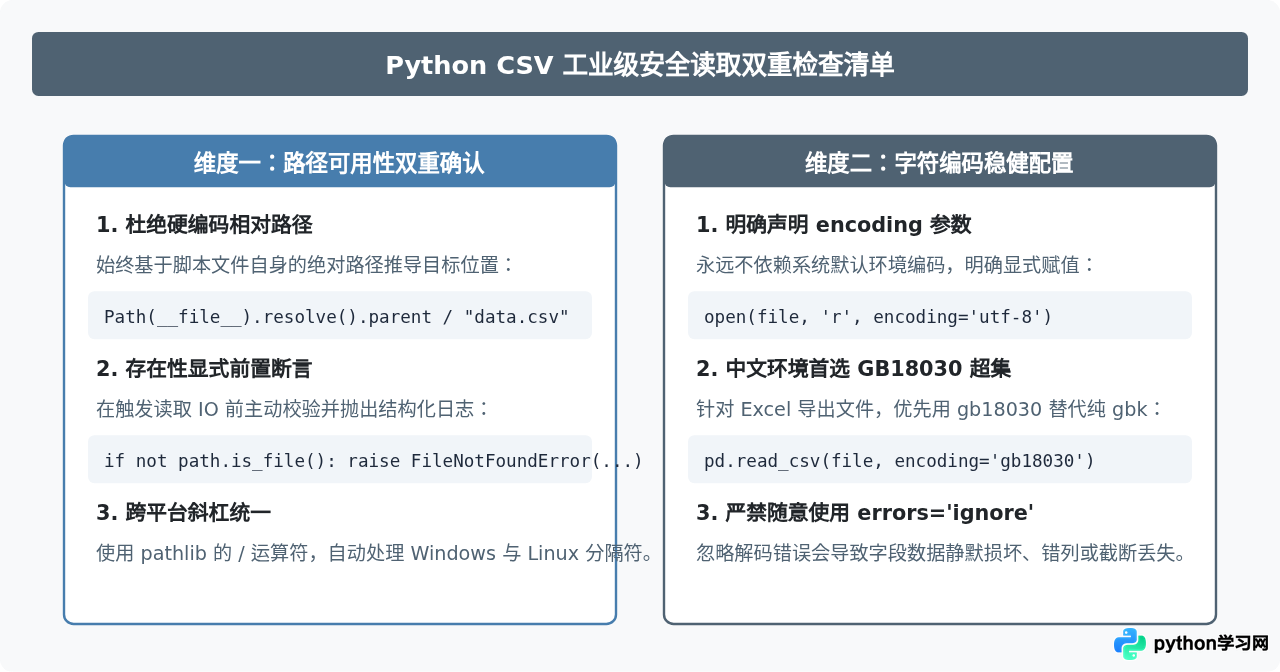
只要在开发阶段坚持“以脚本绝对路径锚定目标”并“根据文件来源明确声明字符编码”,即可彻底规避 FileNotFoundError 与 UnicodeDecodeError,保障数据流水线的稳定运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















