


为什么Python 3成为主流:从语法改进到生态系统优势
深入解析Python 3取代Python 2成为全行业绝对主流的技术演进路径。从文本与字节解耦、print函数化、类型提示与异步语法等语言规范革新,到科学计算与AI生态断腕迁移、官方EOL终结支持的历史必然。
Python 3 能够全面取代曾经极为成熟的 Python 2,核心原因在于它彻底解决了长期困扰开发者的底层编码隐患,引入了满足现代工业级软件所需的类型注解与异步并发语法,更在于科学计算与人工智能两大超级生态的决绝转向。Python 3 从诞生之初打破向后兼容的巨大争议,逐步演变为今日全行业无可争议的基石语言,这一跨变展现了清晰的工程演进逻辑与生态传导必然性。
一、字符串体系的彻底重构:消灭隐式编码灾难
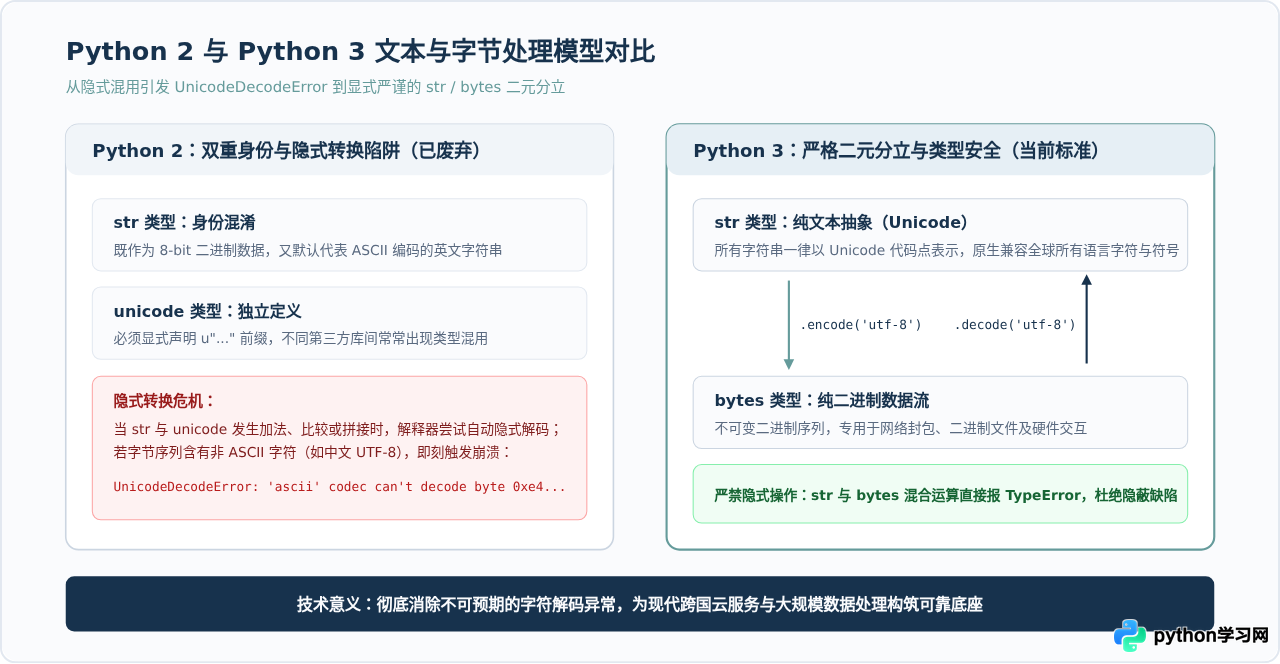
在 Python 2 时代,最令跨语言和网络数据处理开发者头痛的问题莫过于 UnicodeDecodeError。造成这一缺陷的根本根源在于数据模型的含混:Python 2 中的 str 类型本质上是原始字节序列,而文本则由专门的 unicode 类型承载。由于两者之间允许隐式自动转换,当程序试图将包含非 ASCII 字符的字节流与字符串拼接时,运行时就会默认使用系统 ASCII 编码进行解密,进而直接引发不可预测的崩溃。
# Python 2 中的隐式转换隐患(示例演示)
text = u"数据处理: "
raw_bytes = "测试内容"  # 实际为 UTF-8 编码的字节串

# 以下操作在 Python 2 下会尝试隐式使用 ASCII 解码 raw_bytes,导致报错:
# UnicodeDecodeError: 'ascii' codec can't decode byte 0xe6 in position 0: ordinal not in range(128)
# result = text + raw_bytes
Python 3 做出了至关重要的数据模型解耦:严格将“人类可读的文本”与“机器处理的二进制字节”切分为两种完全互不兼容的独立类型:
str类型:所有字符串在内存中默认且统一采用 Unicode 抽象存储,原生支持汉字、各国字符与特殊符号,不再有默认编码混淆。bytes类型:专用于网络通信、文件磁盘读写或硬件协议的不可变二进制字节序列。
两者之间严禁隐式混用与运算。在 Python 3 中,如果你尝试将 str 和 bytes 直接相加,解释器会在第一时间明确抛出 TypeError,将潜在的隐蔽故障扼杀在编码初期。文本与二进制之间的流转必须通过显式的 encode() 与 decode() 方法完成:
# Python 3 中的显式转换标准示例
text = "深度学习与工程实践"
# 将 Unicode 文本显式编码为 UTF-8 字节流
data_bytes = text.encode("utf-8")
print("字节数据:", data_bytes)  # 示例输出: b'\xe6\xb7\xb1\xe5\xba\xa6...'

# 从二进制字节流显式还原为 Unicode 文本
recovered_text = data_bytes.decode("utf-8")
print("还原文本:", recovered_text)  # 示例输出: 深度学习与工程实践
二、语法现代化与工程化支撑:从脚本走向大型软件
早期 Python 常被视作编写快捷脚本的“胶水语言”,然而在面对成百上千人协同的大型企业级项目时,Python 2 暴露出了许多语法松散、内存占用过高与并发模型薄弱的缺陷。Python 3 通过一系列深度语法革新,系统性地夯实了面向大型工程的支撑能力:
1. 函数化与语法一致性
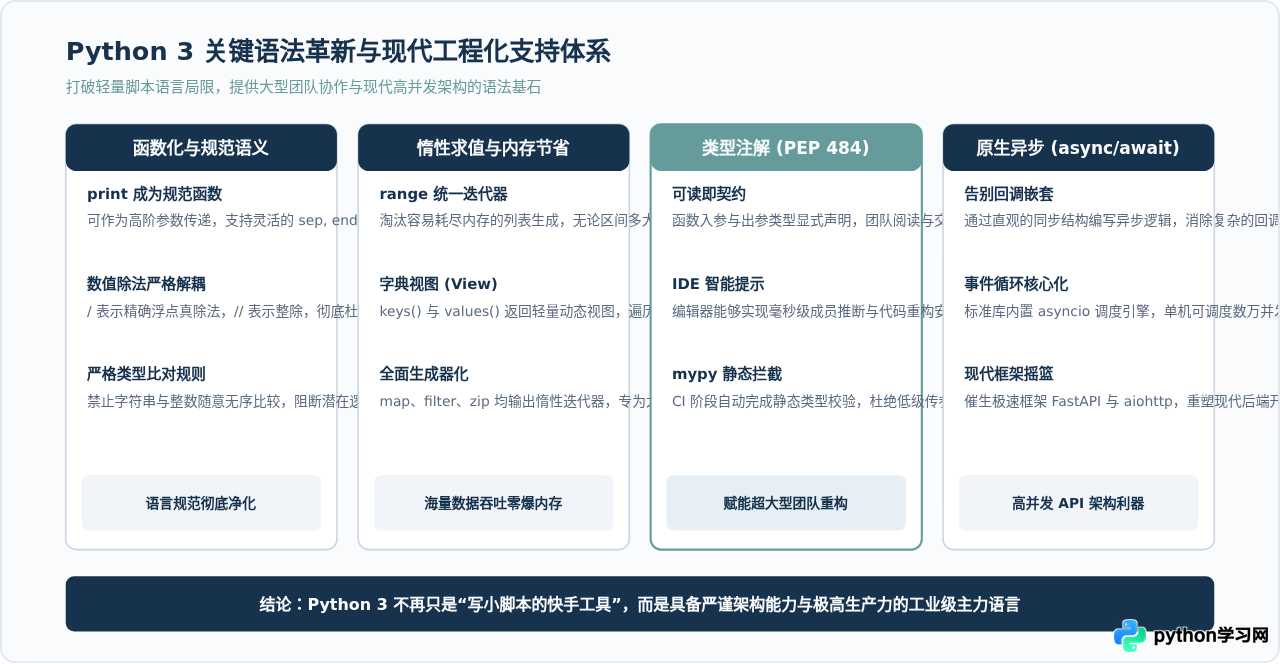
在 Python 2 中,print 是一个内置关键字语句(statement),无法像普通函数那样作为参数传递,重定向输出格式亦相当别扭。Python 3 将其正式规范为标准内置函数 print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False),这不仅使语法风格保持纯粹统一,而且允许开发者自由覆盖、包装或作为高阶函数传递。
在数值计算方面,Python 3 将除法运算符 / 定义为精确的“真除法”(如 3 / 2 == 1.5),而将整除明确分配给 // 运算符。这一改进根除了 Python 2 中两个整数相除默认向下取整(3 / 2 == 1)而导致的隐晦业务计算偏差。
2. 内存友好的惰性迭代(Lazy Evaluation)
在 Python 2 中,调用 range(1000000) 会在内存中立即实例化包含一百万个整数的完整列表,瞬间占用巨量内存空间;开发者不得不记忆并使用 xrange() 来避免内存溢出。Python 3 彻底移除了 xrange(),并将 range() 原生设计为基于迭代器协议的惰性生成序列,耗费常数级别(O(1))内存。
类似地,字典对象的 dict.keys()、dict.values() 和 dict.items() 在 Python 3 中不再返回全新的列表拷贝,而是返回高效的字典动态视图(View),极大地降低了数据遍历过程中的系统内存开销。
3. 原生类型注解(Type Hints, PEP 484)
动态类型语言在项目规模扩大后,函数参数约定模糊、重构成本高昂是公认的痛点。Python 3.5 引入了类型注解标准,允许开发者显式标注文档级别的类型契约:
# Python 3 现代化函数签名与类型提示
from typing import List, Dict, Optional

def analyze_user_scores(user_id: int, scores: List[float]) -> Dict[str, float]:
    if not scores:
        return {"average": 0.0, "max": 0.0}
    return {
        "average": sum(scores) / len(scores),
        "max": max(scores)
    }
类型注解本身不会在运行期带来性能损失,但为现代开发工具带来了质的飞跃:VS Code、PyCharm 等 IDE 能够实现精准的语义补全与跳转,而静态代码分析工具(如 mypy、pyright)则能在代码交付前静态拦截超过 80% 的空指针与类型传参错误。
4. 原生协程与现代异步 I/O(async / await, PEP 492)
高并发网络服务一直是对 Python 的严峻考验。Python 2 时代处理并发依赖于多线程(受制于全局解释器锁 GIL)、多进程或基于 yield 的复杂黑魔法。Python 3.5 正式引入了 async def 与 await 关键字,确立了顶层异步编程语法。这直接催生了以 FastAPI、aiohttp 为代表的超高性能现代微服务框架,单机处理并发连接能力提升了一个数量级。
三、生态系统的断腕迁移:决定胜负的关键力量
虽然 Python 3 在语言设计上全方位超越了 Python 2,但真正促使全球数以百万计的开发者和企业抛弃旧代码、全面拥抱 Python 3 的,并非单纯的语法偏好,而是生态系统的不可逆迁移与官方支持的彻底终结。
1. 科学计算联盟的联合承诺书(Python 3 Statement)
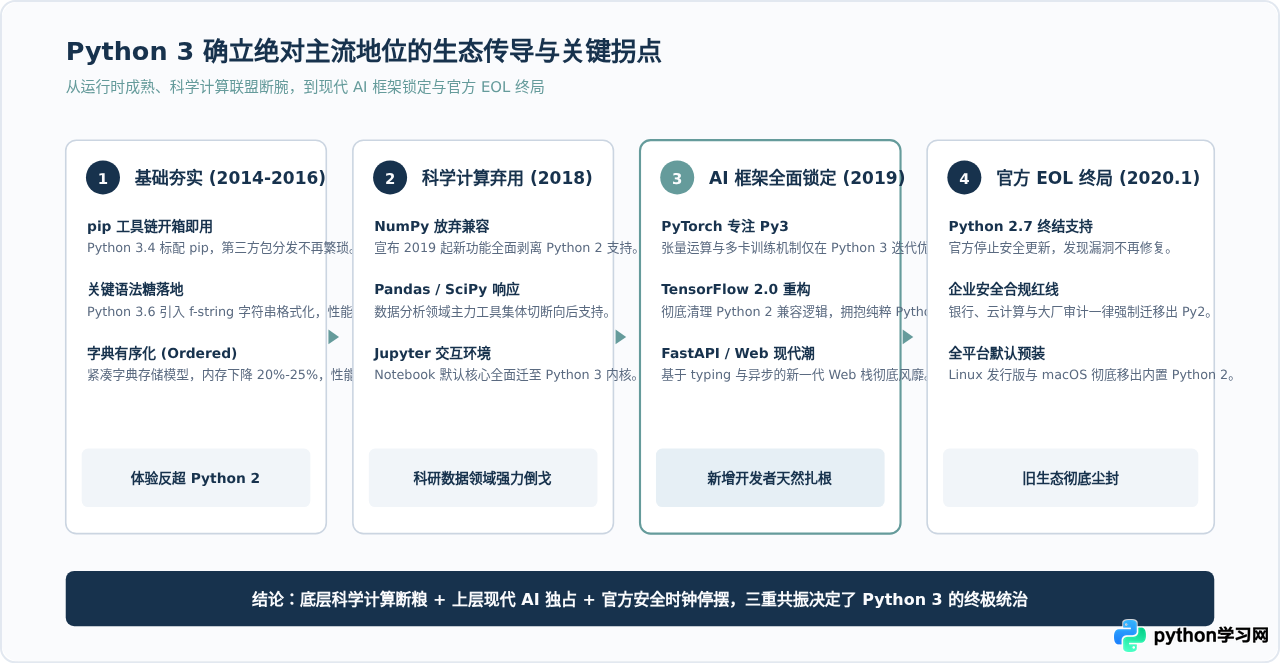
在数据科学与人工智能爆发的前夕,维护两个不兼容版本的成本几乎拖垮了开源维护者。2018 年前后,全球主流科学计算项目发起了具有里程碑意义的联合宣言:NumPy、SciPy、Pandas、Matplotlib、IPython、Jupyter 等核心项目郑重声明:自 2019 至 2020 年起,所有后续的新版本将全面停止为 Python 2 打包和发布。
这意味着任何从事数据分析、算法开发与科研计算的团队,如果继续停留在 Python 2,将无法再享受现代 NumPy 的 C 级矢量化优化、Pandas 高性能新 API 以及更现代的绘图引擎。这一来自基础底座的硬约束,迅速倒逼整个科研界与数据分析领域在极短时间内完成切换。
2. 深度学习浪潮的全面技术锁定
以 PyTorch、TensorFlow 2.0、Transformers 为首的现代深度学习框架,其核心设计大量使用了 Python 3 的高级特性(例如通过类型提示进行张量形状校验、利用格式化字符串 f-string 加速日志记录、依托原生协程调度流式数据读取等)。现代 AI 框架从一开始就明确剥离了对 Python 2 的兼容代码。随着 2018 年后大模型与深度学习的爆发式增长,几乎所有新入行的工程师从第一天起就自然而然地运行在 Python 3 之上。
3. 官方 EOL 终局裁决(2020 年 1 月 1 日)
Python 官方早在 2008 年就宣布了 Python 2 的淘汰计划,并两度推迟退役时间。最终,Python 软件基金会(PSF)严格执行了裁决:Python 2.7 于 2020 年 1 月 1 日正式抵达生命周期终点(EOL, End of Life)。此后,官方不再为 Python 2 提供任何安全漏洞修补(CVE)、Bug 修复或新系统架构适配。在企业合规、网络安全审计以及云原生容器部署的硬性要求下,遗留的 Python 2 系统被迫全面退出生产舞台。
四、平滑过渡:从 Python 2 到 Python 3 的迁移实践
对于仍需维护遗留代码资产或理解迁移过程的团队,了解标准化迁移工具与常见易错点至关重要。一个稳健的迁移工程通常遵循以下验证步骤:
1. 现代化工具链辅助
社区提供了成熟的代码语法重构工具,能够自动识别并转换绝大部分机械性语法差异:
2to3:官方提供的内置迁移转换脚本,能够将print语句、except语法以及已重命名的标准库模块路径(例如urllib2拆分整合至urllib.request)自动重写。pyupgrade:针对已迁移至 Python 3 的代码库,自动将其升级为采用现代语法糖(如将"%s" % var或"".format()自动重构为更高效的f"{var}")。
# 自动化语法转换检查示例(在命令行终端执行)
# 扫描并查看代码差异(不直接写入)
2to3 my_project/

# 确认无误后执行就地重写
2to3 -w my_project/
2. 核心迁移暗坑排查清单
| 功能特性 | Python 2 表现 | Python 3 表现 | 迁移应对建议 |
|---|---|---|---|
| 字符串与编码 | str 为字节串,混用可能静默通过 |
str 为 Unicode,混用报 TypeError |
在 I/O 边界显式标注 .encode('utf-8') 与 .decode('utf-8') |
| 数值除法 | 5 / 2 == 2(整数默认向下取整) |
5 / 2 == 2.5(真除法) |
如需保留旧有整除语义,需统一将 / 替换为 // |
| 字典遍历 | d.keys() 返回全量列表 |
d.keys() 返回轻量动态视图 |
如果后续代码依赖列表索引或切片,需显式使用 list(d.keys()) 包装 |
| 对象排序/比较 | 允许不同类型之间直接比大小(如 1 < "2") |
不同非兼容类型比较直接抛出 TypeError |
确保参与排序与比较的元素具备相同的类型与实现 |
| 标准库路径 | urllib, urllib2, ConfigParser |
重构为 urllib.request, configparser 等 |
按 PEP 3108 规范调整导入语句 |
避坑提示:迁移过程中最容易被忽视的是网络通信与二进制文件读写。在 Python 3 中打开文件时,如果操作的是文本内容,必须显式传递 open(filename, 'r', encoding='utf-8');如果操作的是图片、序列化对象等二进制数据,则必须严格使用 'rb' 或 'wb' 模式,避免将字节序列错误视作字符串处理。
五、全景总结:Python 3 的现代化支撑体系
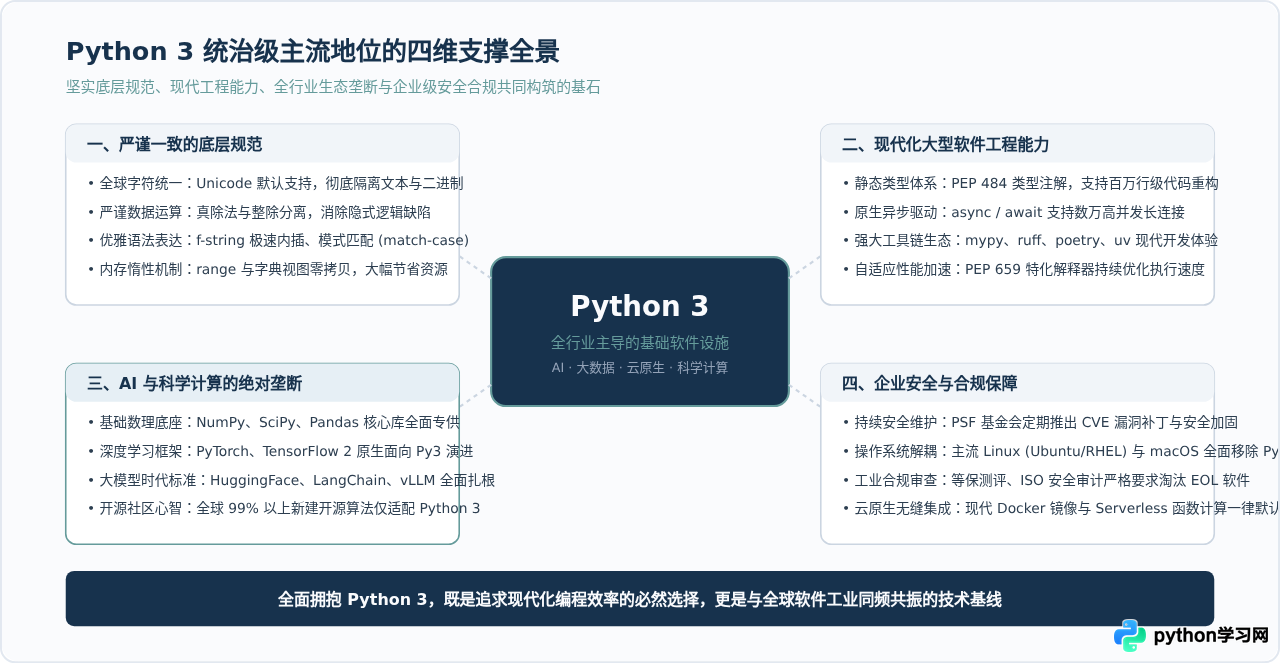
综上所述,Python 3 之所以能够克服巨大阻力成为当今世界最受欢迎的通用编程语言之一,本质上是技术规范的理性升级与全球开源生态共识共同促成的结果。它不仅修正了上世纪九十年代遗留下来的历史技术包袱,更凭借简洁明了的高级语法、高扩展性的类型提示系统与强大的并发模型,完美契合了当代云计算、数据分析以及大模型 AI 应用的严苛标准。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















