


Python怎么实现大小写不敏感的字符串比较
详细讲解在 Python 中实现大小写不敏感字符串比较的标准方法,深入解析 str.casefold() 与 str.lower() 的核心差异,提供多场景实用代码示例与性能优化建议。
一、核心方法:使用 str.casefold() 进行标准化比对
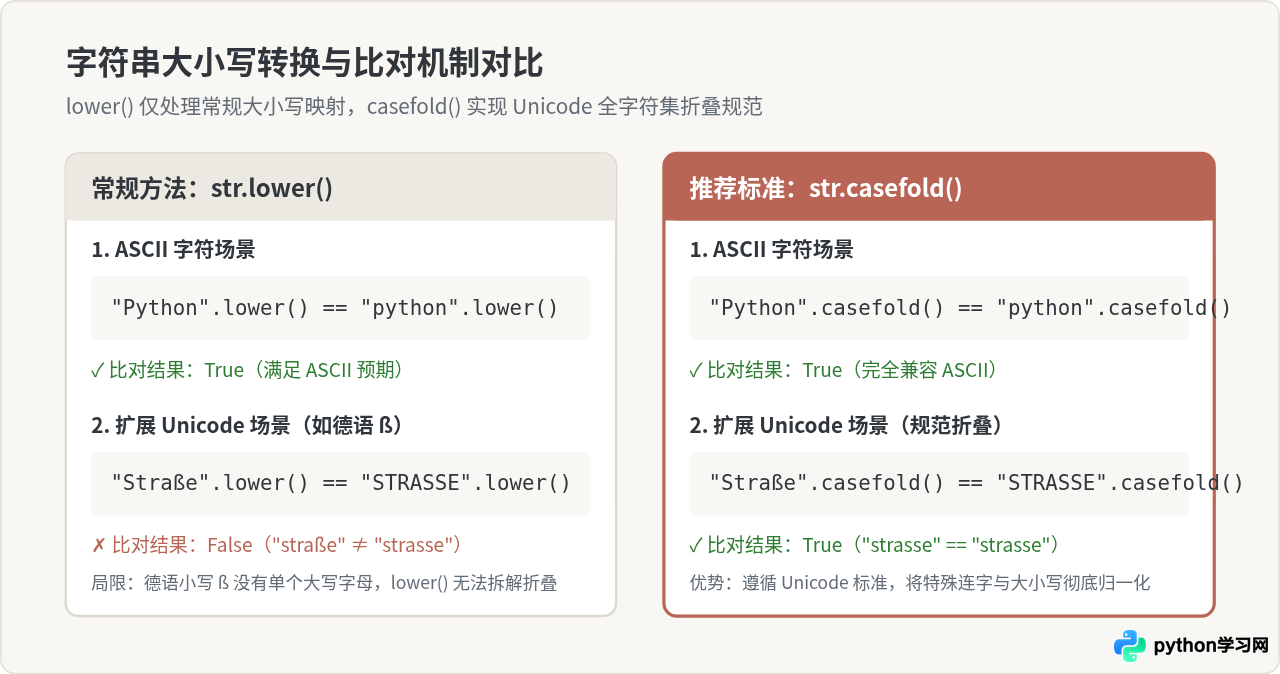
在 Python 3 中,字符串是 Unicode 编码的。许多开发者习惯通过把两端文本都转换为小写(s1.lower() == s2.lower())来比对文本,这种方式在纯 ASCII 英文场景下能够正常工作,但面对国际化字符时可能产生意外的判定失误。
Python 官方推荐的标准解法是 str.casefold()。该方法是“强力版”的转换为小写操作,旨在消除字符集中所有的大小写区别,是进行无关大小写比对(caseless matching)的标准手段。
# 基础用法示例
str1 = "Python"
str2 = "python"
str3 = "PYTHON"

# 使用 casefold 进行直接比对
is_equal_1 = str1.casefold() == str2.casefold()
is_equal_2 = str2.casefold() == str3.casefold()

print("str1 与 str2 比较结果:", is_equal_1)  # 输出示例: True
print("str2 与 str3 比较结果:", is_equal_2)  # 输出示例: True
无论是大写、小写、大小写混杂,经过 casefold() 处理后,都会统一收敛到相同的基础字符形态。这一过程具有确定性,非常适合作为所有文本判定逻辑的默认前置处理。
二、深入剖析:为什么推荐 casefold() 而非 lower()
很多开发者会有疑问:既然 lower() 也能把 'A' 变成 'a',为什么 Python 还要单独设计一个 casefold()?
关键差异在于 Unicode 字符集的复杂映射规则。在英语中,大写与小写字母是一一对应的(如 A 对 a)。但在其他语种中,字符之间可能存在一对多或位置上下文映射:
- 德语小写字母“ß”(Eszett):大写写作“SS”。调用
"Straße".lower()时,由于 ß 本身已经是小写形态,lower()不做任何变动,得到"straße";而"STRASSE".lower()得到"strasse"。两者用lower()比对会得出False。而casefold()依据 Unicode 规范将“ß”直接折叠为“ss”,从而成功判定两者等价。 - 希腊字母“Σ”(Sigma):大写字母 Σ 在词中写作小写“σ”,但在词尾写作“ς”。使用
lower()会保留词尾和词中的形态差别,而casefold()会将它们统一转换为规范小写,避免比对出现假阴性。
# Unicode 边界案例实测代码
german_word_1 = "Straße"
german_word_2 = "STRASSE"

# lower 结果为 False
print("lower 比对:", german_word_1.lower() == german_word_2.lower())      # False

# casefold 结果为 True
print("casefold 比对:", german_word_1.casefold() == german_word_2.casefold())  # True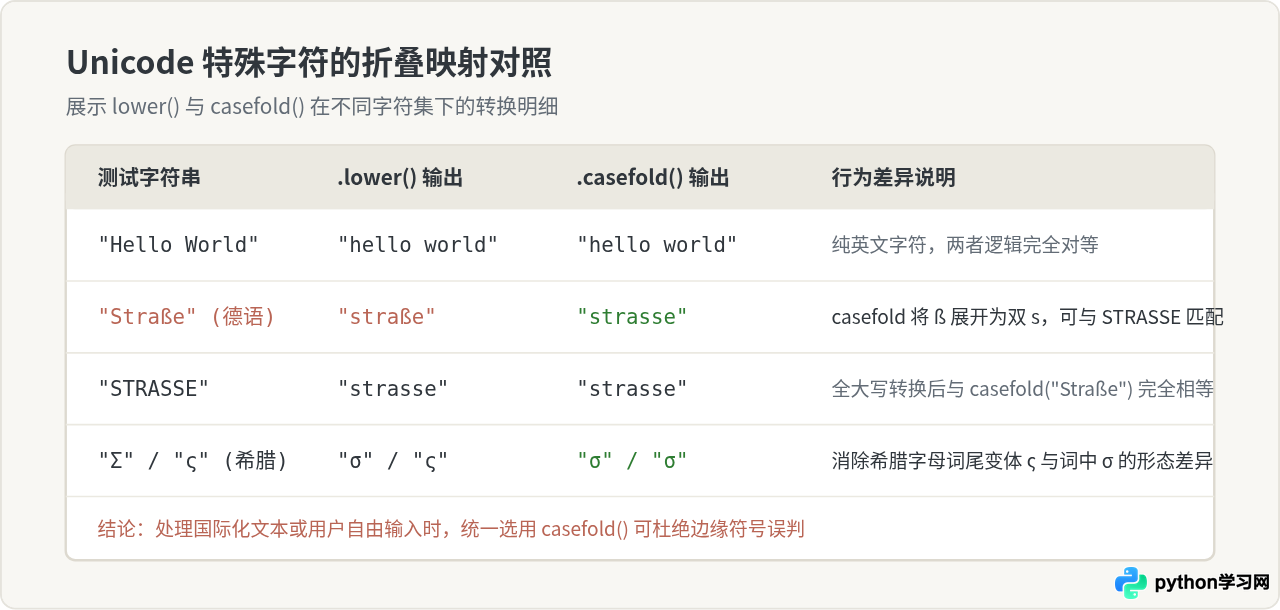
三、常见应用场景与操作步骤
在实际开发中,不区分大小写的比对往往不仅是两个独立变量相比较,还会结合输入清洗、成员检测、集合判断及排序。以下梳理四个最典型的使用场景。
1. 用户交互输入校验(带空白清理)
用户在终端或表单中输入命令(如 yes/no 或退出指令 exit)时,经常伴随偶发的大小写与首尾空格。标准的处理方式是将 strip() 与 casefold() 串联:
def check_confirm(user_input: str) -> bool:
    # 先清理首尾多余空白,再折叠大小写
    normalized = user_input.strip().casefold()
    return normalized in {"yes", "y"}

# 验证测试
print(check_confirm("  YES  "))  # 输出示例: True
print(check_confirm("y"))        # 输出示例: True
print(check_confirm("No"))       # 输出示例: False
2. 列表与集合中的包含检测(in 操作)
如果要判断某个变量是否属于白名单列表,但列表中元素大小写不一,建议预先构建一个全小写折叠的 set,查询性能为 $O(1)$:
allowed_roles = ["Admin", "Manager", "DEVELOPER"]

# 构建规范化的集合
normalized_roles = {role.casefold() for role in allowed_roles}

def is_role_allowed(role: str) -> bool:
    return role.strip().casefold() in normalized_roles

print(is_role_allowed("admin"))      # True
print(is_role_allowed("developer"))  # True
print(is_role_allowed("guest"))      # False
3. 忽略大小写排序(sorted 结合 key)
默认的 sorted() 按照 ASCII/Unicode 码位排,大写字母都在小写字母前面(如 'Z' 排在 'a' 前面)。若需自然词典顺序,直接将 str.casefold 作为 key 传入即可:
words = ["banana", "Apple", "cherry", "avocado"]

# 默认排序结果: ['Apple', 'avocado', 'banana', 'cherry']
# 大小写不敏感排序:
case_insensitive_sorted = sorted(words, key=str.casefold)
print("排序结果:", case_insensitive_sorted)
# 输出示例: ['Apple', 'avocado', 'banana', 'cherry']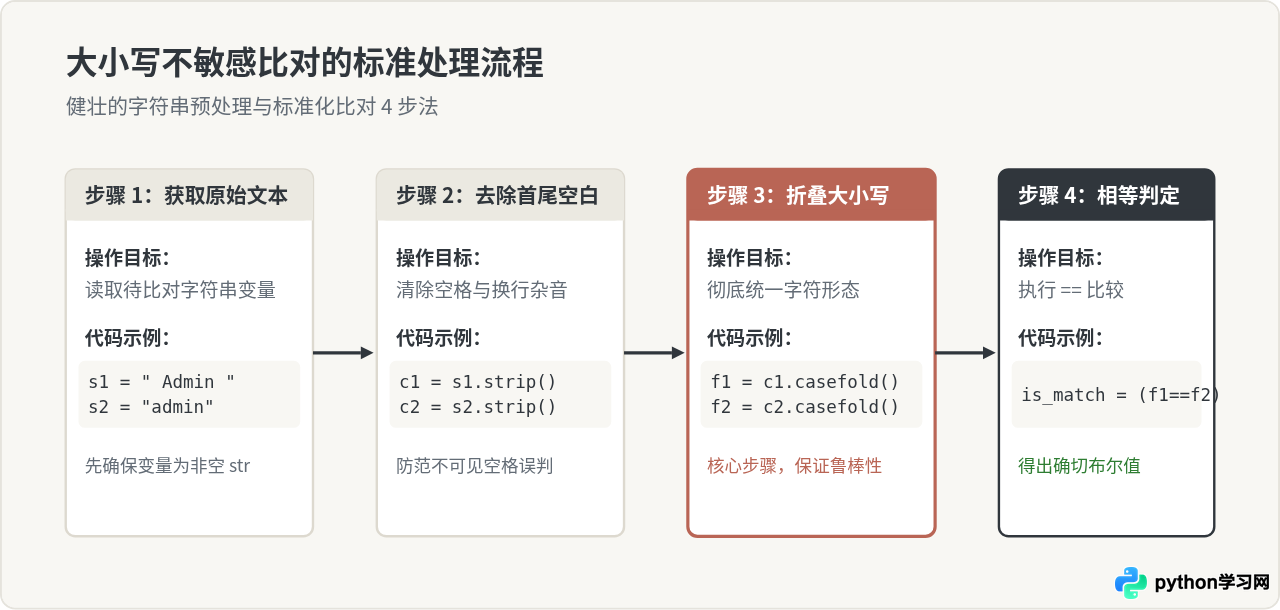
四、性能考量与注意事项
掌握了基本使用后,在实际工程应用中还需要注意以下几点边界情况与性能细节:
字符串的
casefold() 会在内存中分配新的字符串对象。如果在一个包含数万项的列表中进行逐项比较,不要在循环体中对目标变量重复调用:
# 低效做法:每次迭代都对 target 调用 casefold()
for item in large_list:
    if item.casefold() == target.casefold():  # target 被重复计算 N 次
        pass

# 高效做法:在循环外部提前折叠一次
target_folded = target.casefold()
for item in large_list:
    if item.casefold() == target_folded:
pass如果输入参数可能是
None 或数字等其他类型,直接调用 casefold() 会抛出 AttributeError。进行比对前应做好前置防守:
def safe_caseless_equal(a: str, b: str) -> bool:
    if a is None or b is None:
        return a == b
    if not isinstance(a, str) or not isinstance(b, str):
        return False
    return a.casefold() == b.casefold()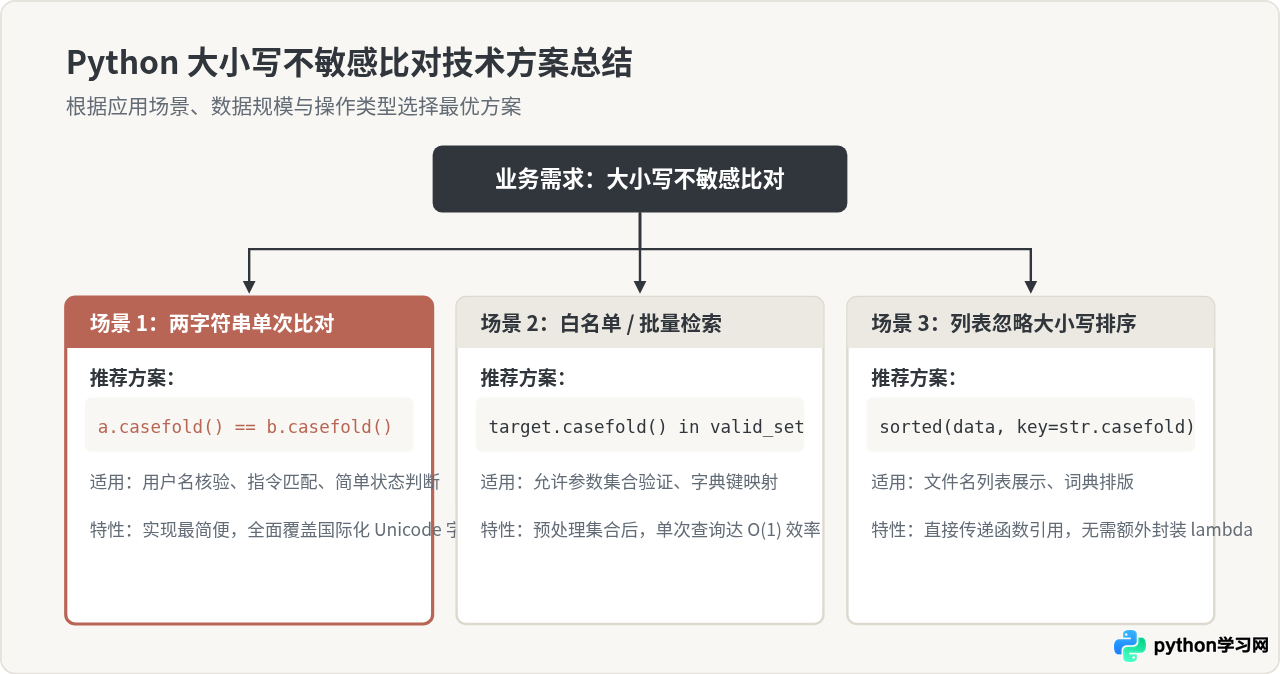
五、总结
在 Python 3 中实现大小写不敏感的字符串比较,结论非常清晰:
- 标准比对首选
casefold():直接使用str1.casefold() == str2.casefold()。这是官方定义的最严格、最稳健的大小写无关比对机制。 - 避免单纯依赖
lower():除非有明确保证所有数据输入仅限 ASCII 字符范围,否则lower()在处理特殊多语种符号时存在漏洞。 - 工程落地注意预处理与集合优化:配合
strip()消除空白干扰,面对大规模集合检索时,提前构建小写集合以保证程序运行的高性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















