


Python3.15新特性里哪些和数据分析性能相关?
深度解析 Python 3.15 中与数据分析性能密切相关的新特性,涵盖重构后的追踪式 JIT 编译器、无 GIL 自由线程与 abi3t 生态、显式延迟导入以及硬件级采样分析基础设施,帮助数据工程师与分析师客观理解收益边界与实操配置。
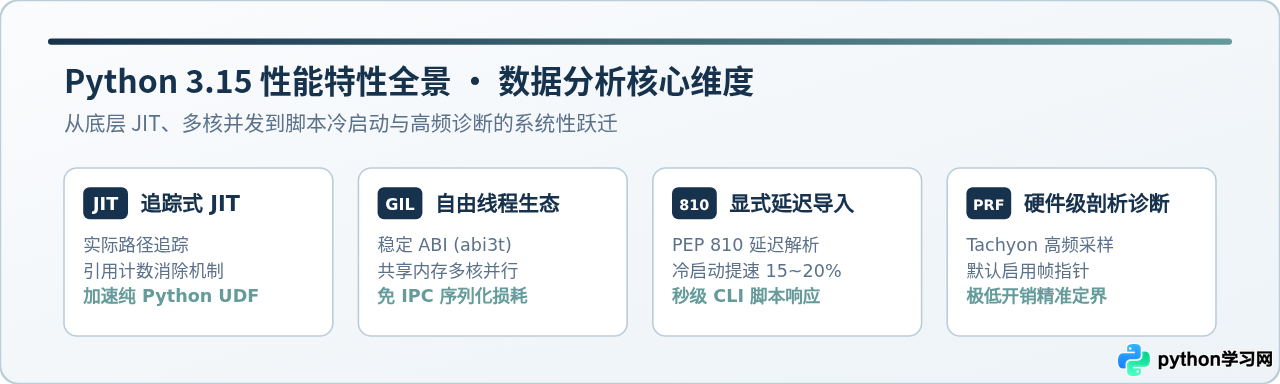
Python 3.15 在数据分析性能上的提升并非泛泛的宏观提速,而是精准切入数据流水线中长期存在的四大瓶颈:重构升级的追踪式 JIT 编译器大幅优化了 Pandas/Polars 无法向量化的纯 Python 逐行处理函数;走向生态成熟的自由线程(Free-Threading 与稳定 ABI abi3t)打破了 GIL 限制,彻底免除了多进程并发带来的高昂 IPC 内存拷贝;显式延迟导入(PEP 810)缩短了大型数据脚本与 CLI 工具 15%~20% 的冷启动时间;而内置硬件级高频分析器 Tachyon(PEP 799)与默认帧指针(PEP 831)则让微秒级管道性能排查无感化。
一、追踪式 JIT 编译器重构:加速未向量化的数据清洗热点
在数据分析工程中,我们通常推崇利用 NumPy、Pandas 或 Polars 的底层 C/SIMD 原生向量化算子。但在实际业务场景中,由于业务规则复杂、正则表达式多变或嵌套字典清洗需求,工程师不可避免地需要编写自定义函数(UDF),并通过 df['col'].apply(custom_func) 或标准 for 循环进行处理。在过去,这类纯 Python 逻辑是整个数据分析管道中最严重的性能热点。
Python 3.13 引入的早期 JIT 采用了较为初级的模板拼接与路径推测机制,在许多通用基准测试中收益有限。而 Python 3.15 对 JIT 进行了关键的技术重构,引入了基于真实执行轨迹的追踪前端(Tracing Frontend):
- 执行路径真实记录:JIT 不再机械地对整段字节码进行推测转换,而是在解释器运行过程中捕获代码实际高频走过的控制流路径,并将整条热点路径视作一个独立的编译单元。
- 引用计数消除(Refcount Elimination):Python 过去每个局部变量的读写都伴随着大量的
Py_INCREF和Py_DECREF内存读写。在数据循环体内,3.15 的追踪前端能够静态证明大量临时对象在循环生命周期内不会逃逸,从而直接消除了这些冗余的内存总线通信。 - 就地整型与浮点优化:针对数据清洗中常见的标量转换、累加计算与条件阈值判断,解释器直接利用原生硬件寄存器完成求值,绕过了频繁的 Python 虚拟栈推栈出。
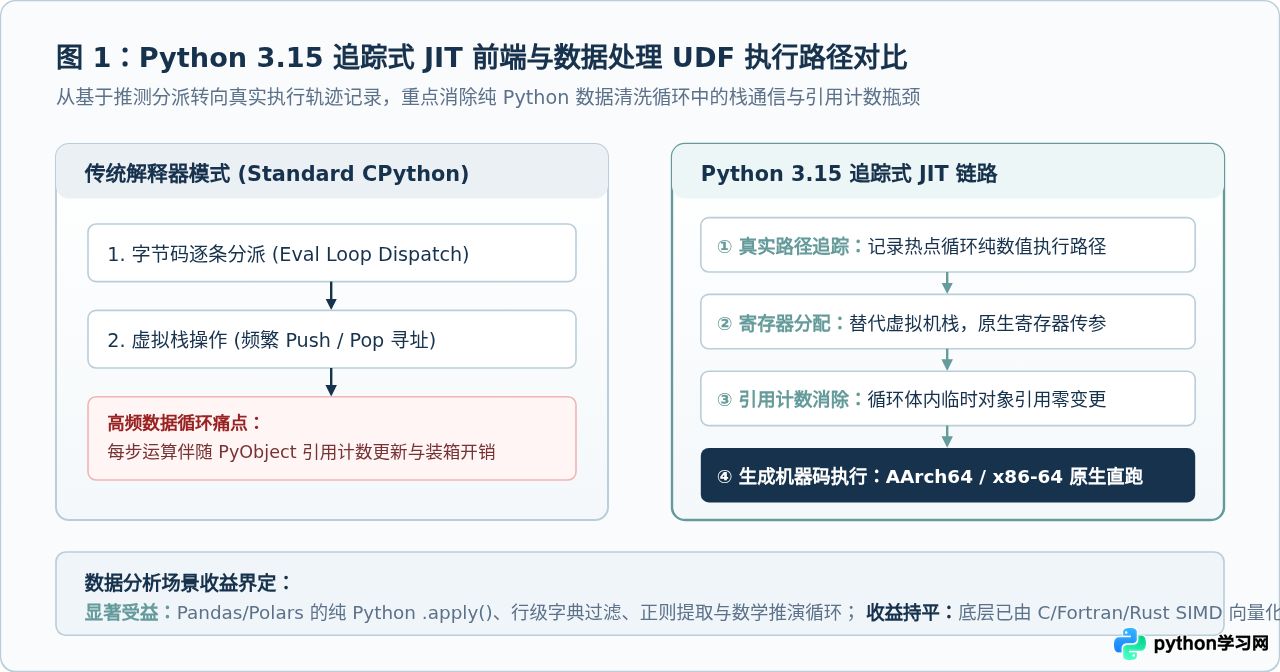
必须明确:如果你的数据任务核心是矩阵乘法、大型数组点积或原生 Polars 表达式计算,这些计算早已完全在底层的 BLAS、LAPACK、Rust 核心或 C 扩展中以 SIMD 指令执行,Python 本身仅负责一次函数分派。对于这部分计算,JIT 不会带来额外的叠加加速。JIT 真正的用武之地,是那些无法被向量化覆盖的行级数据清洗逻辑与复杂对象转换。
二、自由线程与 abi3t:多核并行从“多进程拷贝”转向“共享内存零拷贝”
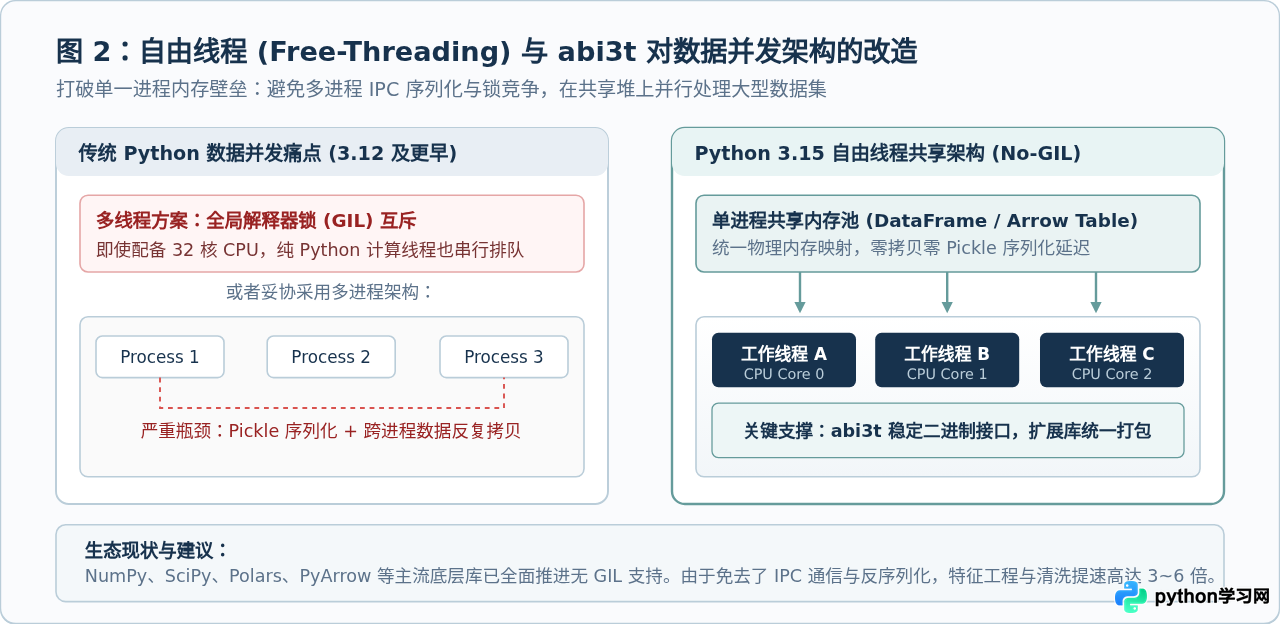
数据分析通常具备极高的 CPU 密集型特征(如特征工程、离群点清洗、统计推断)。在过去,受制于全局解释器锁(GIL),工程师若想吃满机器的 32 核或 64 核 CPU,唯一稳妥的方案是使用 multiprocessing 或基于进程池的框架。
然而,多进程模型在处理大规模数据时有着沉痛的代价:主进程中的海量 DataFrame 必须经过 pickle 序列化,通过 IPC 管道复制给子进程,子进程处理后再序列化返回。这往往导致内存占用瞬间翻倍甚至 OOM,且序列化耗时甚至压过了实际计算收益。
Python 3.15 在自由线程(Free-Threading,即完全移除 GIL 的构建)上迈出了具有里程碑意义的步伐:
- 稳定 ABI 接口
abi3t正式落地:此前没有 GIL 版本的最大阻碍是生态碎片化——C 扩展库必须为每个 Python 次要版本单独编译专门的无 GIL 轮子(wheel)。3.15 确立了abi3t标准,主流科学计算库(NumPy、SciPy、PyArrow、Polars 等)可以使用同一套扩展二进制长期兼容,数据科学核心生态的基本盘完成并轨。 - 多核零拷贝共享内存:在 Python 3.15 的无 GIL 线程池中,多个工作线程可以同时访问同一块物理内存映射的 DataFrame 或 Apache Arrow 表结构,各自执行独立的纯 Python 行级处理,彻底消除了数据跨进程复制的开销。
- 默认平台支持推进:官方 macOS 安装包及主流 Linux 发行版构建直接提供开箱即用的自由线程支持,降低了此前需要手动拉源码配置
--disable-gil重新编译的门槛。
三、显式延迟导入(PEP 810):秒级降低大型数据脚本与 CLI 冷启动耗时
对于需要频繁在终端运行的数据抽取脚本、离线报表生成器或批处理微服务而言,启动等待时间直接影响工程效率。传统 Python 脚本开头往往罗列着一整页重量级导入:
# 传统导入方式:一次性阻塞加载数百个底层文件与编译单元
import pandas as pd
import scipy.stats as stats
import matplotlib.pyplot as plt
import torch
仅仅完成上述模块的解析、抽象语法树构建与顶层代码执行,就需要耗费 800ms 到 2s 不等的冷启动时间。如果某个脚本本次运行只是查询一个简单的状态标志,这种加载开销便纯属浪费。
Python 3.15 正式引入了 PEP 810 显式延迟导入语法(Explicit Lazy Imports):
# Python 3.15 显式延迟导入语法
lazy import pandas as pd
lazy import torch

def process_batch(data_source: str):
    # 只有当代码真正执行到此行,访问 pd 的属性时,才会触发 pandas 的动态加载
    df = pd.read_parquet(data_source)
    return df.shape
通过 lazy import 声明的模块,其 AST 生成与字节码导入将被挂起为一个轻量占位代理。只有在运行时该符号首次被属性访问、调用或解包时,解释器才会即时完成解析。官方基准显示,在依赖丰富的数据应用中,冷启动开销普遍下降了 15%~20%,这对于需要密集调度轻量容器实例的批处理集群极具价值。
四、低开销诊断:Tachyon 采样分析器(PEP 799)与默认帧指针(PEP 831)
在大型数据流水线发生性能劣化时,排查性能瓶颈往往比优化本身更耗费精力。传统分析工具存在明显的“观测者效应”:
- 使用
cProfile:通过事件钩子拦截每一次函数调用,导致原本耗时 10 秒的数据管道可能暴增至 60 秒以上,高频调用的微秒级微小函数时间被严重扭曲。 - 使用系统级工具(如 Linux
perf):由于过去 Python 默认未开启帧指针(Frame Pointers),系统调试器在展开解释器混合栈时经常丢帧,无法准确指认 Python 业务源码层面的瓶颈行。
Python 3.15 提供了两项底层运行时的诊断支撑,改变了数据流水线的监控体验:
- Tachyon 统计采样分析器(PEP 799):利用硬件性能计数器以固定的微秒周期进行统计快照采样。由于无需注入每个函数的进入退出事件,其运行时损耗通常低于 1%,可以在准生产环境直接观测长耗时数据转换管道。
- 全平台默认启用帧指针(PEP 831):在主流 64 位平台默认保留
RBP/X29帧指针寄存器。系统级分析器(如perf、eBPF 工具或 macOS Instruments)可以直接无损还原“C++ 数据引擎 ↔ Python 胶水层”的完整调用拓扑图。
五、实操指南:性能特性的接入与验证工作流
充分发挥 Python 3.15 在数据任务中的性能红利,需要遵循清晰的配置与验证流程。以下提供标准化的四步落地指南:
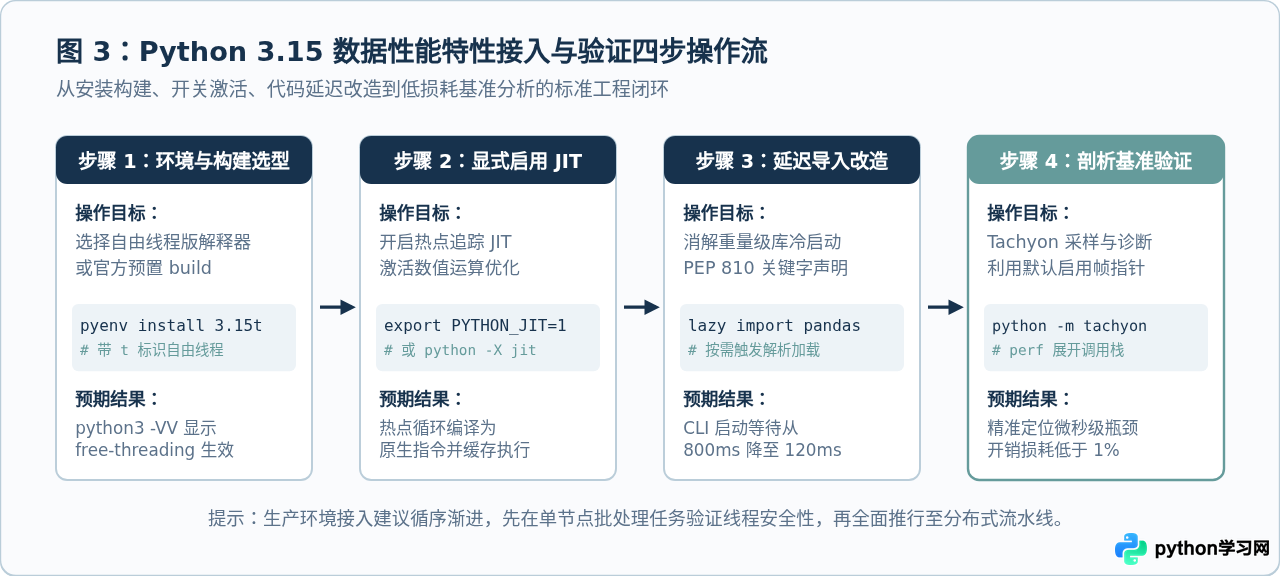
1. 部署具备自由线程能力的运行环境
在类 Unix 环境或 macOS 上,可以通过版本管理工具安装带有 t 后缀的自由线程预编译发行版:
# 示例:通过 pyenv 安装并切换至 3.15 自由线程版
pyenv install 3.15.0t
pyenv local 3.15.0t

# 验证当前解释器是否启用了自由线程
python3 -c "import sys; print('Free-threading enabled:', getattr(sys, '_is_gil_enabled', lambda: True)() is False)"
2. 显式开启追踪 JIT 编译器
在 Python 3.15 中,JIT 仍保持为可控的环境开关。在运行数据分析任务前,通过环境变量或启动标志将其激活:
# 方式 A:通过环境变量全局激活 JIT
export PYTHON_JIT=1
python3 run_etl_pipeline.py

# 方式 B:针对单次任务使用 -X 参数启动
python3 -X jit run_etl_pipeline.py
3. 在并发代码中利用线程池替代进程池
在以往受 GIL 限制的代码中,数据工程常使用 ProcessPoolExecutor。而在无 GIL 的 3.15 环境中,可直接迁移至 ThreadPoolExecutor,从而共享同一个大型数据上下文:
from concurrent.futures import ThreadPoolExecutor
import pandas as pd

# 在内存中保留单一大型数据集,各线程并行运行自定义清洗逻辑
def parallel_clean(df_chunk: pd.DataFrame) -> pd.DataFrame:
    # 模拟复杂的纯 Python 数据行提取
    def parse_payload(val):
        if not val or not isinstance(val, str):
            return 0
        return sum(ord(c) for c in val) % 97

    df_chunk['metric'] = df_chunk['raw_text'].apply(parse_payload)
    return df_chunk

def execute_pipeline(large_df: pd.DataFrame):
    chunks = [large_df.iloc[i::8] for i in range(8)]
    with ThreadPoolExecutor(max_workers=8) as executor:
        results = list(executor.map(parallel_clean, chunks))
    return pd.concat(results)
4. 运行低损耗基准分析
在测试环境中,可以结合内置的性能分析工具观测函数耗时分布:
# 启用 Tachyon 高频采样,并输出统计报告
python3 -m tachyon --output=profile.json run_etl_pipeline.py
六、综合总结与技术选型决策矩阵
理解 Python 3.15 的性能新特性,最核心的原则是明晰各自的适用边界。没有一项技术能无差别地加速所有维度的代码。下表梳理了数据分析场景中的特性匹配矩阵:
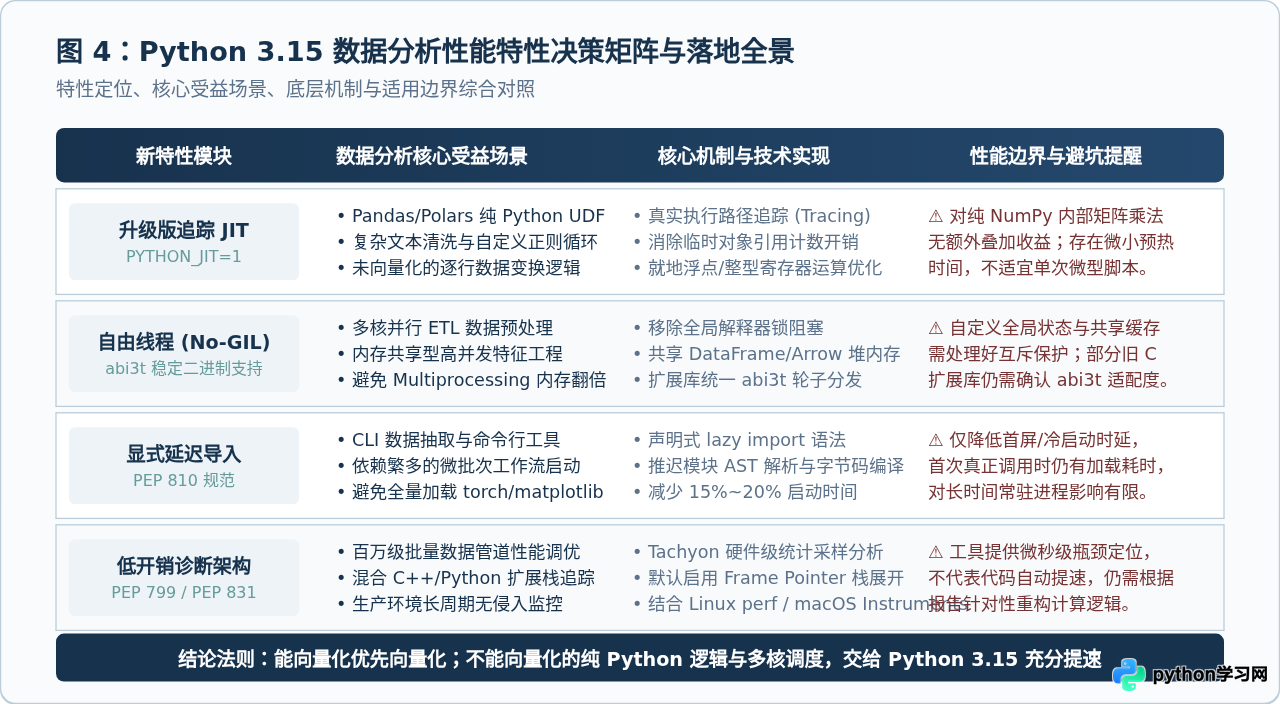
在数据分析工程中,最佳实践依然是“优先选择向量化计算”。当面对业务中无法被底层 C/Rust 向量化完全覆盖的个性化清洗逻辑、高维树形遍历、行级 UDF 以及需要多核协同清洗的超大型内存集时,Python 3.15 提供的追踪式 JIT、无 GIL 自由线程生态、延迟导入与硬件级采样诊断,构筑了自 Python 3.0 以来最具实质性突破的高性能底层底座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















