


Python程序设计基础语法详解:变量、循环与函数
深入解析Python程序设计核心基础语法:系统剖析变量与内存对象绑定机制、for与while循环执行控制流,以及函数定义、参数传递与LEGB作用域规则。
编写任何 Python 程序的核心,本质上是在解决三个基本问题:如何存储与标记计算状态、如何对批量或未知次数的数据执行重复操作,以及如何将重复逻辑封装为可复用的独立单元。这三个问题分别对应 Python 基础语法的三大核心支柱——变量、循环与函数。本文将直接从底层运行机制、语法规范、代码示例与实际避坑要点四个维度展开,帮助读者建立扎实可靠的 Python 基础认知体系。
一、变量与动态对象绑定机制
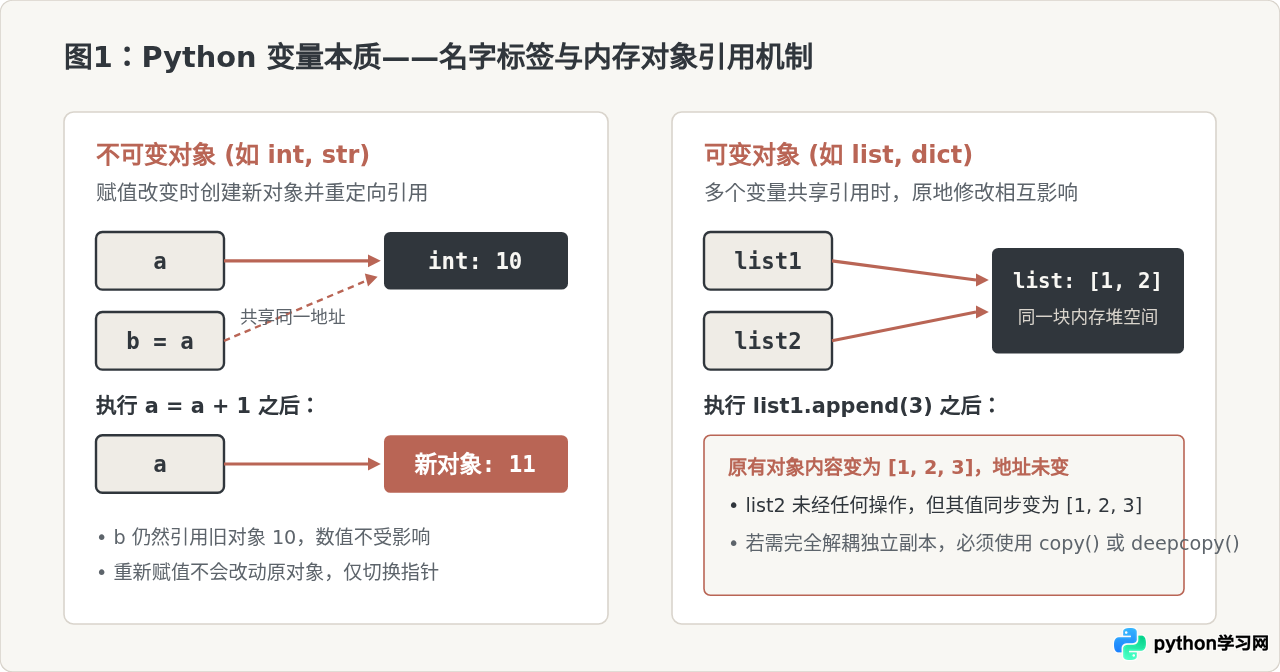
初学编程时,常有人将变量比作“存放数据的盒子”。但在 Python 中,这种比喻容易在后续的可变对象传参和赋值中引发严重误判。在 Python 的运行时模型中,变量不是内存容器,而是贴在内存对象上的标签引用(Reference)。
1. 动态类型与引用绑定
Python 是动态强类型语言。“动态”意味着变量本身没有固定的数据类型,它可以在不同时刻绑定不同类型的对象;“强类型”则意味着对象一旦创建,其类型和行为受到严格限制,解释器不会隐式发生不合法的跨类型计算(如字符串与整数相加)。
# 1. 变量绑定不同类型的对象
val = 100          # val 绑定到 int 对象
val = "hello"      # val 重新绑定到 str 对象,原 int 对象若无其他引用则被垃圾回收

# 2. 强类型保护
# "10" + 5 会直接抛出 TypeError: can only concatenate str (not "int") to str
result = int("10") + 5  # 必须显式类型转换
print("转换计算结果示例:", result)
# 示例输出: 转换计算结果示例: 15
2. 不可变对象与可变对象的引用差异
理解变量的关键在于区分对象是否可变(Mutable vs Immutable):
- 不可变对象(int、float、str、tuple、frozenset): 对象创建后其内部状态无法修改。对变量做累加或替换操作,本质上是创建了全新的对象,并将变量重新指向新对象。
- 可变对象(list、dict、set): 可以在原有内存地址上直接修改内容(如
append()或键值赋值)。如果多个变量指向同一个可变对象,其中一个变量的原地修改会直接影响所有关联变量。
3. 变量命名规范与避坑要点
编写规范的 Python 代码时,应严格遵循 PEP 8 命名规范:
- 变量与函数名: 采用全小写字母加下划线风格(
snake_case),如user_retry_count。 - 常量名: 采用全大写字母加下划线风格(
UPPER_CASE),如MAX_BUFFER_SIZE = 1024。 - 禁止覆盖内置名称: 切勿使用
list、dict、str、type或id作为变量名。一旦覆盖,后续代码调用相应内置类型转换时将引发不可预期的类型冲突。
二、循环控制流:for 与 while 的执行机制
循环负责自动化地处理重复任务。Python 提供了两种主要的循环结构:基于迭代协议的 for 循环,以及基于布尔条件驱动的 while 循环。
1. for 循环与可迭代协议
与其他语言中基于下标递增的传统循环不同,Python 的 for 循环本质上是一个迭代器消费者。它依次从可迭代对象(Iterable)中获取元素,直至触发 StopIteration 异常自动退出。
# 1. 遍历常用序列
fruits = ["apple", "banana", "cherry"]
for index, fruit in enumerate(fruits, start=1):
    print(f"序号 {index}: {fruit}")

# 2. range() 数值区间生成
# range(start, stop, step) 是一个惰性计算对象,不一次性生成全部列表
total = 0
for i in range(1, 101):  # 计算 1 到 100 的累加和
    total += i
print("1到100累加和:", total)
# 示例输出: 1到100累加和: 5050
2. while 循环与退出条件
while 循环在条件表达式为 True 时持续执行。由于其循环次数通常无法静态预知,因此必须保证循环体内存在明确能够让测试条件变为 False 的状态更新代码,否则会陷入无休止的死循环。
# 安全的递减计数
retry_remaining = 3
while retry_remaining > 0:
    print(f"正在尝试连接服务器,剩余重试次数: {retry_remaining}")
    # 模拟操作并显式步进更新状态
    retry_remaining -= 1
print("连接流程结束")
3. 循环控制关键字:break、continue 与 else 子句
Python 循环中控制流转移的规则如下:
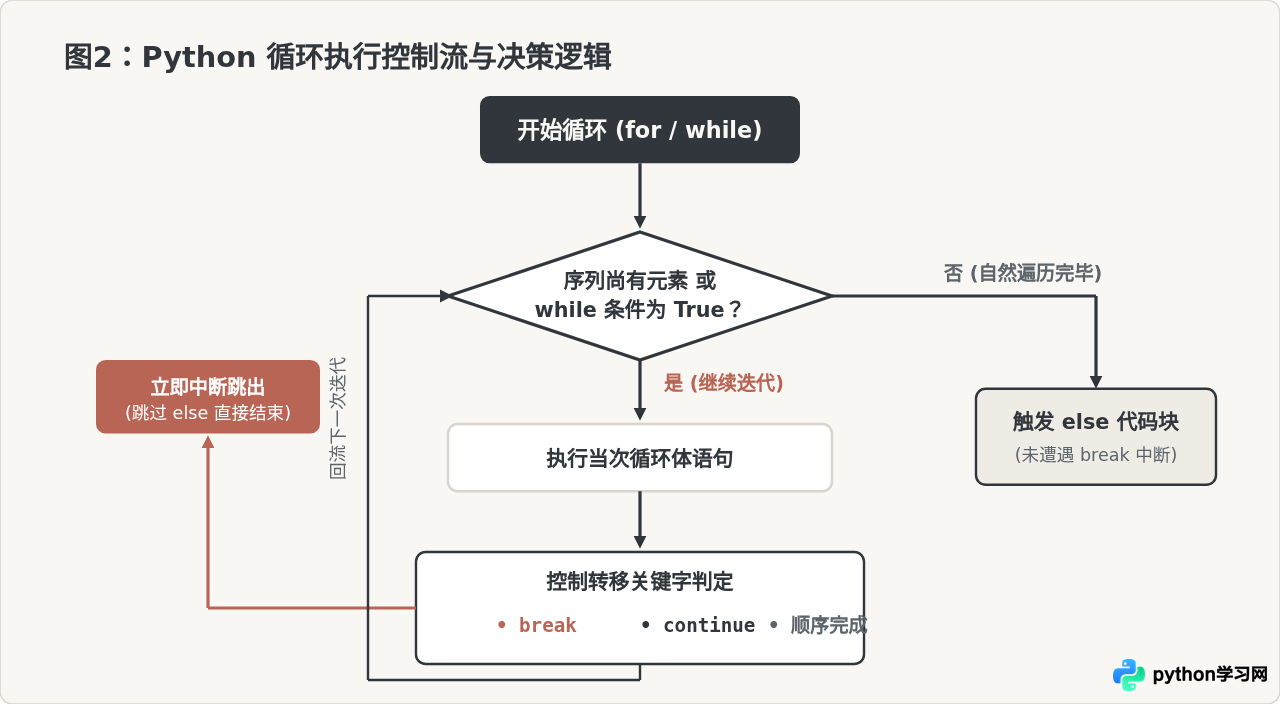
break:立即终止并永久跳出当前层级的整个循环,未执行的后续迭代全部作废。continue:立即跳过本次迭代循环体中尚未执行的代码,直接返回循环头部进行下一次迭代条件判定。else 子句:这是 Python 独具特色的控制语法。只有当循环正常耗尽全部元素(for 循环)或条件变为 False 正常终止(while 循环)时,else 块才会执行;若循环由 break 提前跳出,else 块将被严格跳过。 这一特性常用于“在序列中搜索目标,未找到时执行备选逻辑”的场景。
避坑指南:遍历中修改列表的陷阱
在 for item in my_list: 运行期间,切勿直接调用 my_list.remove(item) 或 my_list.pop()。修改列表会实时变更底层数组的索引偏移,导致迭代指针错位,从而静默漏掉部分元素。若需过滤列表,推荐使用列表推导式 my_list = [x for x in my_list if condition],或显式迭代其浅拷贝 for item in my_list[:]:。
三、函数设计与作用域机制
函数是 Python 代码组织与逻辑复用的基本构件。通过 def 关键字定义函数,开发者可以将输入参数(形参)、执行逻辑与输出结果(返回值)严格隔离为黑盒模块。
1. 函数定义与返回值规范
在 Python 中,函数如果没有显式书写 return,或者单独执行了不带表达式的 return,解释器将隐式返回内置单例对象 None。当函数需要返回多个数据时,Python 支持逗号分隔的写法,其底层会自动打包为一个 tuple 元组,调用端可以直接通过序列解包接收。
def calculate_statistics(numbers):
    """计算列表的极值与平均值"""
    if not numbers:
        return 0, 0, 0.0  # 安全防御空输入
    min_val = min(numbers)
    max_val = max(numbers)
    avg_val = sum(numbers) / len(numbers)
    return min_val, max_val, avg_val  # 打包返回三元组

# 调用端直接解包
lowest, highest, mean = calculate_statistics([12, 45, 68, 23, 90])
print(f"最小值: {lowest}, 最大值: {highest}, 平均值: {mean:.2f}")
# 示例输出: 最小值: 12, 最大值: 90, 平均值: 47.60
2. 参数传递的全景顺序
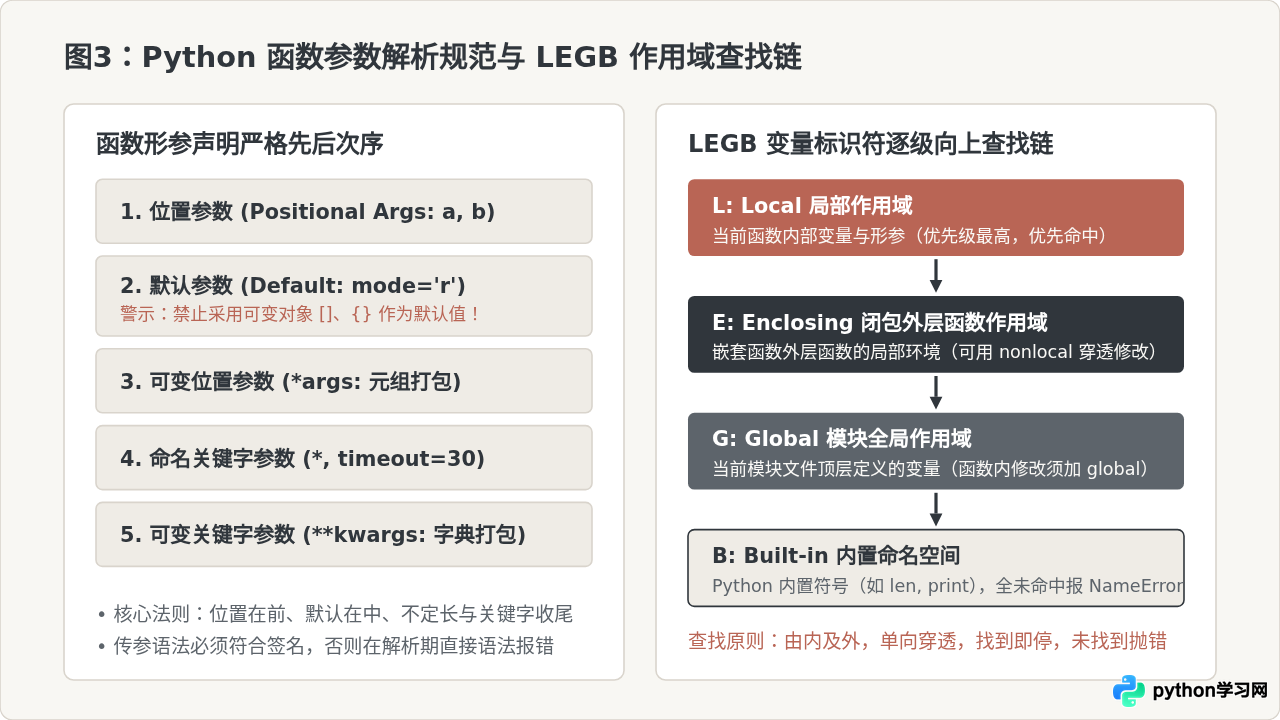
Python 提供了极具弹性的参数系统。在定义和调用函数时,参数必须严格遵守固定先后顺序:
- 位置参数(Positional Arguments): 按照形参声明的相对位置进行严格对齐传参。
- 默认参数(Default Arguments): 赋予了缺省值的形参,必须紧跟在位置参数之后。
- 可变位置参数(*args): 将多余传入的位置参数打包收集为一个元组(tuple)。
- 命名关键字参数(Keyword-Only Arguments): 位于单独的
*或*args之后,调用时必须显式指定参数名赋值。 - 可变关键字参数(**kwargs): 将多余传入的形如
key=value的键值对参数打包收集为一个字典(dict)。
致命陷阱:默认参数禁止使用可变对象!
Python 函数的默认参数在 def 语句初次被解释器编译加载时仅求值并创建一次,而不是在每次调用时重新生成。如果将 def append_item(data=[]) 中的默认值设为列表,多次调用时将永久共享同一个列表对象,导致数据隐蔽污染。正确的做法是使用不可变的 None 作为哨兵,并在函数内部动态初始化:
# 错误范式(不要这样做):
# def bad_collect(item, storage=[]):
#     storage.append(item)
#     return storage

# 正确规范范式:
def safe_collect(item, storage=None):
    if storage is None:
        storage = []  # 每次调用动态独立创建全新列表
    storage.append(item)
    return storage

print("第一次调用:", safe_collect("A"))
print("第二次调用:", safe_collect("B"))
# 示例输出:
# 第一次调用: ['A']
# 第二次调用: ['B']
3. LEGB 变量查找与作用域机制
在函数内引用一个变量名时,Python 解释器会严格遵循 LEGB 查找规则,自内向外在四个命名空间中逐级搜索,一旦命中立即停止,若穷尽四个层次仍未找到则抛出 NameError:
- L (Local): 函数内部定义的局部变量及形参。生命周期随函数调用结束而销毁。
- E (Enclosing): 嵌套函数中外层非全局函数的局部环境(常用于闭包与装饰器)。若需在外层修改该变量,需使用
nonlocal声明。 - G (Global): 当前 Python 模块文件(.py)顶层定义的全局变量。若需在函数内部对全局变量重新赋值绑定,必须使用
global关键字。 - B (Built-in): Python 内置命名空间,包含
len、print、range等预设函数与异常类。
四、综合实践:三要素联动与全景避坑总结
为了让读者直观理解变量管理、循环控制与函数封装如何协同工作,我们实现一个典型的实际开发场景:电商批量交易订单的数据清洗、汇兑与风险排查工具。
# 汇率基准常量(模块全局作用域)
EXCHANGE_RATE = 7.2  # 1 美元折合人民币

def process_single_order(order_data, min_threshold=100.0, **extra_rules):
    """
    清洗并校验单笔订单(函数封装与参数弹性匹配)
    """
    order_id = order_data.get("id")
    usd_amount = order_data.get("amount", 0.0)

    # 局部变量计算
    cny_amount = round(usd_amount * EXCHANGE_RATE, 2)
    is_vip = extra_rules.get("vip_client", False)

    # 状态判断逻辑
    if cny_amount < min_threshold:
        return None  # 过滤小额杂音数据

    return {
        "order_id": order_id,
        "cny_amount": cny_amount,
        "is_vip": is_vip,
        "status": "APPROVED"
    }

def batch_audit_orders(orders_list):
    """
    批量清洗与循环控制流联动
    """
    approved_records = []

    for item in orders_list:
        # 1. 遇到明确作弊特征,利用 continue 立即跳过
        if item.get("blacklisted", False):
            continue

        # 2. 模拟遇到紧急熔断标记,使用 break 彻底中断批量执行
        if item.get("emergency_halt", False):
            print(f"警报:订单 {item.get('id')} 触发紧急熔断,立即终止后续批处理!")
            break

        # 3. 函数调用与变量状态记录
        result = process_single_order(item, min_threshold=500.0, vip_client=item.get("vip", False))
        if result is not None:
            approved_records.append(result)
    else:
        # 4. 只有在未触发 emergency_halt 正常完成全部遍历时执行
        print("所有待审核订单已平稳处理完毕,无突发中断。")

    return approved_records

# 测试数据
raw_orders = [
    {"id": "ORD-101", "amount": 20.0, "blacklisted": False},          # 金额折合 144 元,将被阈值过滤
    {"id": "ORD-102", "amount": 150.0, "vip": True},                  # 金额折合 1080 元,正常通过
    {"id": "ORD-103", "amount": 300.0, "blacklisted": True},          # 黑名单,continue 跳过
    {"id": "ORD-104", "amount": 200.0, "vip": False}                  # 金额折合 1440 元,正常通过
]

verified_list = batch_audit_orders(raw_orders)
print(f"最终入库合格单据数量: {len(verified_list)}")
for record in verified_list:
    print(" ", record)

# 示例输出:
# 所有待审核订单已平稳处理完毕,无突发中断。
# 最终入库合格单据数量: 2
#   {'order_id': 'ORD-102', 'cny_amount': 1080.0, 'is_vip': True, 'status': 'APPROVED'}
#   {'order_id': 'ORD-104', 'cny_amount': 1440.0, 'is_vip': False, 'status': 'APPROVED'}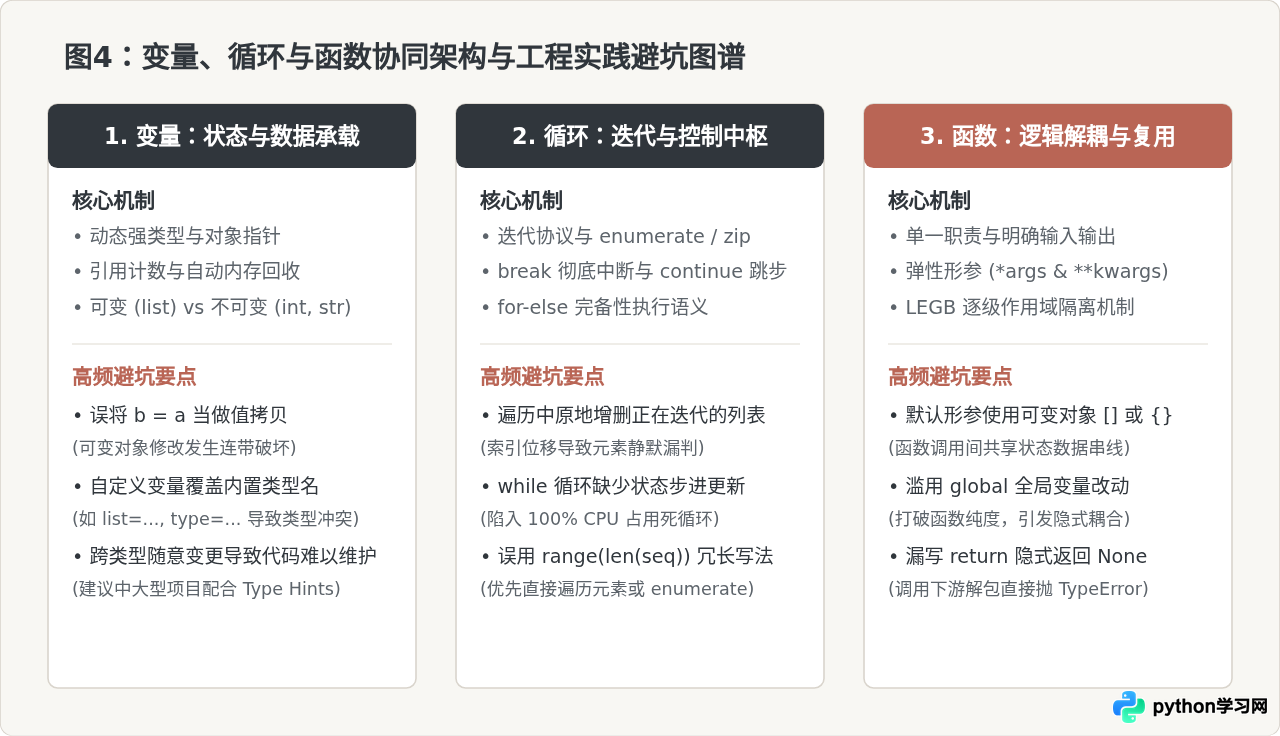
归纳而言,在 Python 程序设计中:数据状态通过变量进行精确绑定与引用管理,业务流程由循环执行高效驱动与条件转移,核心业务逻辑则通过纯粹、无副作用的函数完成解耦与封装。 理解并贯彻这三者的底层运作机理,是写出优雅、高效且健壮的 Python 代码的必备根基。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















