


python必背源代码列表推导式代码怎么写
全面讲解Python列表推导式的核心语法格式、基础必背代码、单条件过滤、if-else三元映射、多层嵌套扁平化以及实战模板与常见认知误区辨析。
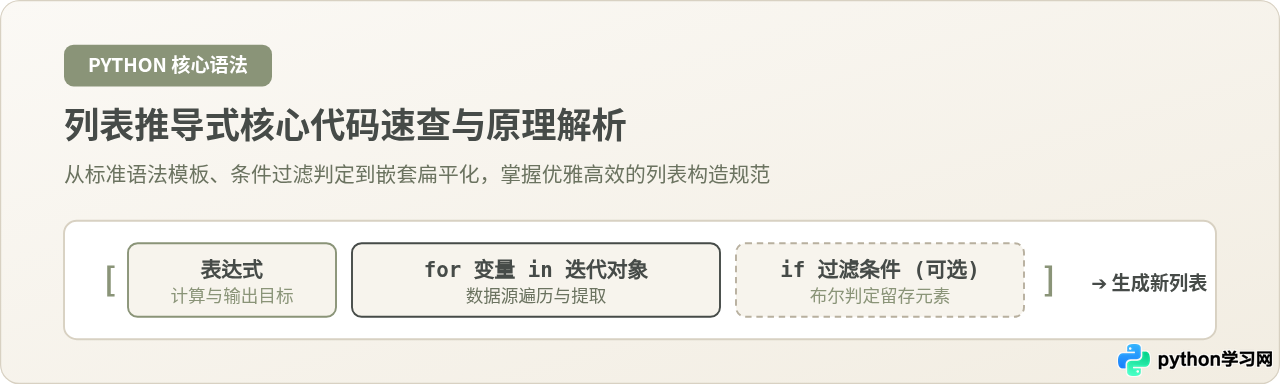
[表达式 for 变量 in 可迭代对象],也可以在末尾追加 if 条件 进行元素过滤。它用一行声明式代码替代了传统的“定义空列表、for 循环迭代、调用 append 方法”三步流程,在保持良好可读性的同时具有更高的底层字节码执行效率。
一、基础语法结构与标准写法
编写列表推导式的核心在于理清三个基础部分:外部包裹的方括号 []、最左侧计算并产出结果的表达式(Expression),以及右侧负责提供数据的 for 循环子句。
在很多初学者的传统认知中,构建新列表往往需要声明一个结果变量,再利用 for 循环逐个推进。我们通过一个具体的对比示例来看列表推导式的精简过程:
# 方式一:传统 for 循环写法(需要 4 行代码)
numbers = [1, 2, 3, 4, 5]
squares = []
for n in numbers:
    squares.append(n ** 2)

# 方式二:标准列表推导式写法(仅需 1 行代码)
squares = [n ** 2 for n in numbers]

# 示例输出:
# squares -> [1, 4, 9, 16, 25]
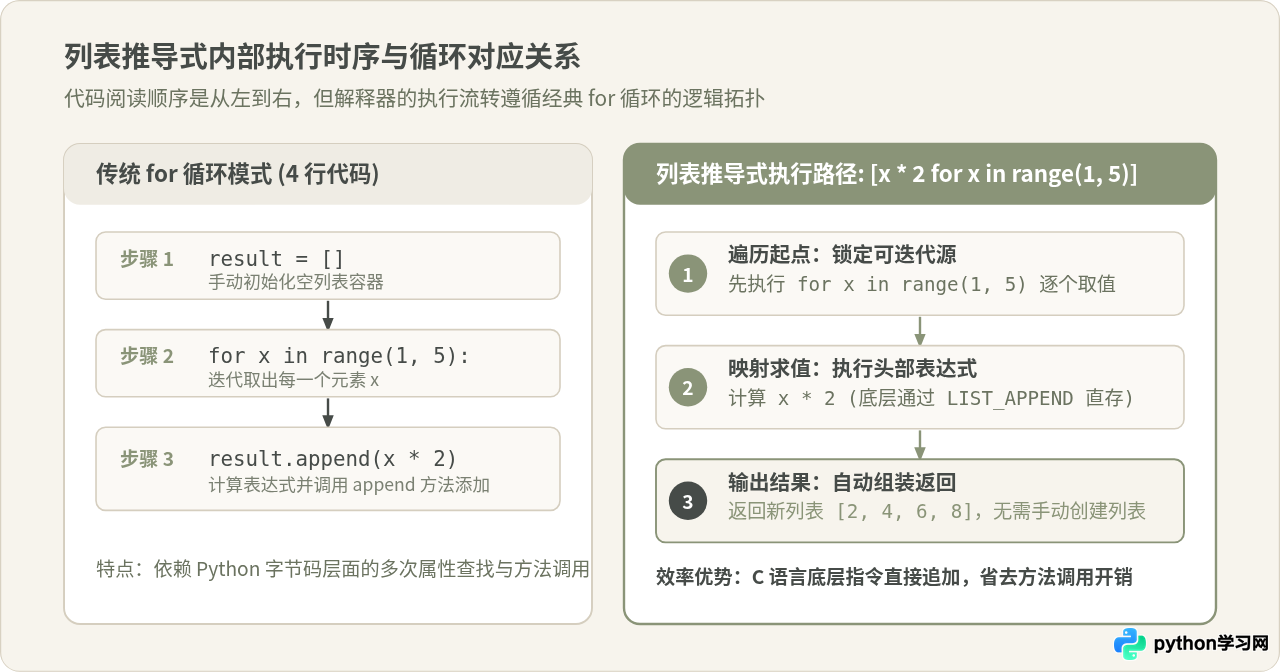
执行列表推导式时,Python 解释器的实际运算时序是:首先进入 for n in numbers,从迭代源中取出一个元素 n;随后执行左侧的 n ** 2 求得平方值;最后自动由底层的 LIST_APPEND 指令存入新生成的列表。循环往复直到序列遍历完毕。
除了基础的数学运算,左侧的表达式可以是任意合法的 Python 表达式,例如调用方法、类型转换或字符串格式化:
# 字符串转整型与去除前后空格
raw_data = ["  10 ", " 25", "99 "]
clean_numbers = [int(item.strip()) for item in raw_data]

# 示例输出:
# clean_numbers -> [10, 25, 99]
二、条件过滤写法:单 if 与 if-else 的位置差异
在实际开发中,我们往往不需要保留原列表中的全部元素,或者需要根据不同条件产出不同的值。这时候就必须在推导式中引入 if 语句。初学者最容易混淆的是:为什么有时候 if 写在最后,有时候 if 必须写在前面并且带上 else?
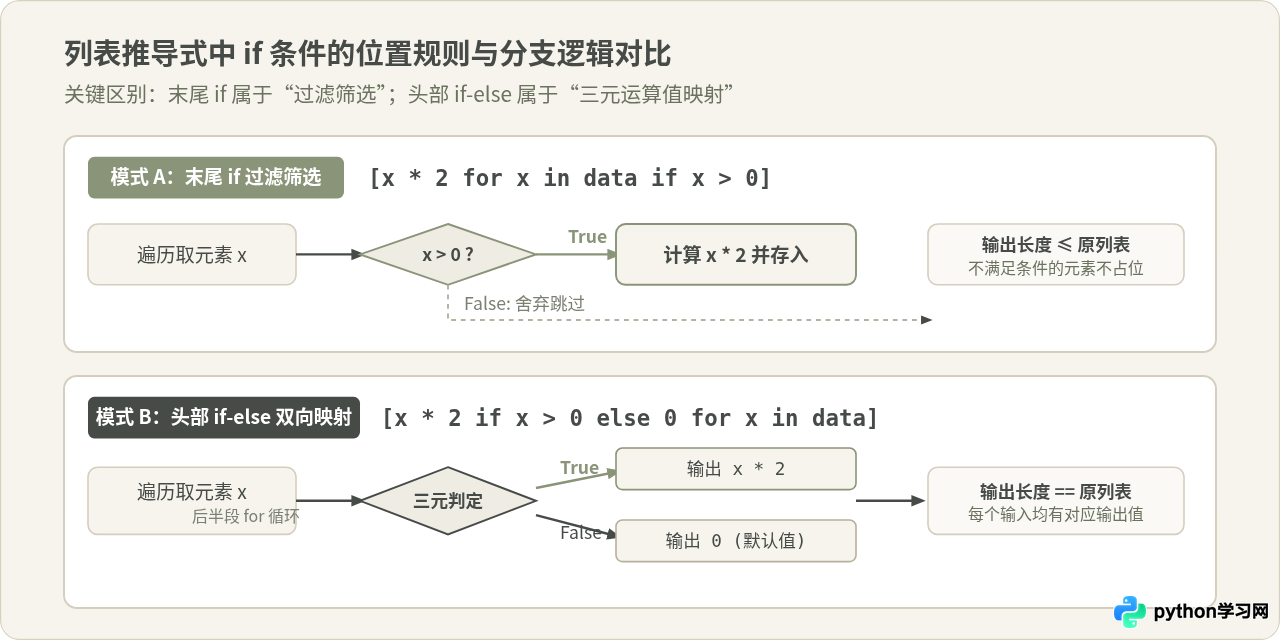
1. 末尾单 if:用于“过滤筛选”
当目标是从数据源中剔除不符合要求的元素时,if 必须写在整个语句的末尾:[表达式 for 变量 in 迭代对象 if 过滤条件]。
此时 if 扮演的是门禁过滤器角色。对于每一个被迭代的元素,只有当条件判定为 True 时,左侧的表达式才会计算并被收集到新列表中;若为 False,该元素被直接丢弃,新列表的长度通常小于原列表。
# 仅保留正数并计算其 2 倍(末尾 if 过滤)
data = [12, -7, 5, -3, 0, 18]
positives_doubled = [x * 2 for x in data if x > 0]

# 示例输出:
# positives_doubled -> [24, 10, 36]
2. 头部 if-else:用于“双向映射转换”
当目标是对列表中的每个元素都给出一个转换值(即符合条件转为 A,不符合条件转为 B)时,必须使用 Python 的三元条件表达式:[值A if 条件 else 值B for 变量 in 迭代对象]。
此时的 if-else 属于左侧表达式的一部分,每一个输入元素都必然产出一个对应输出,因此生成的新列表长度与原列表严格相等。如果在这里省略 else,Python 解释器会直接报 SyntaxError: invalid syntax 语法错误。
# 遇到负数归零,正数保留原值(头部三元表达式 if-else)
data = [12, -7, 5, -3, 0, 18]
clamped = [x if x > 0 else 0 for x in data]

# 示例输出:
# clamped -> [12, 0, 5, 0, 0, 18]
[x * 2 if x % 2 == 0 else x for x in data if x > 0],先通过末尾 if 过滤出正数,再通过头部三元表达式对偶数进行翻倍。
三、双重循环与多维嵌套扁平化写法
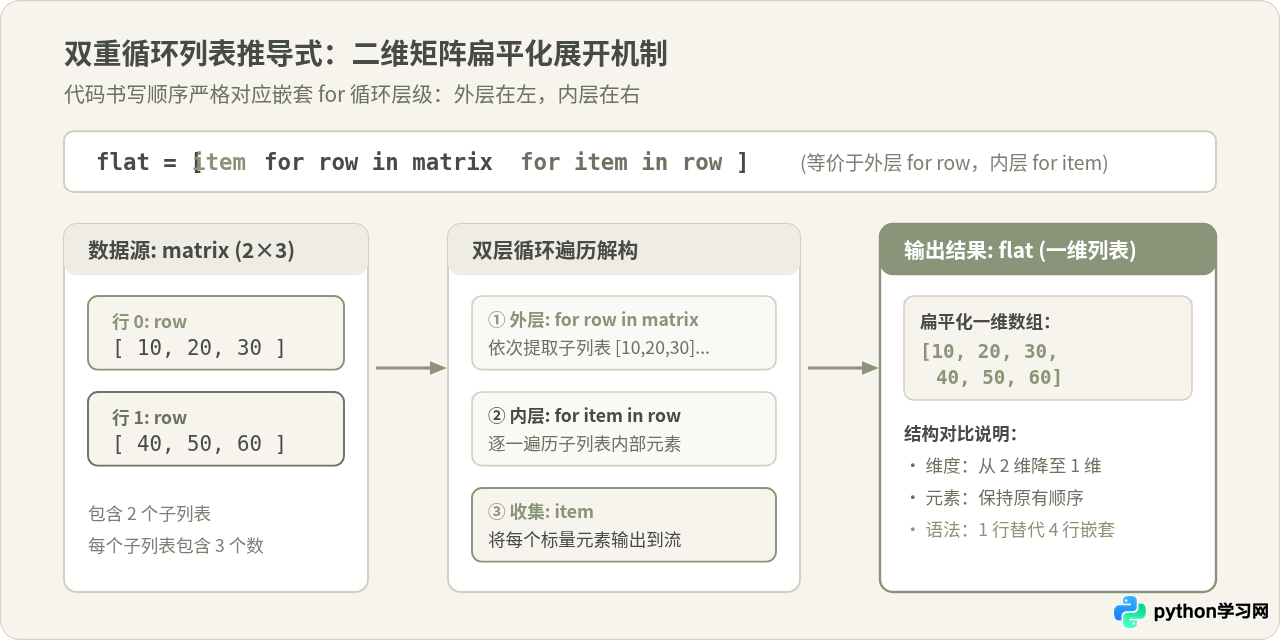
列表推导式支持多个 for 子句。多重循环的书写顺序有一个绝不改变的核心原则:推导式中 for 子句的从左到右书写顺序,完全等价于传统代码中从外到内的循环缩进顺序。
1. 二维矩阵扁平化展开
将嵌套的二维列表展开为扁平的一维列表是双重推导式的典型场景。先写外层循环 for row in matrix,再紧接着写内层循环 for item in row:
# 展开二维列表为一维列表
matrix = [
    [10, 20, 30],
    [40, 50, 60]
]

# 对应传统逻辑:
# flat = []
# for row in matrix:      # 外层
#     for item in row:    # 内层
#         flat.append(item)

flat = [item for row in matrix for item in row]

# 示例输出:
# flat -> [10, 20, 30, 40, 50, 60]
2. 生成笛卡尔积组合
当需要组合两个互不相关的序列时,直接按层级书写两个 for 子句:
# 生成扑克牌点数与花色的笛卡尔积
suits = ["♠", "♥", "♣", "♦"]
ranks = ["A", "K", "Q"]

cards = [f"{s}{r}" for s in suits for r in ranks]

# 示例输出(前 6 个元素):
# cards -> ['♠A', '♠K', '♠Q', '♥A', '♥K', '♥Q', ...]
四、高频实战必背源代码模板
以下整理了在实际项目开发、文本处理和接口数据解析中最高频出现的 4 种推导式代码模板。
模板 1:字符串列表清洗与去空值
在批量处理用户输入或从文件读取文本时,常需要剔除空串、首尾空格并转换为统一大小写:
raw_tags = [" Python ", "", "Django", "  ", "Flask ", "FASTAPI"]

# 先去除空格,仅保留非空字符串,并统一转为小写
cleaned_tags = [tag.strip().lower() for tag in raw_tags if tag.strip()]

# 示例输出:
# cleaned_tags -> ['python', 'django', 'flask', 'fastapi']
模板 2:基于条件筛选字典中的键或值
利用 dict.items() 解构键值对,快速筛选满足业务指标的字段名称:
scores = {"Alice": 92, "Bob": 58, "Charlie": 84, "David": 45}

# 筛选出及格(分数 >= 60)的学生名单
passed_students = [name for name, score in scores.items() if score >= 60]

# 示例输出:
# passed_students -> ['Alice', 'Charlie']
模板 3:结合 enumerate 或 zip 的多序列配对
当需要按索引定位或者将两个关联列表对齐合并时,推导式与内置迭代器可以自然配合:
headers = ["id", "username", "status"]
row_values = [1001, "admin", "active"]

# 通过 zip 配对拼接为键值描述字符串
record_info = [f"{k}={v}" for k, v in zip(headers, row_values)]

# 示例输出:
# record_info -> ['id=1001', 'username=admin', 'status=active']
模板 4:提取嵌套字典或对象中的特定字段
处理接口返回的 JSON 列表时,快速提取目标属性列表:
users = [
    {"id": 1, "profile": {"role": "admin"}, "active": True},
    {"id": 2, "profile": {"role": "user"}, "active": False},
    {"id": 3, "profile": {"role": "manager"}, "active": True},
]

# 仅提取状态为激活的用户的 ID 列表
active_ids = [u["id"] for u in users if u.get("active")]

# 示例输出:
# active_ids -> [1, 3]
五、常见认知误区与使用边界辨析
虽然列表推导式功能强大,但在实际使用中容易产生以下三个典型误区。理解这些误区有助于在代码整洁性与健壮性之间取得平衡。
误区一:代码越短越好,嵌套越多越显技术水平?
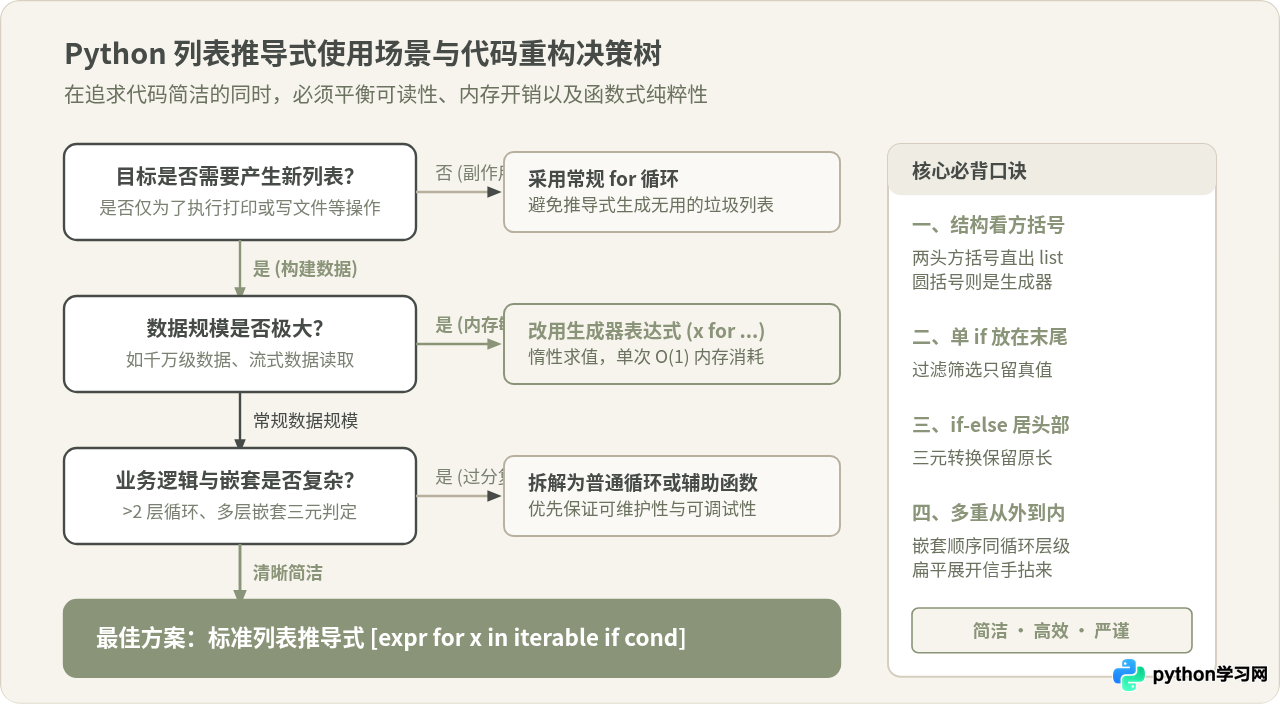
辨析与修正:列表推导式的优势是提升简洁度,但绝不应以牺牲代码可读性为代价。当推导式中出现多于 2 层的 for 循环,或者混杂了多重三元判断嵌套时,代码会变得极难阅读和打断点调试。PEP 8 明确建议:如果推导式一行写不下,或者逻辑一眼无法看清,应该改写为标准的多行 for 循环,或将复杂的判定抽离为独立的辅助函数。
误区二:列表推导式一定比普通循环快很多,所以任何循环都要换?
辨析与修正:在底层执行机制上,列表推导式由于在 CPython 虚拟机中使用专门优化的 LIST_APPEND 字节码,确实跳过了 Python 层面的方法名属性查找和函数栈调用,执行速度通常比普通 for + append() 快约 20% 到 30%。这种说法本身是成立的。
然而,推导式会在执行时立即在内存中一次性分配并构建全部列表对象。如果迭代的数据量达到上千万条,列表推导式会瞬间占用极大的内存甚至导致内存溢出(OOM)。在仅需遍历一次、无需常驻内存的大数据场景下,应当改用圆括号的生成器表达式(Generator Expression):
# 列表推导式:立即占用完整内存
huge_list = [x * 2 for x in range(10_000_000)]

# 生成器表达式:惰性求值,单次内存消耗仅 O(1)
huge_gen = (x * 2 for x in range(10_000_000))
误区三:用列表推导式执行纯副作用操作(如 print 或写文件)
辨析与修正:有时候会看到类似 [print(x) for x in items] 的写法。虽然解释器不会报错,但这是一种严重不推荐的反模式。
推导式的唯一语义目标是“生产一个有意义的新列表”。print() 的返回值是 None,这行代码在屏幕输出的同时,会在内存中创建一个全部装满 None 的无用列表,随后立即被垃圾回收,造成无谓的内存开销与算力浪费。对于没有返回值、仅需产生副作用的操作,应始终坚持使用最纯粹的 for 循环。
六、语法速查与总结清单
掌握列表推导式的核心在于分清“过滤”与“变换”的语法位置,并恪守“为生成新容器而使用”的职责边界。下表汇总了各种常见需求与对应的代码语法结构:
| 业务需求场景 | 标准代码写法结构 | 结果列表特征 |
|---|---|---|
| 基础全量转换 | [expr for x in iterable] |
长度等于原列表,元素一对一转换 |
| 条件过滤剔除 | [expr for x in iterable if cond] |
长度小于等于原列表,仅保留 True 元素 |
| 条件分支双向赋值 | [v1 if cond else v2 for x in iterable] |
长度等于原列表,按三元条件选择赋值 |
| 先过滤再分支赋值 | [v1 if c1 else v2 for x in it if c2] |
长度受 c2 过滤,留存项由 c1 分支决定 |
| 双重嵌套循环 | [expr for out in list1 for inn in out] |
展开外层与内层,外层循环在左侧 |
| 大数据量低内存 | (expr for x in iterable if cond) |
返回生成器对象,按需惰性计算 |
在日常开发中,只要牢记“两头方括号、左侧求值右侧循环、单 if 放末尾、if-else 居头部”,就能准确、优雅地写出符合 Pythonic 风格的列表推导式源代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















