


Python能用来做什么:数据分析、Web开发与自动化场景解析
深入解析Python在数据分析、Web开发与流程自动化三大主流场景中的工程落地方式、核心工具链、具体实现步骤及选型注意事项。
Python 是一门通用型脚本语言,在工程实践中最成熟、落地最密集的三个核心方向是数据分析、Web 服务端开发与各类流程自动化。掌握这门语言通常不需要先了解晦涩的底层编译机制,而是明确它在不同场景中能解决哪些具体问题、依托哪些主流类库,以及工程落地的边界和限制。
一、数据分析与科学计算场景
在日常经营与科研场景中,大量原始数据分散在表格、日志或数据库中。Python 在这一场景的核心作用,是将零散、不规则的数据提取出来,完成清洗整理、指标统计、特征建模并输出直观图表。
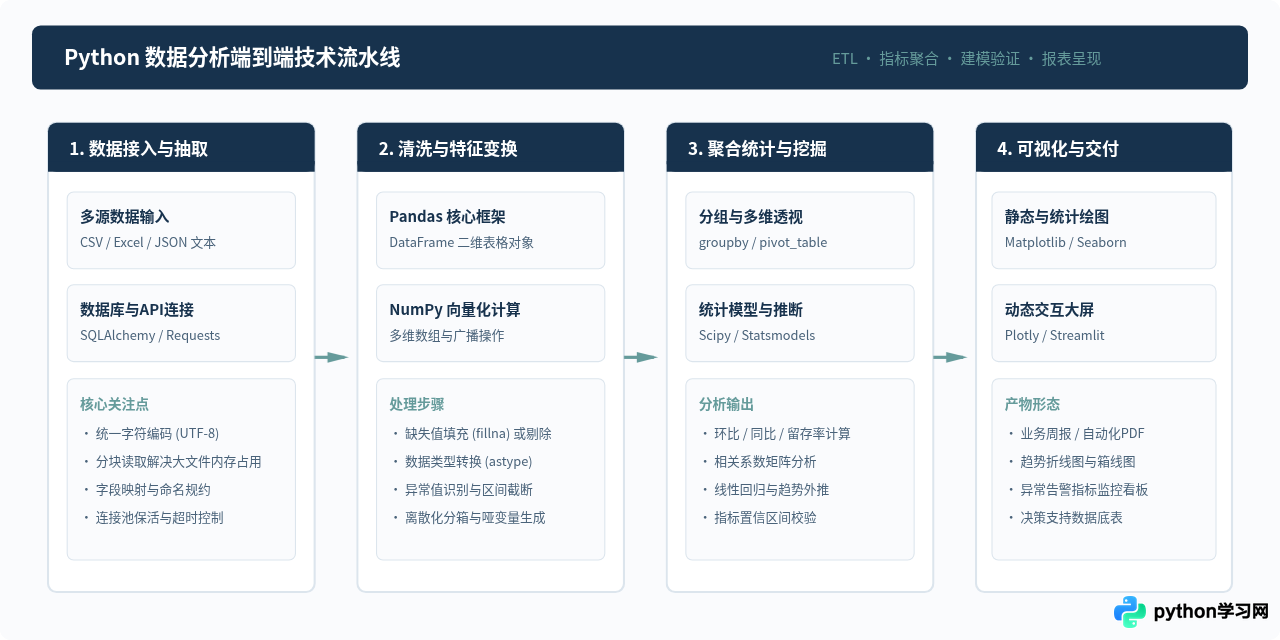
1. 核心工具库与分工
- Pandas:提供
DataFrame二维数据结构,具备行索引与列标签,原生支持读取 CSV、Excel、Parquet 及关系型数据库;内置数据对齐、缺失值过滤、分组聚合(groupby)和透视表(pivot_table)能力。 - NumPy:作为科学计算底层基石,提供连续内存布局的
ndarray数组。相较于原生 Python 列表逐项寻址,NumPy 利用底层的 C 实现与 SIMD 向量化指令集,在数值矩阵运算上有百倍以上的速度优势。 - Matplotlib & Seaborn:Matplotlib 负责精细控制坐标轴、刻度与图元布局;Seaborn 在此基础上封装了常见的统计分布图(如箱线图、核密度估计图、热力图),用较少代码即可绘制符合排版标准的学术与工程图表。
2. 典型分析代码示例
以下示例展示从本地订单记录中读取数据、剔除无效行并按城市维度汇总销售总额与客单价:
import pandas as pd

# 示例输入:读取销售日志
df = pd.read_csv("orders_sample.csv", encoding="utf-8")

# 1. 数据清洗:滤除缺失金额或状态为取消的记录
cleaned_df = df.dropna(subset=["amount"]).query("status != 'CANCELLED'").copy()

# 2. 字段类型转换与派生字段
cleaned_df["amount"] = cleaned_df["amount"].astype(float)
cleaned_df["order_date"] = pd.to_datetime(cleaned_df["order_date"])

# 3. 按城市分组聚合核心指标
city_summary = cleaned_df.groupby("city").agg(
    total_sales=("amount", "sum"),
    order_count=("order_id", "count"),
    avg_order_value=("amount", "mean")
).reset_index()

# 示例输出查看前5行结果
print(city_summary.head(5))边界与性能考量:Pandas 是典型的单机内存计算模型,数据量以全部载入 RAM 为前提。当单表数据超过数千万行或物理内存无法容纳时,应选用支持懒加载和多核并行的 Polars,或引入分布式引擎 PySpark / DuckDB。
二、Web 开发与服务端接口场景
Python 在 Web 领域的重心集中在服务端业务处理与 API 交付。由于其语法精炼且拥有完备的中间件生态,工程师可以用极少的心智负担快速搭建起可交付的业务后台、RESTful 接口或微服务。
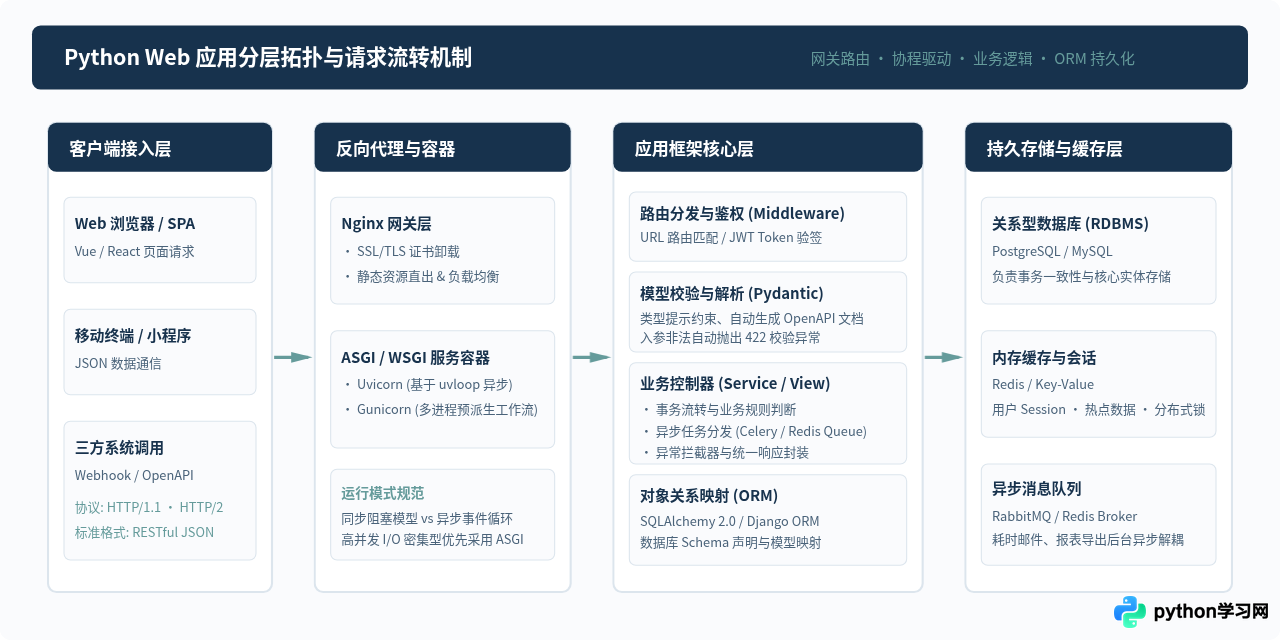
1. 两种主流开发范式与框架选择
- 全功能大包型框架(以 Django 为代表):自带 ORM、用户权限管理系统、防 CSRF 机制与开箱即用的后台管理页面(Django Admin)。非常适合业务复杂度高、需要快速构建完整后台系统的企业管理系统与内容平台。
- 微服务与高性能 API 框架(以 FastAPI、Flask 为代表):Flask 保持核心微小,扩展灵活;FastAPI 则深度结合 Python 类型提示(Type Hints)与
asyncio协程,在处理高并发网络 I/O 时表现突出,并原生支持基于 OpenAPI(Swagger)自动生成交互式接口文档。
2. FastAPI 异步接口示例
以下示例使用 FastAPI 与 Pydantic 定义一个符合 RESTful 规范的用户创建接口,包含类型自动转换与非空校验:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, EmailStr

app = FastAPI(title="用户管理服务")

# 定义数据传输模型与校验规则
class UserCreateRequest(BaseModel):
    username: str
    email: EmailStr
    department: str

# 内存模拟存储
db_users = {}

@app.post("/api/v1/users", status_code=status.HTTP_201_CREATED)
async def create_user(payload: UserCreateRequest):
    # 模拟业务逻辑校验:排重检测
    if payload.username in db_users:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail="用户名已存在"
        )

    # 业务数据持久化处理
    new_user = payload.model_dump()
    new_user["id"] = len(db_users) + 1
    db_users[payload.username] = new_user

return {"code": 200, "message": "创建成功", "data": new_user}技术考量:Python 默认采用全局解释器锁(GIL),纯 CPU 密集型计算(如实时音视频编解码)并不适合直接写在 Web 主线程中;但在 Web 开发最常见的数据库查询、远程调用等网络 I/O 密集型场景下,异步事件循环能提供极其优秀的吞吐表现。
三、自动化脚本与流程提效场景
自动化是 Python 使用门槛最低、也是各类非技术岗位与运维人员受益最直接的领域。它的核心价值在于将重复繁琐的人工操作,转化为确定性执行的代码脚本。
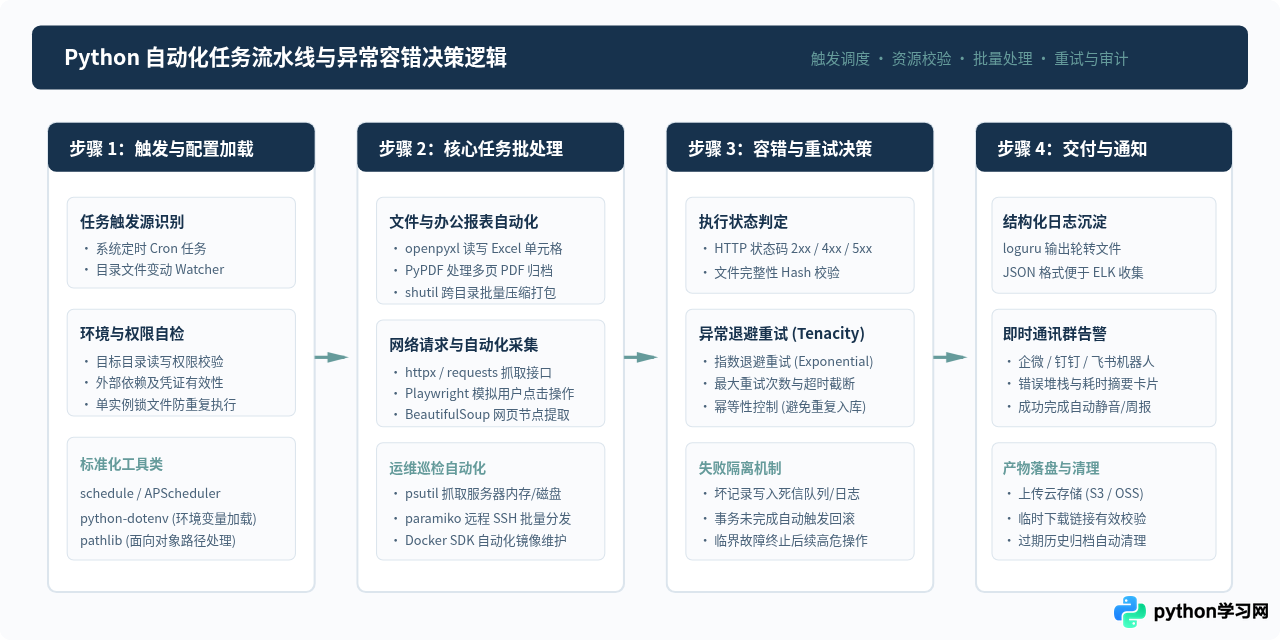
1. 三类典型自动化应用
- 办公文档批量整理:使用
openpyxl批量读写 Excel 公式、修改样式;使用python-docx自动根据模板生成会议纪要或批量合同;使用pathlib遍历成百上千个杂乱文件并按创建日期重命名归档。 - 网页数据爬取与验证:对于静态页面,采用
requests发起 HTTP 请求结合BeautifulSoup或lxml进行 XPath 解析;对于强依赖客户端 JavaScript 动态渲染的现代网页,使用Playwright驱动无头浏览器执行自动滚动、输入与截图,稳定性远优于旧式驱动。 - 系统运维与服务器巡检:通过
psutil模块定期探测主机的 CPU 使用率、剩余磁盘空间与进程健康状态;当指标超出阈值时,自动调用企微或飞书机器人 Webhook 推送告警。
2. 生产级日志清理与归档脚本示例
以下示例展示一个典型的运维自动化脚本:递归扫描指定目录下的日志文件,将超过指定保存期限的文件归档至压缩包并安全删除源文件:
import os
import time
import zipfile
from pathlib import Path

def archive_old_logs(log_dir: str, retention_days: int = 7) -> None:
    base_path = Path(log_dir)
    if not base_path.exists():
        print(f"指定的目录不存在: {log_dir}")
        return

    # 计算过期时间截点(秒)
    cutoff_time = time.time() - (retention_days * 86400)
    archive_zip_path = base_path / f"archive_before_{int(cutoff_time)}.zip"

    matched_files = []
    for file_path in base_path.glob("*.log"):
        # 获取文件最后修改时间
        if file_path.is_file() and file_path.stat().st_mtime < cutoff_time:
            matched_files.append(file_path)

    if not matched_files:
        print("未发现满足归档条件的过期日志。")
        return

    # 写入压缩包并清理原文件
    with zipfile.ZipFile(archive_zip_path, mode="w", compression=zipfile.ZIP_DEFLATED) as zf:
        for file in matched_files:
            zf.write(file, arcname=file.name)
            file.unlink()  # 删除已被安全压缩的源文件
            print(f"已归档并移除: {file.name}")

    print(f"归档完毕,共处理 {len(matched_files)} 个文件,输出: {archive_zip_path.name}")

# 执行示例
if __name__ == "__main__":
archive_old_logs(log_dir="./logs_sample", retention_days=14)合规与异常提示:编写网络自动化或爬虫时,需严格遵循目标站点的 robots.txt 规范与访问频控限制,设置合理的人性化休眠间隔;所有涉及删除与覆盖的本地脚本,必须先在隔离环境或通过只读预览模式(Dry Run)验证逻辑无误后再正式运行。
四、三大场景技术选型与综合决策矩阵
初学者或技术团队在立项时,常因场景界定不清而选错技术栈。理解三大场景在学习门槛、开发速度、性能瓶颈以及关键依赖上的核心差异,是高效落地的关键前提。
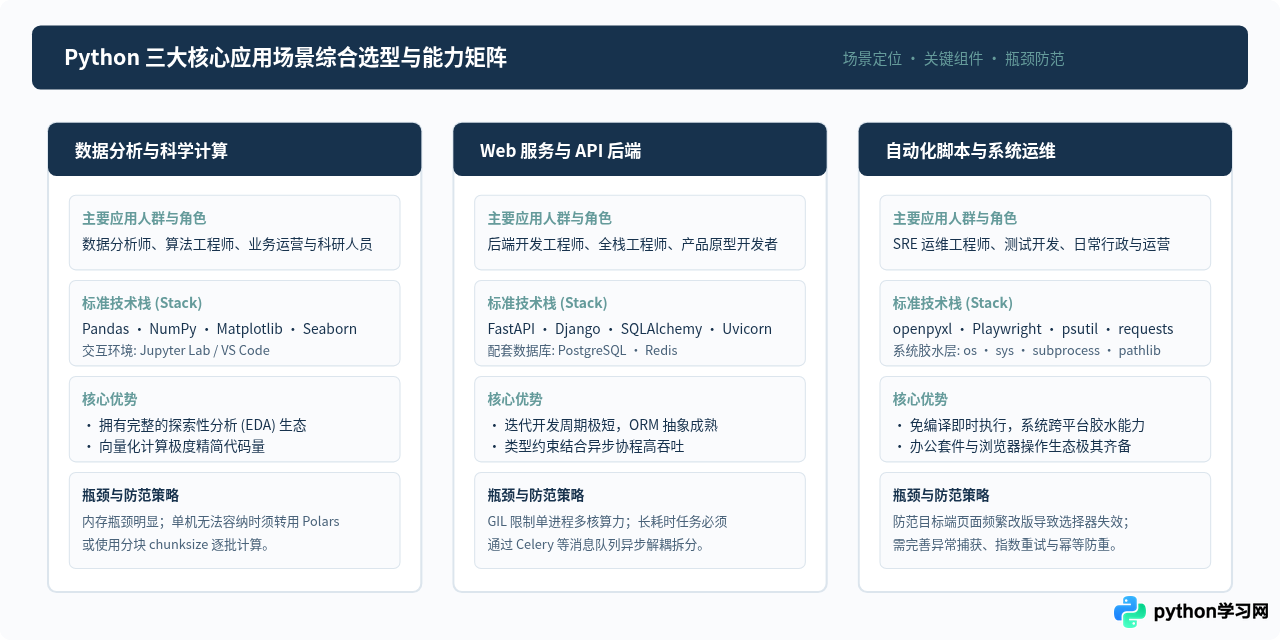
场景选型对照表
| 评估维度 | 数据分析场景 | Web 开发场景 | 自动化脚本场景 |
|---|---|---|---|
| 前置门槛 | 需具备基础统计学与表格聚合思维 | 需理解 HTTP 协议、REST 规范与数据库操作 | 仅需掌握基本语法与文件/接口调用 |
| 交付产物形态 | 分析报告、图表大屏、指标看板与清洗好的数据表 | 线上服务、RESTful API、后台管理系统、微服务 | 计划任务脚本、办公辅助工具、巡检机器人 |
| 开发交付速度 | 极快(借由 Jupyter 即时交互探索) | 中等偏快(ORM 与现成脚手架大幅压缩工期) | 极快(单文件或十几行代码即可成型运行) |
| 常见技术风险 | 内存溢出 (OOM)、浮点精度漂移 | 未做异步解耦导致的并发请求阻塞、SQL慢查询 | 目标路径不存在、外部接口频控拦截、重复写入 |
五、总结
Python 能用来做什么,取决于实际业务要解决的具体问题:
- 如果你面对的是大量分散在 Excel、数据库中的业务记录,需要提取规律、计算增长指标或绘制趋势,Python 的 Pandas + Matplotlib 是目前综合效率最高的工具链;
- 如果你需要为前端小程序、App 或企业内部搭建一套结构清晰、权限受控的服务端应用,采用 FastAPI 或 Django 可以在几天内搭建出高可用的生产接口;
- 如果你需要将每天重复手动执行的文件重命名、报表收发、网页抓取与服务器监控自动化,Python 丰富的标准库与专有类库能直接以脚本方式为你节省大量时间。
在实际工程中,这三者往往不是孤立的:一个典型的自动化脚本可以在抓取数据后,利用 Pandas 完成本地清洗,并通过 FastAPI 暴露为分析接口,共同构建起完整的数据生产与服务闭环。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















