


conda-libmamba-solver为什么让建环境更快?
深度解析 conda-libmamba-solver 如何通过 C++ 与 libsolv 原生求解池彻底解决 Conda 建环境慢、Solving environment 卡顿的问题,包含底层原理、架构演进与配置实操。
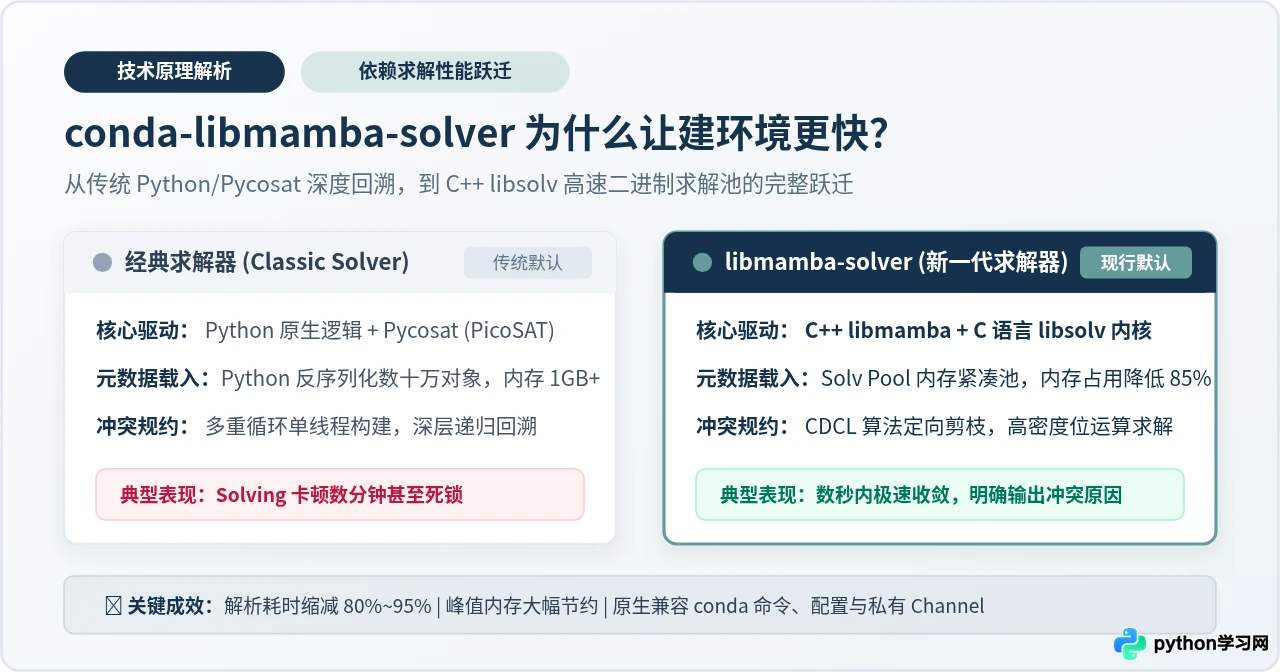
使用 Conda 创建或更新 Python 环境时,最耗费时间的往往是终端中停滞不前的 Solving environment: ...。conda-libmamba-solver 能够将这一过程从数分钟甚至数小时缩短到几秒钟,核心原因在于它将依赖求解引擎从原生的 Python 逻辑与传统 SAT 包装层,替换为了基于 C/C++ 编写的专有依赖库 libsolv 与 libmamba。本文直接深入 Conda 依赖解析变慢的底层症结、conda-libmamba-solver 的架构集成与加速机制,并提供完整的环境诊断、配置启用与异常排查指南,帮助你在日常使用中获得稳定高效的建环境体验。
一、Conda 传统依赖求解为什么会“卡住”?
在讨论加速之前,我们必须先理解 Conda 到底在“求解”什么,以及经典求解器(Classic Solver)为什么会随着时间推移越来越慢。
依赖解析本质上是计算机科学中的经典 布尔可满足性问题(Boolean Satisfiability Problem, SAT),属于典型的 NP-Complete 难题。当你执行 conda install numpy scipy 时,Conda 不仅要找到 numpy 和 scipy,还要确保它们共同依赖的 Python 版本、底层 C 运行库(如 glibc 或 Windows CRT)、数学加速库(如 OpenBLAS、MKL)以及数百个间接依赖项在版本和构建编号(build string)上完全兼容,不产生任何版本冲突。
在早期,Anaconda 官方源维护的包数量有限,依赖图规模较小,经典求解器尚能应付。但在过去几年中,随着数据科学与人工智能生态的发展,尤其是 conda-forge 等社区频道的爆发式增长,单个频道的元数据(repodata.json)已经收录了数十万个软件包构建变体。这直接引爆了传统求解器的三大瓶颈:
- 内存开销与对象爆炸:经典求解器采用纯 Python 解析庞大的 JSON 元数据。在 Python 内存堆中,每个包、版本和约束都被反序列化为独立的 Python 对象(如
PackageRecord)。面对数以十万计的记录,仅加载元数据就会产生数百兆乃至数吉字节(GB)的内存开销,同时伴随密集的 Python 垃圾回收(GC)延迟。 - 低效的 CNF 规则编码:为了将依赖关系输入底层求解器,Conda 需要遍历所有包对象,在 Python 层编写并生成合取范式(CNF)子句。受限于 Python 的动态类型和单线程解释执行特性,规则转换耗费大量 CPU 计算时间。
- 搜索策略与浅层回溯机制:经典求解器使用的底层库是
pycosat(对 C 语言 PicoSAT 的封装)。尽管 PicoSAT 本身是 C 编写的,但它是一个通用的布尔 SAT 求解器,并未针对“软件安装包”的版本偏序、架构匹配和依赖剪枝做针对性优化。当依赖图中存在交叉冲突时,求解器在 Python 调度层与 C 求解器之间频繁回溯试错,极易陷入组合爆炸,导致终端长期停留在 Solving 阶段。
二、conda-libmamba-solver 的体系架构
很多用户以为加速必须彻底卸载 Conda 改用独立的 mamba 可执行程序,但这往往会破坏已有生产环境或 CI 脚本对 conda 命令的依赖。为此,Conda 团队推出了以插件形式存在的 conda-libmamba-solver。
从 Conda 22.11 版本开始,Conda 引入了统一的求解器插件接口(conda.core.solve)。conda-libmamba-solver 就是这一接口的标准实现,其架构设计兼顾了兼容性与极致性能:
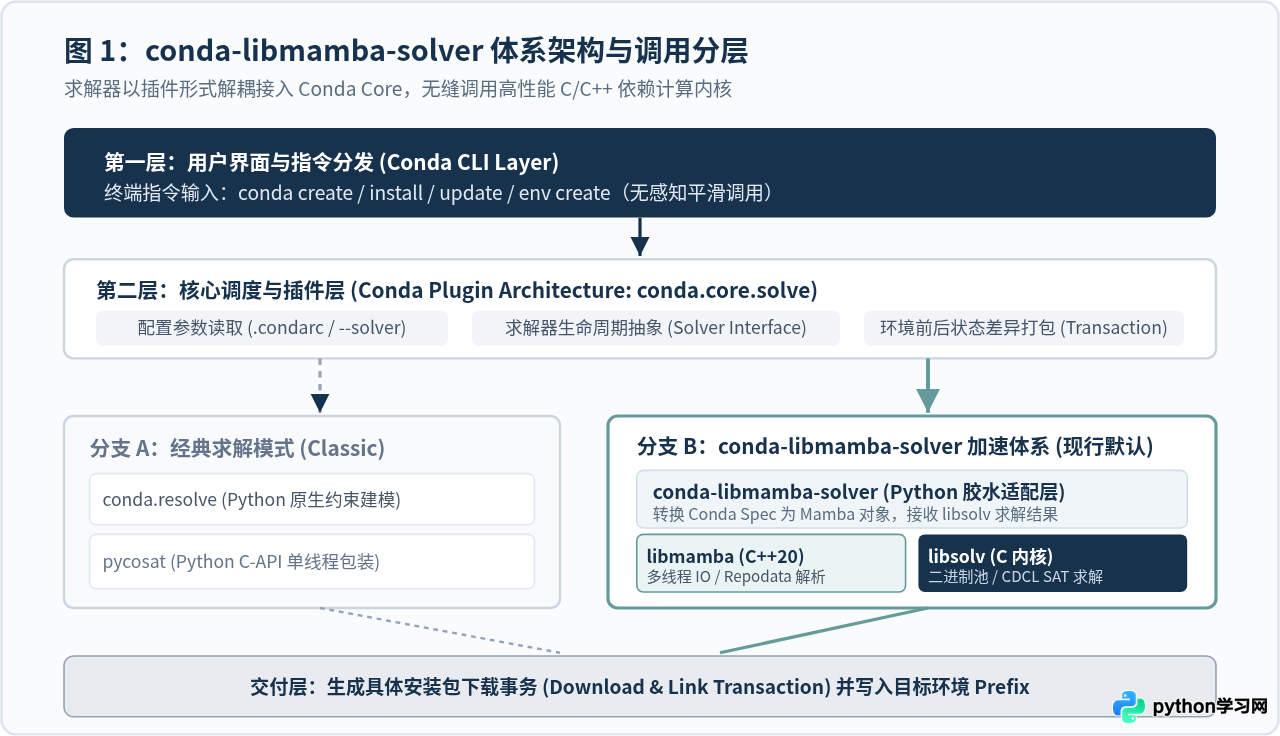
如上图所示,整个体系分为四个层级:
- CLI 交互层:用户继续使用熟悉的
conda create、conda install等原生指令,工作流和参数无需任何修改。 - 插件分发层:Conda Core 读取配置文件中的
solver属性,将具体解析任务通过统一契约路由给指定插件。 - 原生核心引擎(libmamba + libsolv):这是提速的关键支柱。由一个轻量的 Python 模块对接 C++ 编写的 libmamba 引擎,底层再调用源自 Linux 发行版(openSUSE/Fedora RPM 体系)历经十余年淬炼的 libsolv。
- 交付与执行层:求解完成后,libsolv 返回最优的包版本决策列表,交由 Conda 核心继续执行高效的包下载、缓存解压与前缀硬链接(Hard Link)。
三、为什么 libmamba 能够实现数量级加速?
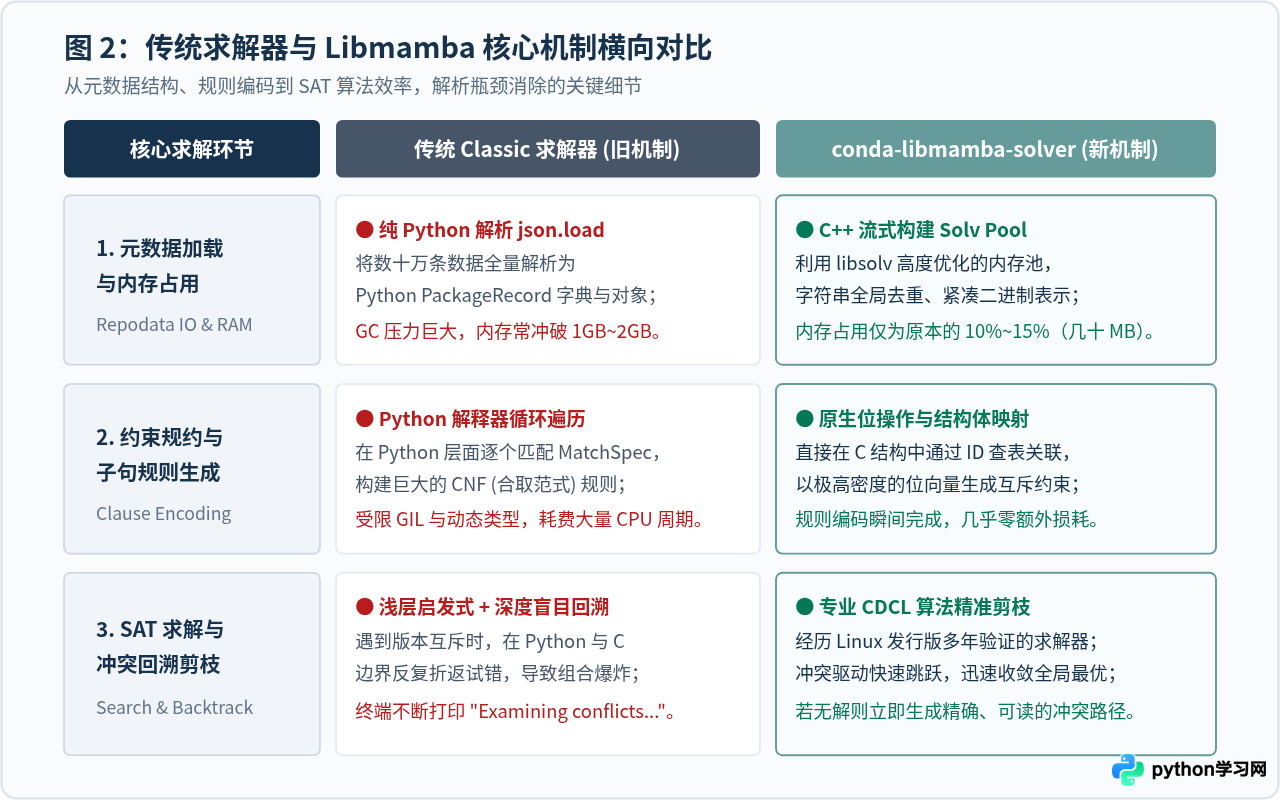
conda-libmamba-solver 之所以能在解析速度上实现 10x 到 50x 的飞跃,并非依赖单一技巧,而是从数据结构、算法剪枝到内存布局进行了全链路重构。
1. 革命性的二进制求解池(Solv Pool)
在传统求解器中,一个 repodata.json 读入内存后,字符串、字典、依赖列表四处散落。而在 libsolv 中,所有包名、版本字符串和架构标识在载入时即完成全局字典去重,并映射为整型 ID。依赖关系被压缩存放在一个名为 Pool(求解池) 的紧凑 C 语言结构体数组中。
这种设计使得元数据在内存中的占用降低了 80%~90%(原本 1GB+ 的内存峰值骤降至几十 MB),并且完全避开了 Python 解释器在频繁创建和销毁微小对象时的 GC 开销。现代 CPU 缓存(L1/L2/L3 Cache)能够对连续数组进行极高命中率的预取,数据吞吐性能大幅提升。
2. 专为包管理器定制的 CDCL 剪枝算法
libsolv 采用的是成熟的 冲突驱动子句学习(Conflict-Driven Clause Learning, CDCL) 算法,并且针对软件包版本的单调递增性、架构兼容性做了深度启发式调优:
- 非时间序回跳(Non-chronological Backtracking):普通 SAT 求解器发生冲突时往往退回到上一个决策点逐一试错;而 CDCL 算法在发现冲突时能够从冲突图推导出根本原因子句,直接“跳跃”回到导致冲突的源头层级,瞬间剪掉成千上万个无意义的无效分支。
- 规则预规约与位图运算:在生成约束条件时,libmamba 在 C 语言层使用位向量直接进行集合交并计算,规约速度比 Python 脚本代码快上千倍。
3. 极速、精准的依赖冲突定位
当遇到真正无法调和的版本冲突时,传统求解器往往陷入长时间的回溯计算,最终输出让人看不懂的报错或者直接无响应。而 conda-libmamba-solver 由于维护了完整的蕴涵图(Implication Graph),一旦无解能够毫秒级定位出发生死锁的两个具体包名与各自的依赖限制,极大减轻了开发者的排查负担。
四、配置与启用:从诊断到实操
了解原理后,我们通过规范的步骤在实际系统中使用 conda-libmamba-solver。
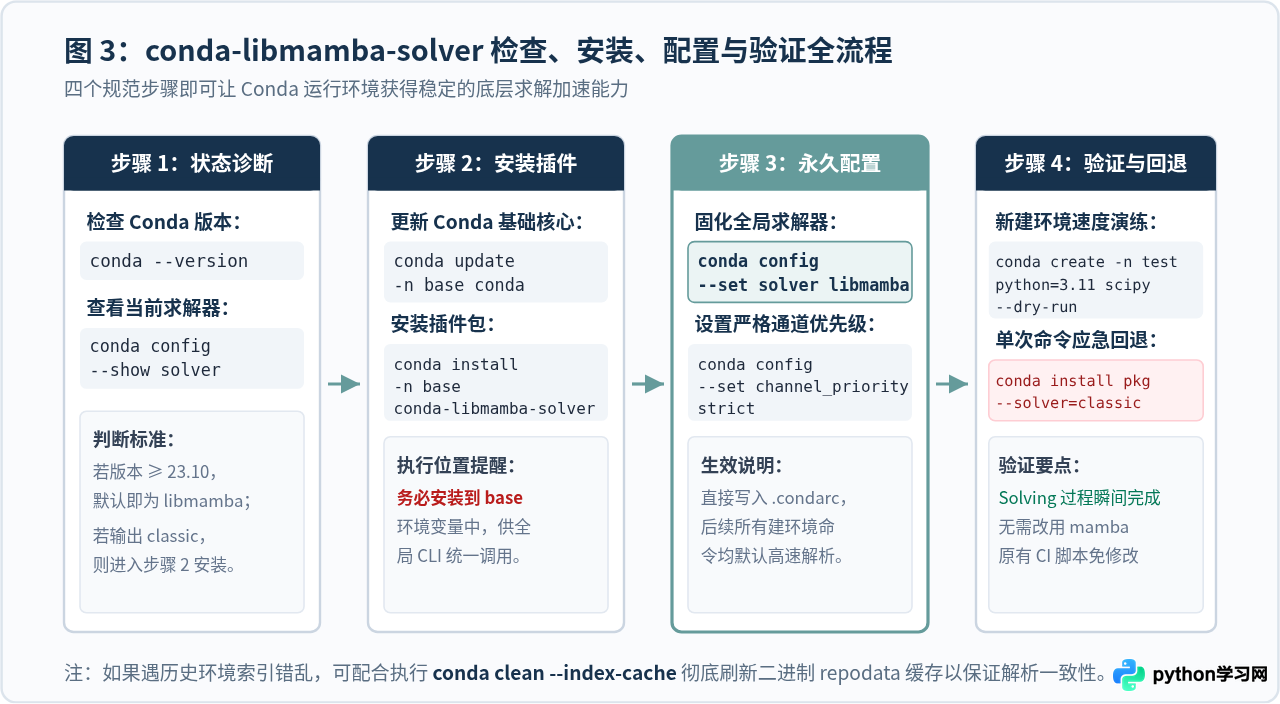
步骤一:检查当前环境版本与求解器
在终端中执行以下命令,确认当前的 Conda 版本与正在生效的求解器配置:
# 查看 Conda 版本
conda --version

# 查看当前生效的求解器
conda config --show solver
输出示例:
conda 24.1.2
solver: libmamba
conda-libmamba-solver 设定为默认求解器。如果你的 Conda 版本等于或高于 23.10 且输出如上,则说明你的系统已经在享受加速,无需额外安装。
步骤二:安装插件(针对 Conda 22.11 ~ 23.9 环境)
如果你的版本较早且当前求解器显示为 classic,建议先升级 base 环境中的 conda,并安装求解器插件:
# 1. 确保在 base 环境,更新 conda 自身
conda update -n base -c defaults conda

# 2. 安装 libmamba 求解器插件
conda install -n base conda-libmamba-solver
步骤三:固化配置为全局默认求解器
安装完成后,通过修改用户根目录的 .condarc 配置文件,将 libmamba 固化为默认引擎:
# 将 libmamba 设置为默认求解器
conda config --set solver libmamba

# 推荐开启严格通道优先级(消除多频道版本冲突)
conda config --set channel_priority strict
步骤四:验证速度与应急回退机制
配置完成后,可立即通过 --dry-run 参数测试一个较复杂环境的依赖解析速度:
# 验证创建环境(仅测试求解速度,不执行实际下载写入)
conda create -n benchmark_env python=3.11 pytorch torchvision scipy pandas --dry-run

# 如果在极个别特殊场景需要临时退回经典求解器,可在命令后附加参数
conda install package_name --solver=classic
五、最佳实践与故障排查决策
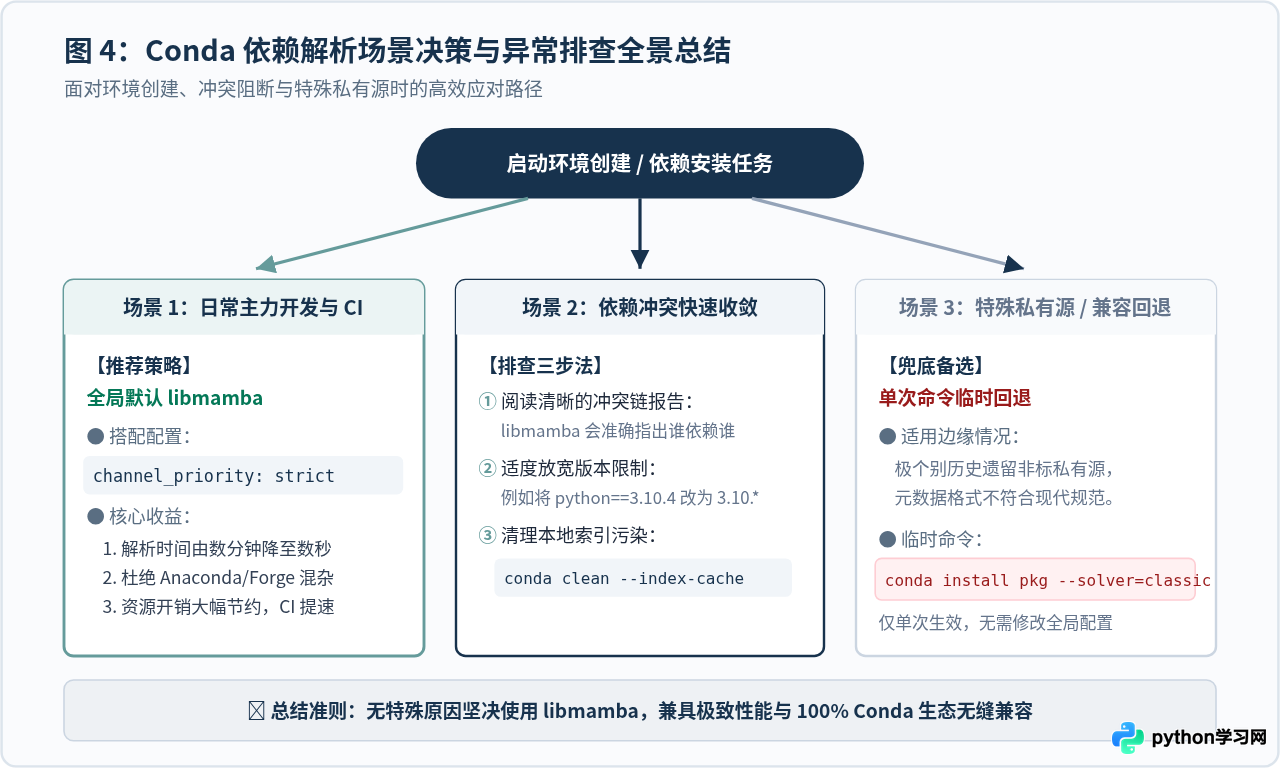
在实际生产与科研环境中,除了启用 libmamba 求解器外,遵循以下经验能进一步保障依赖解析的稳定性:
| 对比维度 | 经典求解器 (Classic Solver) | conda-libmamba-solver |
|---|---|---|
| 实现语言 | Python 逻辑 + C 语言 pycosat | C++20 (libmamba) + C 语言 (libsolv) |
| 解析耗时 | 数十秒至几十分钟,易死锁 | 通常仅需 2 ~ 15 秒 |
| 内存占用峰值 | 高(经常突破 1GB ~ 2GB) | 极低(通常在 80MB ~ 200MB 之间) |
| 冲突定位表现 | 输出冗长模糊或无法收敛 | 精准打印冲突链条,明确指出版号矛盾 |
| Conda 生态兼容度 | 基准实现 | 100% 兼容原生命令、配置与凭证 |
1. 为什么强烈建议开启 channel_priority: strict?
当同时配置了 defaults 和 conda-forge 频道时,若未开启严格优先级,求解器会试图拉取所有频道中版本号最高的包。两个频道的 C++ 运行时构建规范(ABI)存在细微差异,极易诱发隐蔽的运行期符号冲突或极度复杂的解图。启用 strict 后,Conda 会严格锁死高优先级频道的依赖包,既降低了求解维度,又保证了二进制库的一致性。
2. 遇到旧索引缓存污染如何处理?
如果你在切换求解器前后发现本地报出校验不一致或非预期版本锁定,通常是因为本地缓存的索引文件(.cache)受损。执行以下清理命令即可刷新:
conda clean --index-cache -y
3. 什么时候需要回退到 Classic 求解器?
在 99% 的常见开发中,libmamba 完全可以替代经典求解器。唯有一种边缘场景需要注意:某些由老旧内部打包系统生成的非标准私有源(包含缺少必要元数据字段的旧 tar.bz2 包)。如果 libsolv 报错语法格式不合法,可以单次添加 --solver=classic 参数作为权宜之计,但在日常绝大多数场景下,应保持 libmamba 为主力求解器。
结语
conda-libmamba-solver 并不是简单地给原先的依赖算法“打补丁”,而是通过底层工程化思想的重构——用 C/C++ 内存紧凑池替代 Python 堆对象,用经过实战检验的 CDCL SAT 剪枝引擎替代通用盲目回溯——彻底铲除了长期困扰数据科学与 Python 开发者的性能痼疾。通过保持对 Conda 插件体系的无缝集成,它既赋予了用户媲美 Mamba 的极速解析体验,又完整保留了既有的所有脚本与工作习惯。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















