


怎么向面试官解释pandas从2.3升级到3.0要注意什么?
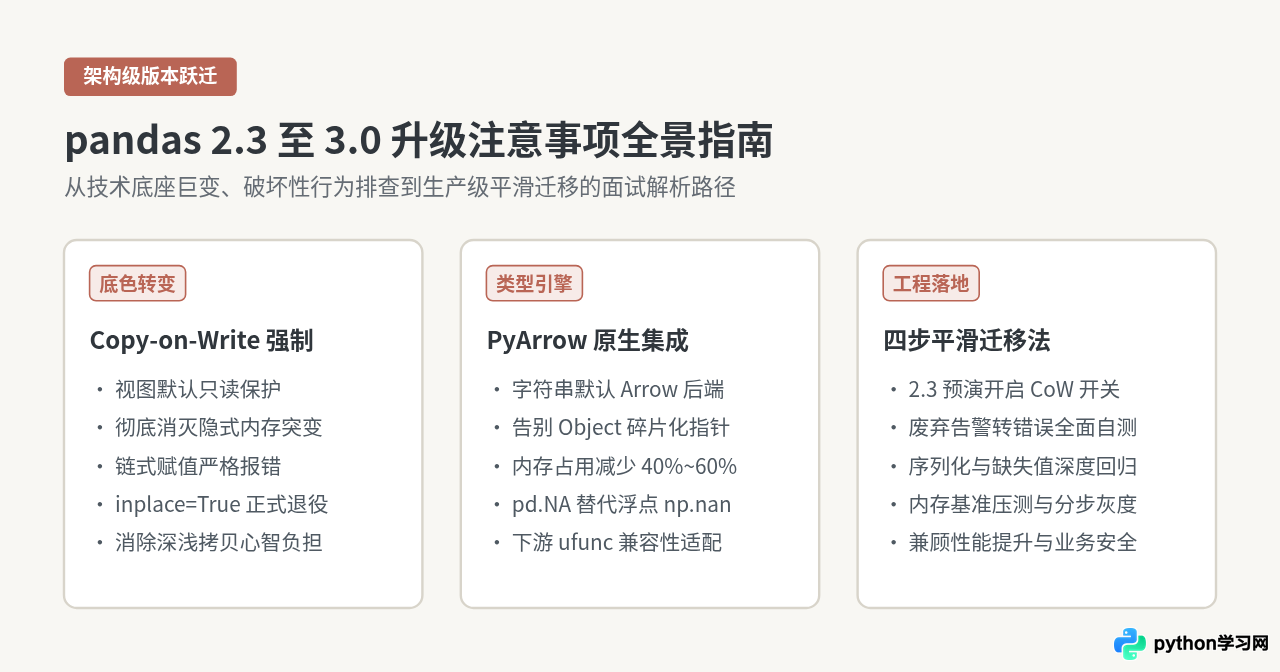
详细解析向面试官阐述pandas从2.3升级到3.0注意事项的核心框架,深入剖析Copy-on-Write默认启用、PyArrow原生存储与类型重构、API废弃清理及生产环境平滑迁移方案。
一、面试官的核心考察意图:为什么不能单纯背更新日志?
在技术面试中,面试官抛出“库版本升级”类问题,往往不是为了考察候选人的记忆力,而是借此评估两个关键维度:一是技术深度,考察候选人是否理解底层内存管理与类型系统的演进规律;二是工程成熟度,考察候选人面对重大版本迁移(Major Release)时,能否预判生产风险并制定体系化的安全迁移策略。
如果仅回答“有些参数被删除了”“速度变快了”,会被认为停留在初级调用者层面。高水平的作答应当把变化上升到架构层面:pandas 1.x 与 2.x 时代遗留的“视图还是副本”不确定性、链式赋值陷阱、以及 Python 对象指针带来的内存膨胀,在 3.0 版本中得到了彻底的根治。同时,这种根治伴随着强破坏性约束(Breaking Changes),对既有存量业务代码提出了明确的重构要求。
二、核心底色转变:Copy-on-Write(写时复制)全面默认强制落地
在 pandas 2.0 中,Copy-on-Write(CoW)作为可选实验特性被引入;而在 pandas 3.0 中,CoW 成为了全局不可关闭的默认行为。这是向面试官阐述的第一个、也是最核心的技术突破口。
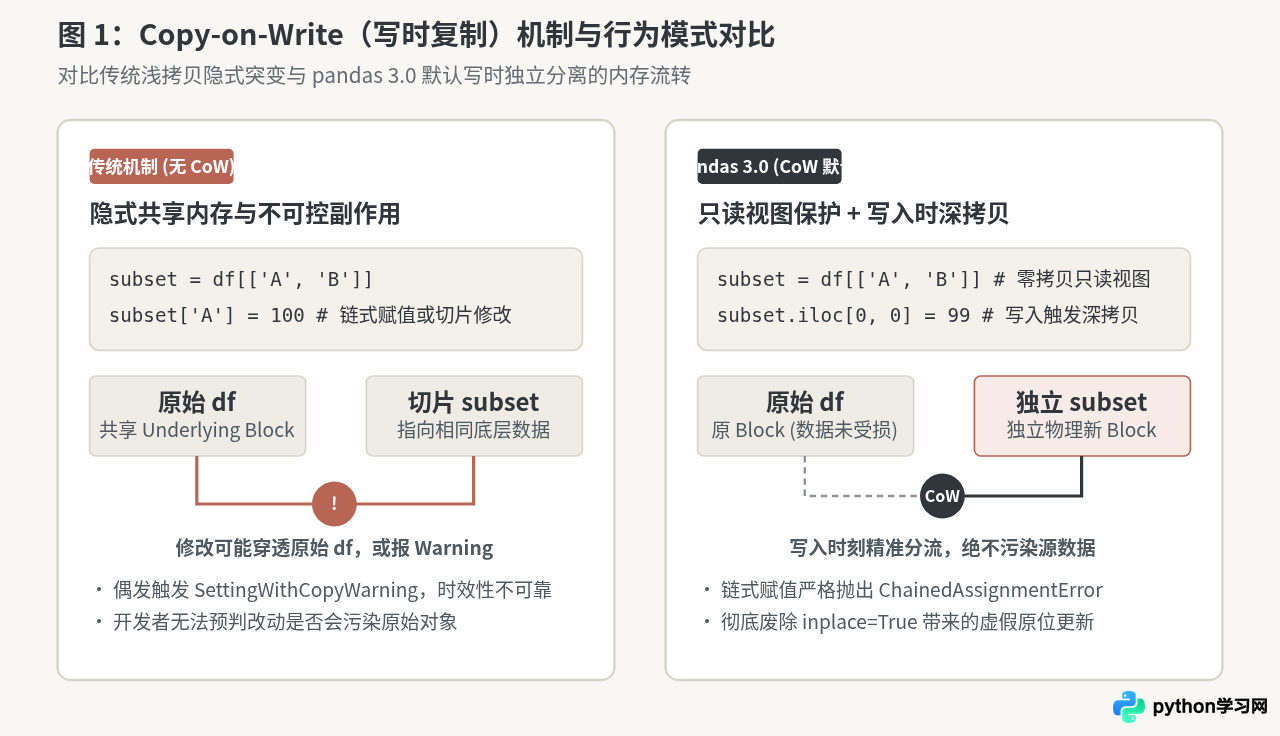
在传统的内存管理模型下,pandas 的切片赋值存在严重的模糊性:开发者无法确切预测一个子表究竟是源数据的浅拷贝视图(View)还是独立副本(Copy)。因此代码中常出现隐式的源数据污染,或者反过来,开发者修改了切片却发现改动未反映到原始表中,从而抛出令人困惑的 SettingWithCopyWarning。
1. 链式赋值由“警告”转为“严格抛错”
在 3.0 之前,诸如 df['col'][mask] = value 这类链式操作可能仅仅触发警告,但在 3.0 中,由于中间索引步骤返回的是受只读保护的视图,继续对该临时对象赋值将直接引发 ChainedAssignmentError,程序会彻底中断运行。
# 传统危险写法(pandas 3.0 中直接报错)
# 报错:ChainedAssignmentError: A value is trying to be set on a copy of a slice or view
df['age'][df['age'] < 0] = 0

# 推荐的正规写法:统一使用 loc 单步定位赋值
df.loc[df['age'] < 0, 'age'] = 0
2. 切片变动彻底与父表解耦
在 3.0 的 CoW 机制下,创建子切片(例如 sub = df.iloc[:10])是零拷贝开销的,只读模式下共享底层内存块。然而,一旦对 sub 执行任何写操作,pandas 会在写发生的一瞬间立即触发物理深拷贝,确保 sub 拥有独立的内存分配,而原始表 df 绝对不受任何干扰。
3. inplace=True 参数的全面退役
历史上诸如 df.dropna(inplace=True) 或 df.reset_index(inplace=True) 常被误认为能节省内存。事实上在 CoW 体系下,就地修改(Inplace)破坏了只读保护假定,且本质上往往依然产生新的内存块。因此在 3.0 中,大部分核心操作的 inplace 参数已被正式移除或严格弃用,必须显式采用变量重绑定模式:
# 旧写法(已废弃/移除)
df.drop(columns=['temp_col'], inplace=True)

# 3.0 标准工程写法
df = df.drop(columns=['temp_col'])
三、类型底座重塑:PyArrow 深度集成与 String/缺失值巨变
向面试官阐释升级注意事项时,第二个必须深入的要点是底层存储引擎与类型系统的升级。pandas 3.0 深度融合 Apache PyArrow,改变了沿用十多年的以 NumPy Object 为兜底的字符串管理方式。
1. 内存减半与缓存友好度提升
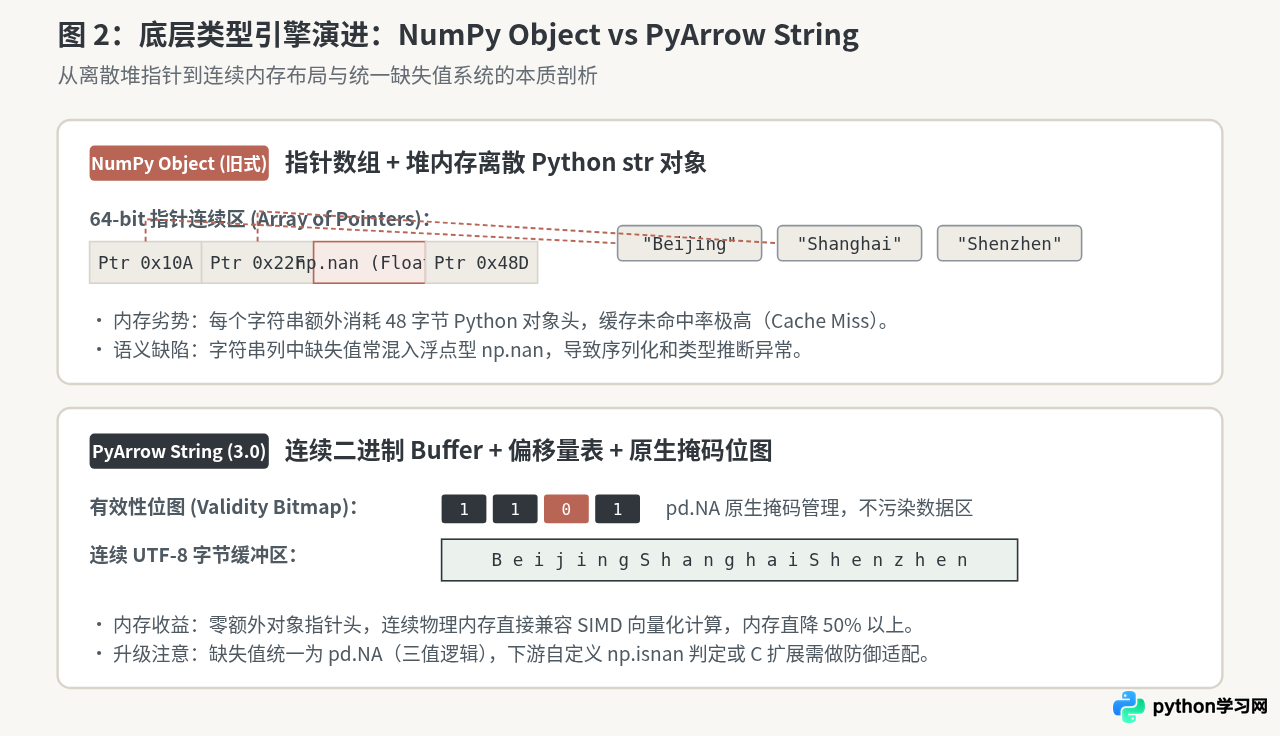
在 2.3 及更早版本中,普通字符串列使用的是 object dtype。底层的 NumPy 数组仅存储一串指向堆内存的 64 位指针,每个具体的 Python 字符串对象都带着 48 字节以上的对象头信息。这不仅导致海量内存浪费,而且连续遍历时 CPU 缓存命中率极差。
在 pandas 3.0 中,字符串列默认采用基于 PyArrow 的存储后端(string[pyarrow])。底层采用连续的 UTF-8 字节缓冲区与偏移量索引,免去了 Python 对象包装,实际工程中字符串密集型表格的内存开销可直接下降 40% 至 60%,文本过滤与正则匹配性能得到倍数级增强。
2. 缺失值类型的颠覆:pd.NA 对决 np.nan
面试中极易拉开差距的细节在于缺失值逻辑。在 NumPy Object 时代,缺失值常常被迫使用浮点型的 np.nan 替代;而在 PyArrow 原生模型中,每一列都由专门的 Validity Bitmap(有效性位图)管理掩码,缺失值严格呈现为原生的 pd.NA。
pd.NA 遵循三值逻辑(Three-valued logic)。例如 pd.NA == pd.NA 返回 <NA> 而不是 True 或 False。如果在既有业务中写过 x is np.nan 或者直接使用标准库 math.isnan(val),在 3.0 中会直接抛出类型异常。迁移时必须统一使用 pd.isna(val) 进行防御性判断。
| 特性维度 | pandas 2.3 (旧机制) | pandas 3.0 (新标准) | 生产代码影响与整改建议 |
|---|---|---|---|
| 默认字符串类型 | object (NumPy 指针) |
string[pyarrow] |
下游交互需确认接收类型,C-API 或 Cython 扩展需重构 |
| 缺失值表示 | np.nan (浮点标量) |
pd.NA (标量缺失对象) |
弃用 math.isnan(),全局采用 pd.isna() |
| 写时复制 (CoW) | 可选配置(默认关闭) | 全局强制开启(不可关闭) | 消灭链式切片赋值,所有切片写入视为独立操作 |
| inplace 支持 | 部分方法保留(抛告警) | 广泛移除 inplace 参数 | 改写为 df = df.func() 纯函数式赋值 |
四、历史包袱出清:集中退役的已废弃 API 与隐式规则
3.0 是集中清偿技术债务的重大节点,许多在 2.x 时代被标记为 FutureWarning 或 DeprecationWarning 的语法被正式移除。向面试官陈述时,需要列举 2 至 3 个有代表性的退役特性,佐证你对代码规范化的把控力:
- 禁止隐式向下类型转换(Silent Downcasting):以往
fillna、replace包含的downcast='infer'参数被正式移除。如果整型列填入浮点后希望缩小范围,必须由开发者显式调用astype()完成。 - 时区感知的严格比较:有时区(timezone-aware)与无时区(timezone-naive)的 Timestamp 之间,原本允许宽松比较或自动强制对齐,在 3.0 中被严格禁止,混合比较将直接抛出
TypeError。 - 淘汰已弃用的索引器与方法:诸如极早期的遗留参数、非规范切片用法全部清理,要求代码必须全面依靠
.loc、.iloc完成维度定位。
五、生产级工程保障:四步平滑升级实施路线图
讲完技术细节后,回答中最能体现“资深工程师”思维的环节,是给出从 2.3 跨入 3.0 的系统化演进路径。向面试官展现你不是一个盲目升级导致线上炸裂的鲁莽者,而是一位具备风险防御意识的架构管理者。
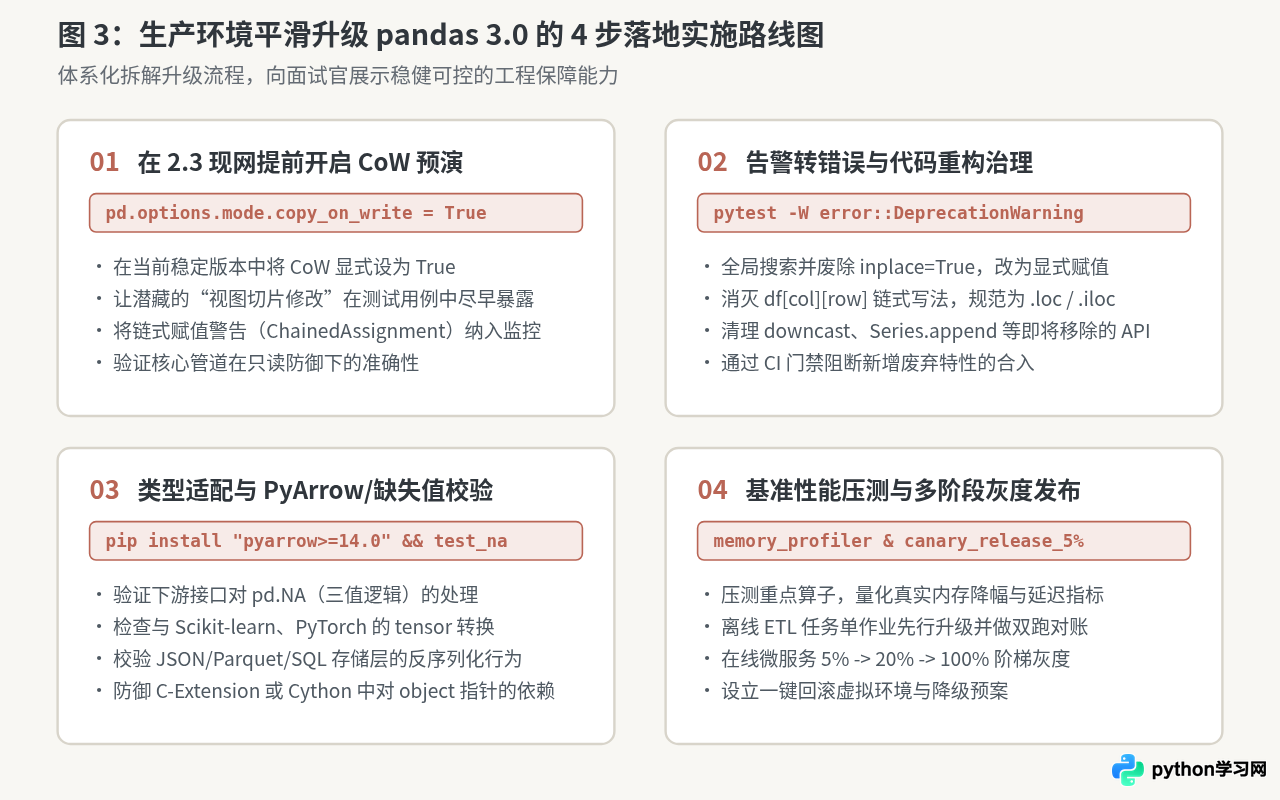
Step 1:在 2.3 现网提前开启 CoW 进行无损预演
不需要等到正式拉取 3.0 镜像才开始测试。在现有的 2.3 环境中,通过在项目初始化或入库脚本头部显式开启配置,提前暴露潜在问题:
import pandas as pd
# 在 2.3 环境中主动开启,提前暴露链式修改漏洞
pd.options.mode.copy_on_write = True
此时既有测试集如果存在隐式的切片修改依赖,测试用例会立即失败,便于在升级前夜就完成既有坏味道代码的重构。
Step 2:将测试套件的废弃警告转为错误
在 CI/CD 流水线中,调整 pytest 配置,将弃用警告视为致命异常:
pytest -W error::DeprecationWarning -W error::FutureWarning
这种“零容忍”策略能够自动把全工程里残存的 inplace=True、downcast 参数以及不规范索引点位一次性扫描出来,在合并主分支前完成拦截。
Step 3:验证下游生态与序列化兼容性
确认环境中正确安装了与 3.0 匹配的 pyarrow>=14.0。针对下游消费方(如 Scikit-learn 模型训练管道、FastAPI 的 JSON 响应序列化、SQL Alchemy 数据库读写)进行针对性断言:
- 检查自定义 JSON Encoder 是否能正确序列化
pd.NA; - 检查模型推理服务将 DataFrame 转换为 NumPy 矩阵(
to_numpy())时是否引发意外的类型提升(casting); - 重点验证涉及缓存与 RPC 调用的序列化/反序列化环节。
Step 4:性能与内存压测,分级灰度发布
通过 memory_profiler 或类似分析工具比对 2.3 与 3.0 在重点 ETL 管道中的峰值内存水位与执行时延。上线时遵从高容错到核心业务的推进行程:离线批处理作业优先升级并采用“双跑对账”,在线实时服务按 5% 到 20% 再到 100% 的流量阶梯平滑推进,并保持一键回滚虚拟环境的准备。
六、面试实战总结:一段 3 分钟的满分表达矩阵
在面试现场,候选人通常只有 2 到 3 分钟阐述这一问题。为了避免思维发散,应当建立清晰的汇报层次。
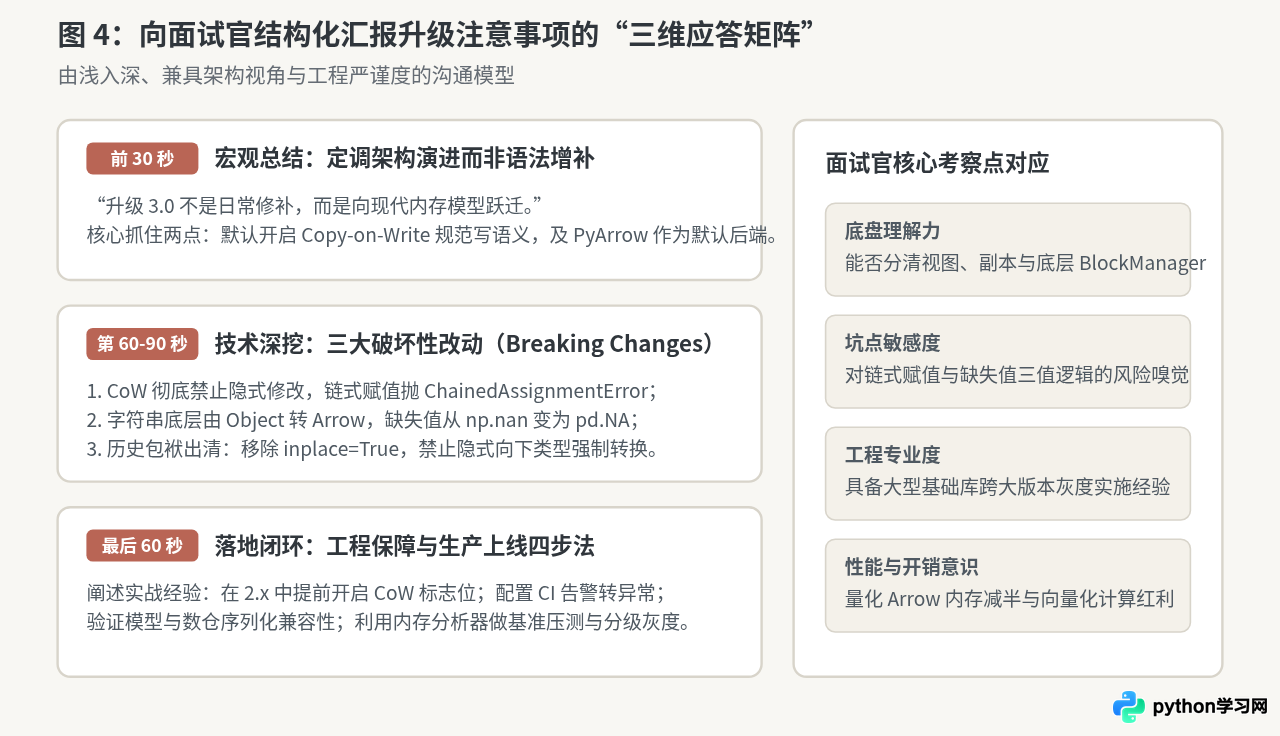
参考应答串联话术:
“向面试官阐明这个问题,我会将重点放在‘架构范式重构’和‘工程平滑落地’两个维度上。首先,pandas 3.0 的核心跃迁不是简单的 API 增补,而是底层内存模型与存储引擎的彻底现代化:一是默认全面启用 Copy-on-Write 机制,彻底终结了切片视图与副本的隐式副作用,链式赋值会直接抛错,inplace 参数也被正式废弃;二是默认采用 PyArrow 作为字符串底层后端,使内存占用大幅下降,但同时带来了缺失值由 np.nan 变为 pd.NA 的三值逻辑适配要求。”
“在生产迁移上,我们采取四步法保障平稳过渡:首先在现行的 2.3 环境中提前开启 CoW 标志位演练排查;其次在 CI 中将 DeprecationWarning 转为阻断错误,批量出清废弃参数;随后严密回归下游机器学习管道和序列化存储对 Arrow 类型与 pd.NA 的兼容性;最后通过真实基准压测评估内存收益,走分批灰度上线。这样既享受到 3.0 的性能与代码清晰度红利,又将生产故障风险控制在最低。”
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















