



CentOS 环境里的 C++ 服务,最容易出问题的往往不是单一漏洞,而是多个薄弱环节叠加:输入没收紧、编译没加固、服务权限过高、上线后又缺少持续监控。真正有效的做法,不是临时补一个点,而是把开发、部署、检测和维护串成一条完整链路。
下面按实际落地顺序拆开讲,从安全编码到系统加固,再到扫描、日志和审计维护。你可以把它当成一份 CentOS 下 C++ 应用的安全基线,用来判断当前项目哪些地方已经做到,哪些还只是“能跑”。
安全编码:先把最常见的漏洞入口收紧
对所有外部输入做验证和过滤
用户提交的数据、网络请求参数、文件读取内容,都属于外部输入,不能直接信任。上线环境里很多问题,都是从“输入格式默认正确”开始的。
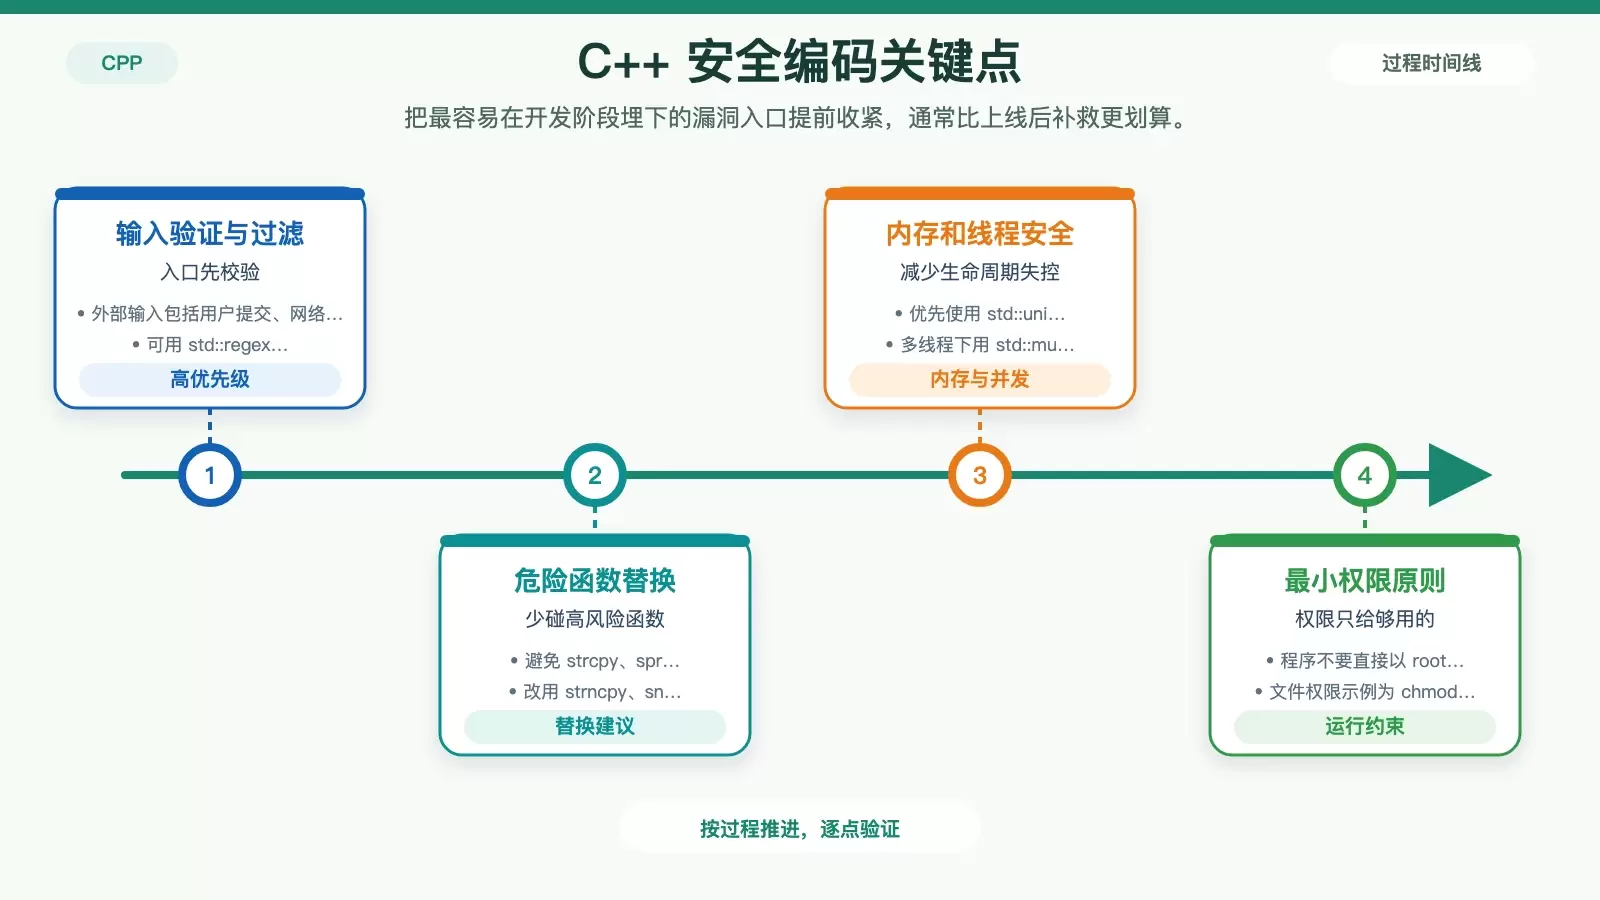
如果输入本身有明确格式,就应该先做格式校验。例如用 std::regex 检查数据是否为纯数字,能减少异常输入进入后续逻辑的机会。原文提到这类校验还能辅助防范 SQL 注入、XSS 等风险,核心思路是先把不符合预期的数据挡在入口之外。
在字符串处理上,优先使用 std::string 替代 C 风格字符串,也能明显降低缓冲区溢出的概率。
避免使用高风险函数和手动数组操作
strcpy、sprintf、gets 这类函数历史包袱很重,安全边界也弱,能不用就不要用。更稳妥的替代方案包括 strncpy、snprintf、fgets,前提是长度参数必须设置正确。
同样地,和手动维护数组相比,C++ 标准库容器更适合长期维护的业务代码,例如 std::vector、std::map。这类容器不能替你消灭所有逻辑错误,但至少能减少越界和生命周期管理失误带来的基础风险。
把内存、并发和异常一起纳入安全边界
裸指针使用越多,内存泄漏、悬空引用和重复释放这类问题就越难控。更实用的方式是优先使用智能指针,比如 std::unique_ptr、std::shared_ptr,把资源生命周期交给语言机制管理。
如果程序存在多线程访问共享资源的场景,还需要明确加锁策略。原文给出的做法是使用 std::mutex、std::lock_guard 保护共享资源,避免竞争条件进一步演变成数据破坏或不稳定行为。
异常处理也不能只停留在“加了 try-catch 就行”。未捕获异常会直接导致程序崩溃,而真正的安全要求还包括异常发生后资源不泄漏,并尽量满足基本保证或强保证。
运行权限要最小化,别让程序默认拿到 root 能力
很多 C++ 服务的风险并不是来自漏洞本身,而是漏洞一旦出现,进程权限过高导致破坏面被放大。比较稳妥的方式是为程序单独创建用户,例如 myappuser,只授予必需权限。
程序文件和目录权限也应同步收紧,例如:
chmod 750 /path/to/app这样可以限制无关用户随意读取或修改目标程序文件。
系统与编译配置:把运行环境一并加固
先补丁、再防火墙、再启用 SELinux
CentOS 自身和依赖软件包的更新,是修复已知漏洞最直接的一步。原文给出的常规更新命令如下:
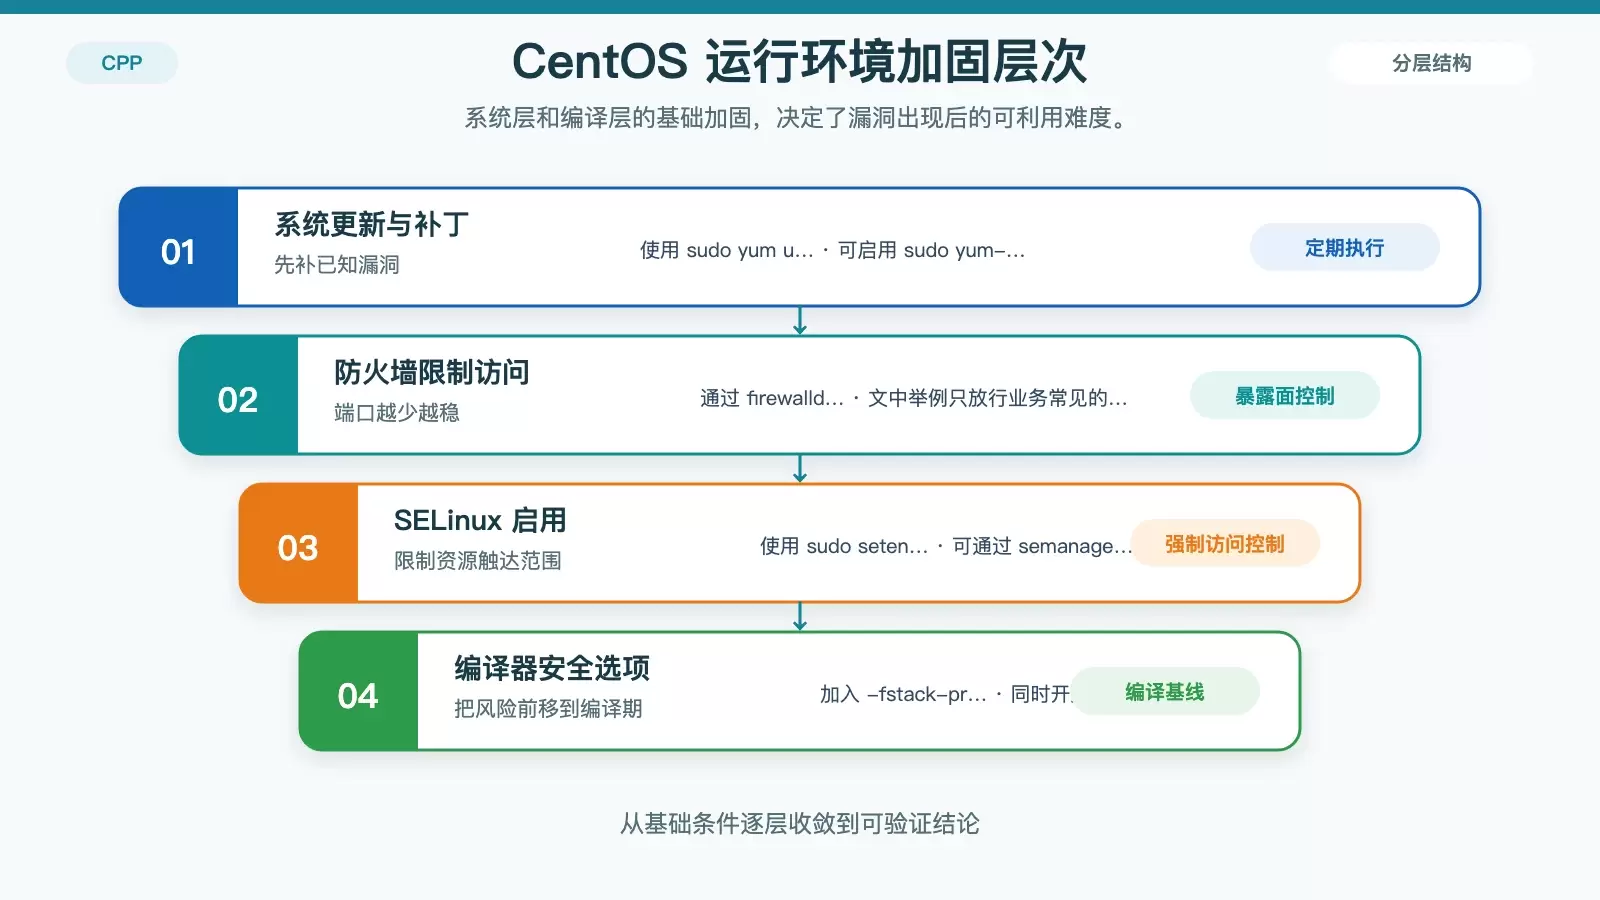
sudo yum update -y如果环境允许,也可以启用自动更新:
sudo yum-config-manager --enable rhui-REGION-rhel-server-extras网络侧则应通过 firewalld 严格限制对外暴露的端口,只开放业务确实需要的服务,例如 80 和 443。原文中的命令连在了一起,这里按正常执行方式整理如下:
sudo firewall-cmd --permanent --zone=public --add-service=https
sudo firewall-cmd --reload
另外,SELinux 不建议关闭。开启强制访问控制可以进一步约束程序对系统资源的访问范围:
sudo setenforce 1如有需要,还可以通过 semanage 调整程序的 SELinux 上下文。
编译阶段就开启基础安全保护
很多内存相关问题,等程序跑起来再发现,成本已经偏高。更实际的做法是在编译时直接启用安全选项,把一部分风险前移。
-fstack-protector-strong:启用栈保护,防止栈溢出。-D_FORTIFY_SOURCE=2:启用基础安全检查,辅助检测缓冲区溢出。-Wall -Wextra:打开更多编译警告,让潜在问题更早暴露。
这类参数不能替代代码审查,但它们是低成本、应该默认开启的安全基线。
安全检测工具:用静态分析和运行时检查补盲区
静态分析先筛一遍明显问题
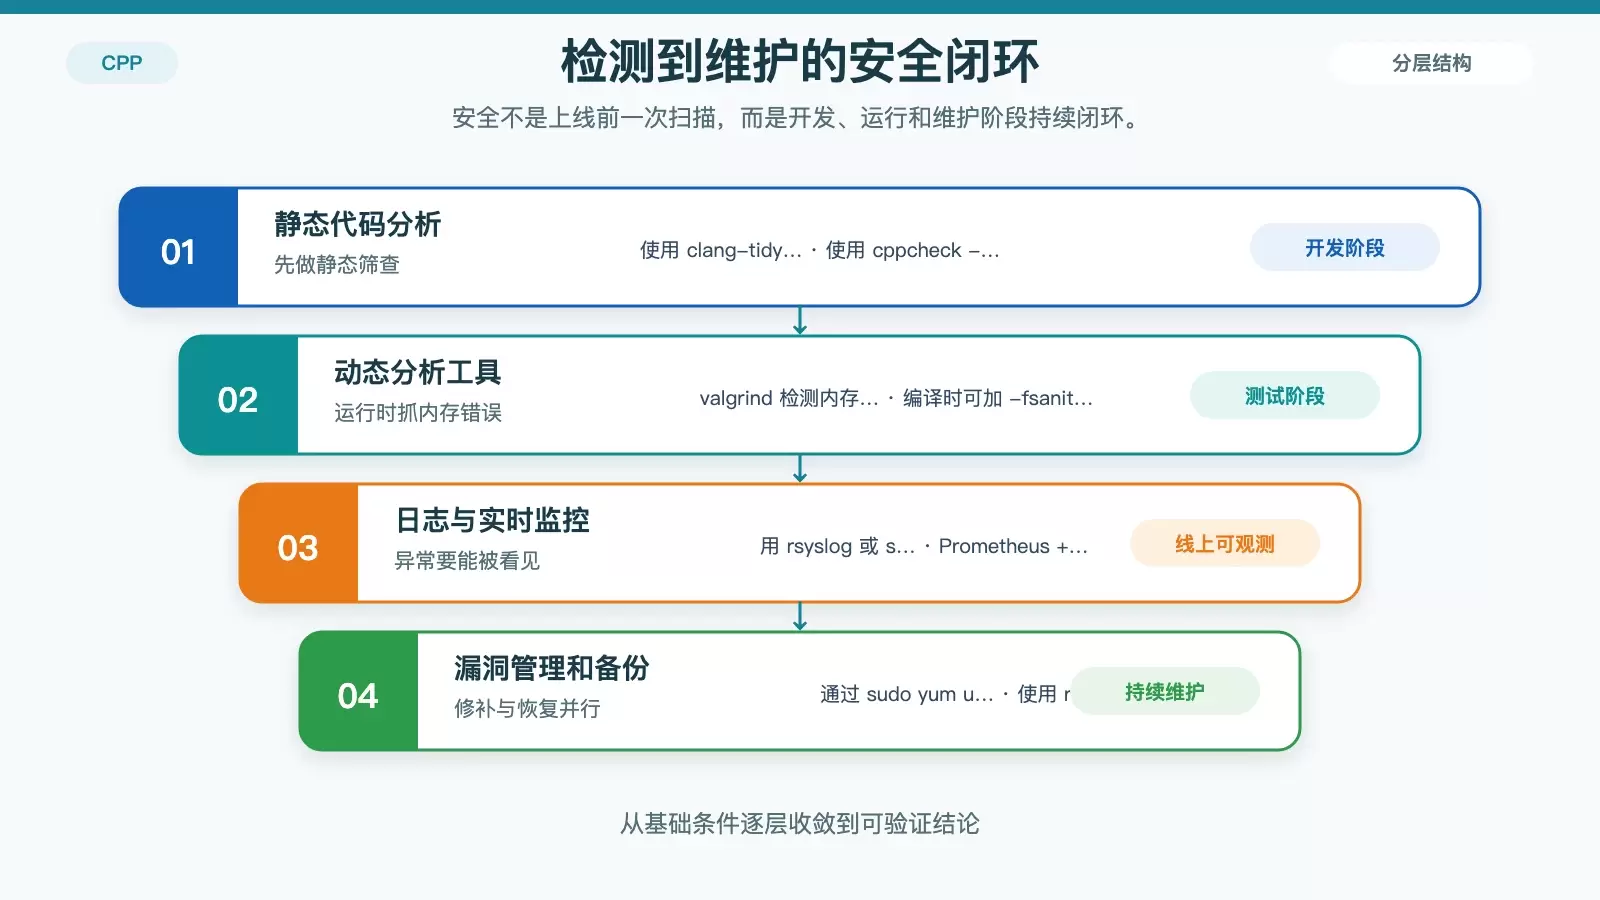
clang-tidy、cppcheck 适合放在日常开发和 CI 流程里,优先发现缓冲区溢出、空指针解引用等常见问题。原文给出的示例如下:
clang-tidy your_code.cpp -- -std=c++17
cppcheck --enable=all your_code.cpp
静态分析的价值在于覆盖面广、反馈快,适合持续执行,而不是只在出问题后临时跑一次。
动态分析重点查内存错误
对于静态分析难以完全确认的问题,运行时工具更有针对性。比如 valgrind 可以检查内存泄漏和非法内存访问,AddressSanitizer(ASan)则适合在测试阶段快速捕捉内存错误。
valgrind --leak-check=full ./your_app
g++ -fsanitize=address -g your_code.cpp -o your_app
如果项目本身就有大量指针操作或复杂对象生命周期管理,这一步尤其不能省。
系统级安全扫描也要纳入周期任务
仅检查业务代码还不够,系统服务和依赖库同样可能成为突破口。OpenVAS、Nessus 这类工具可以从主机和服务层面补充扫描,帮助发现 C++ 程序依赖的库、组件或系统服务中的已知漏洞。
日志与监控:让问题能被尽早发现和追踪
安全日志至少要覆盖异常、校验失败和权限变更
如果程序发生异常、输入校验失败或权限出现变化,但系统没有留下足够日志,后续排查往往只能靠猜。比较实用的做法是通过 rsyslog 或 spdlog 记录关键事件。
原文示例代码如下:
#include <spdlog/spdlog.h>
try {
    // 业务代码
} catch (const std::exception& e) {
    spdlog::error("Exception occurred: {}", e.what());
}
日志不必追求“全量记录一切”,但安全相关事件必须能查到、能关联、能回溯。
用指标监控补上运行态视角
Prometheus + Grafana 适合监控 CPU、内存、程序崩溃次数等运行指标,并设置告警阈值。对于线上服务来说,很多异常会先体现在资源波动、错误率上升或重启次数增加,而不是直接体现在代码层。
换句话说,日志解决“发生了什么”,监控解决“什么时候开始异常、影响有多大”。两者缺一不可。
定期审计与维护:把安全从一次性动作变成常规流程
代码审计要结合规范和工具结果一起看
团队代码审查不能只看功能对不对,也要检查输入验证、权限控制、内存管理等安全规范是否真正落地。更有效的做法,是把人工评审和静态分析结果放在一起看,优先修补高风险问题。
持续跟踪 CentOS 公告和 CVE 信息
运维阶段需要持续关注漏洞公告和依赖更新,不能等业务出事后再补。原文建议使用以下命令查看安全更新信息:
sudo yum updateinfo同时还要跟踪 CVE 数据库,例如 NVD,重点关注 C++ 程序依赖的库,比如 OpenSSL、Boost。如果出现远程代码执行这类高危漏洞,应立即停服务并打补丁,而不是排进“下个版本再处理”。
备份和恢复能力决定了事故后的下限
除了防漏洞,恢复能力也属于安全体系的一部分。代码、配置文件和关键数据都应定期备份,原文提到可以使用 rsync,并将备份存放到异地或云存储。
这样即使出现数据丢失、文件被篡改或服务被迫回滚,也能尽快恢复到可用状态。
一份可执行的 CentOS C++ 安全基线
如果要把全文压缩成落地清单,可以优先检查这几件事:输入是否严格校验、是否仍在使用高风险函数、编译参数是否包含安全选项、服务是否以最小权限运行、是否固定执行静态与动态检测、线上是否有日志和监控、是否建立了漏洞跟踪和备份恢复机制。
对 CentOS 上的 C++ 程序来说,安全从来不是“装一个工具”就能解决的问题。真正有效的方案,是让编码习惯、系统策略、检测机制和运维流程互相补位,尽量把问题挡在进入生产环境之前。















