


Numba即时编译(JIT)加速Python数值计算的原理与用法

Numba 是一个专门面向数值计算的开源 JIT(Just-In-Time)即时编译器。它通过在运行时捕获 Python 函数的字节码与实际参数类型,直接将其转换为 LLVM 中间表达(IR),最终编译成与硬件平台高度匹配的原生机器指令。本文将直接梳理 Numba 的底层编译原理、关键模式切换以及核心装饰器的工程用法,帮助读者在原生循环和 NumPy 数组运算中建立清晰的性能加速思路。
一、为什么原生 Python 计算存在性能瓶颈
标准 Python(CPython)在执行密集数值循环时,性能往往落后于 C/C++ 等编译型语言数倍乃至数十倍。这并非由于算法逻辑本身的差异,而是由 CPython 的运行时机制决定的:
- 动态类型与装箱开销:在 Python 中,每一个整数或浮点数都是一个完整的
PyObject结构体,包含引用计数、类型指针和数值本体。每次简单的算术操作都需要进行动态类型检查与解包。 - 解释执行循环:CPython 解释器在字节码层面通过一个庞大的评估循环(Eval Loop)逐条分发指令,无法像现代编译器那样利用指令重排、寄存器常驻以及 CPU 向量化指令集(如 AVX2、AVX-512)。
虽然 NumPy 将底层运算封装进了 C 语言拓展,但在需要自定义复杂条件分支、状态维护或细粒度遍历多维数组元素时,纯 Python 循环仍不可避免,这正是 Numba 发挥作用的核心场景。
二、Numba 的 JIT 编译原理与执行管线
与传统静态编译器(如 GCC、Clang)在运行前生成二进制程序不同,Numba 属于即时编译器(Just-In-Time Compiler)。它把编译推迟到函数第一次被调用且参数具体类型已知的时刻进行。
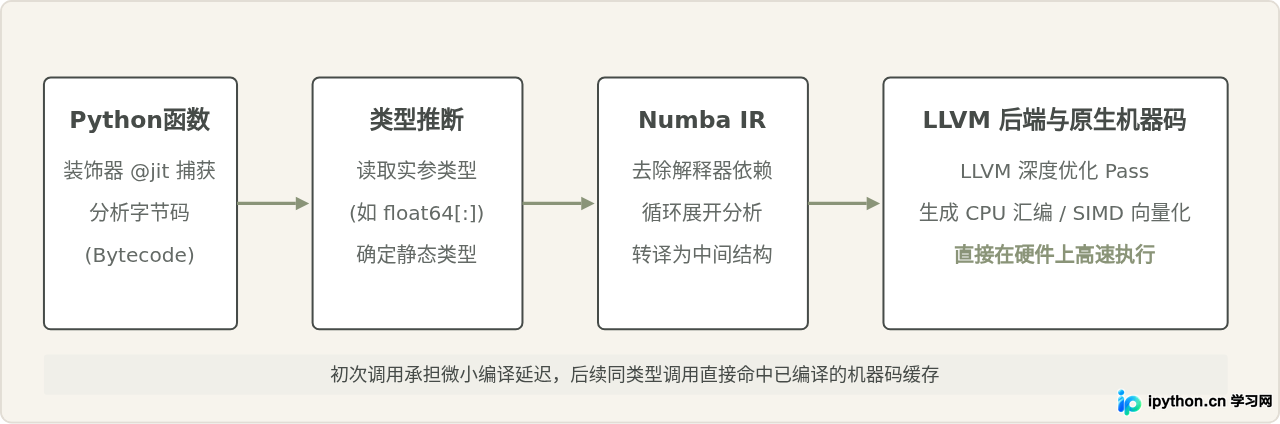
整个流水线包含四个核心阶段:
- 控制流图与字节码解析:当函数被修饰并首次调用时,Numba 首先分析其内部控制流图(CFG)与 Python 字节码,将其映射为自身设计的内部表示。
- 类型推断(Type Inference):由于 Python 无静态类型声明,Numba 观察传入参数在内存中的连续存储结构(例如由 NumPy 提供的连续双精度浮点数组)。一旦每个变量的底层类型被推断出来,整段逻辑即可转入强类型体系。
- 生成 LLVM IR:将带有具体类型的中间表示转化为通用的 LLVM 中间表达(LLVM Intermediate Representation)。
- 原生编译与缓存:LLVM 后端执行死代码消除、循环向量化等深度优化,直接向操作系统输出 CPU 能够直接执行的机器码。当下次传入相同数据类型时,系统跳过编译直接运行机器码。
三、核心模式:nopython 模式与 object 模式的对比
许多初学者认为只要加上 @jit 装饰器,任何代码都会提速,这是一种常见的误区。事实上,Numba 拥有两种完全不同的编译运行模式:
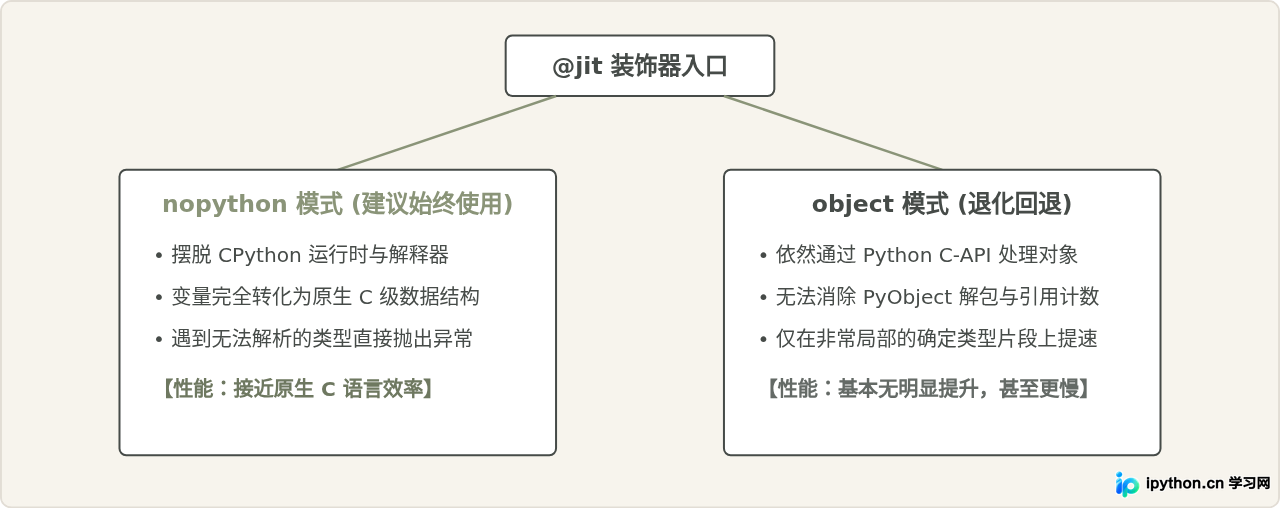
在默认情况下,若仅书写 @jit,当 Numba 无法将某些代码(如包含了未经支持的第三方库调用或动态字符串处理)转换为纯机器码时,会自动静默回退至 object 模式。这种回退通常不会带来明显的性能提速,反而增加了分析编译的额外开销。因此,在编写高性能生产代码时,应当始终显式使用 @njit(即 @jit(nopython=True))。若存在不兼容语法,程序会直接报错提醒修改,而不是以低效模式隐蔽运行。
四、基础与进阶用法指南
1. 环境准备与简单示例
可以通过标准 pip 包管理器安装 Numba 及其依赖项:
pip install numba numpy下面是一个典型的密集双重循环计算(欧氏距离矩阵计算)代码示例,展示如何用最少侵入的方式引入 Numba:
import numpy as np
from numba import njit
import time

# 使用 njit 强制进入 nopython 模式
@njit
def compute_distance_matrix(points):
    n = points.shape[0]
    dim = points.shape[1]
    dist_matrix = np.zeros((n, n), dtype=np.float64)
    for i in range(n):
        for j in range(n):
            sum_sq = 0.0
            for d in range(dim):
                diff = points[i, d] - points[j, d]
                sum_sq += diff * diff
            dist_matrix[i, j] = sum_sq ** 0.5
    return dist_matrix

# 生成 2000 个 3 维坐标点
data = np.random.rand(2000, 3)

# 第一次运行:包含 JIT 编译过程与计算
start = time.time()
res1 = compute_distance_matrix(data)
first_time = time.time() - start

# 第二次运行:直接执行已编译完成的原生指令
start = time.time()
res2 = compute_distance_matrix(data)
second_time = time.time() - start

print(f"首次执行(含编译)耗时: {first_time:.4f} 秒")
print(f"再次执行(纯机器码)耗时: {second_time:.4f} 秒")首次执行(含编译)耗时: 0.3852 秒
再次执行(纯机器码)耗时: 0.0094 秒
对比说明:相同算法在纯 Python 循环中执行往往需要数十秒,Numba 编译后提速可达百倍以上。
2. 多核并行与向量化:parallel 与 prange
对于各个循环迭代互相独立、不存在前后依赖的运算,Numba 支持自动多线程并行执行。将参数设为 parallel=True 并使用 numba.prange 替换内置的 range,即可利用系统的全部物理 CPU 核心:
from numba import njit, prange
import numpy as np

@njit(parallel=True)
def parallel_sum_squares(arr):
    n = arr.shape[0]
    result = np.zeros(n, dtype=np.float64)
    # prange 标识该循环可以由底层线程池并发分发
    for i in prange(n):
        result[i] = np.sum(arr[i] ** 2)
return resultprange 时必须确保没有竞态条件(Race Condition)。如果是累加求和,Numba 会自动识别标量归约(Reduction)操作并安全处理,但向共享数组的多重索引写入时需特别注意线程安全。
3. 循环融合与 fastmath 优化
浮点运算默认必须严格遵循 IEEE-754 标准,这会在一定程度上限制编译器执行重排与结合律优化。若业务场景对微小精度的严格合规性容忍度较高,可以通过开启 fastmath=True 释放更多算力:
@njit(fastmath=True)
def fast_eval(a, b):
    # 允许编译器将 a/b 转换为 a * (1/b) 或合并浮点乘加指令 (FMA)
    return np.sum(a * b + a)
五、从编写到落地的完整调试与操作步骤
在实际项目中引入 Numba 时,建议遵循结构化的改造与调优步骤,以避免出现难以追踪的类型推断报错或性能倒退。
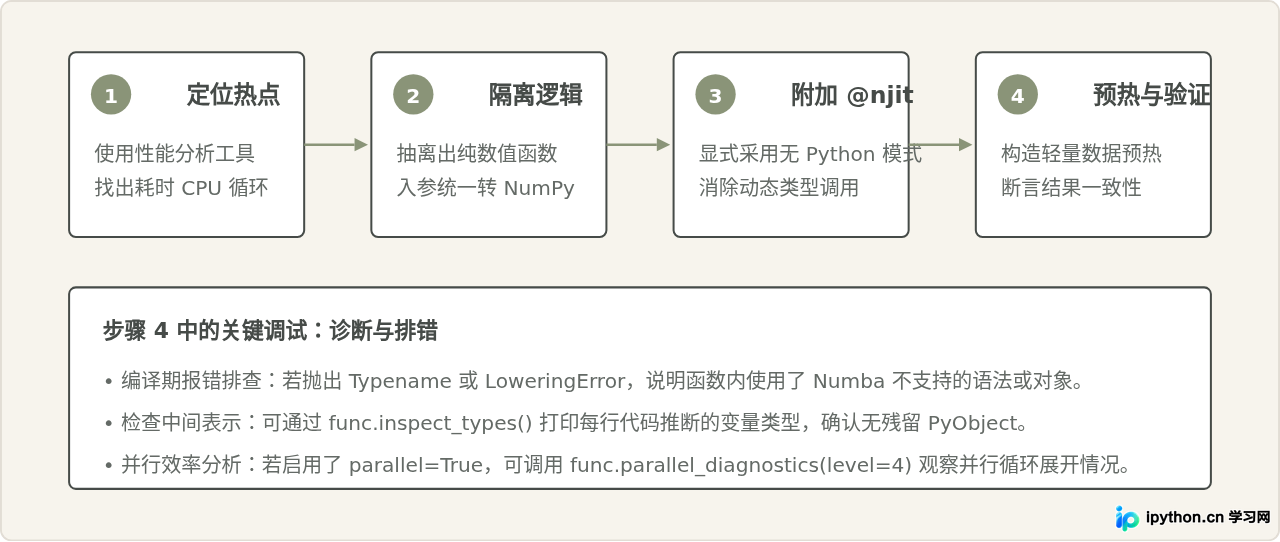
六、Numba 的适用边界与常见认知辨析
1. 容易混淆的说法:“只要是 Python 代码,加 @njit 都能提速”
辨析:该说法在纯密集数值计算的特定条件下是成立的,但在以下常见场景中完全不成立:
- I/O 密集型操作:读取文件、网络请求、数据库查询等耗时瓶颈在操作系统或硬件交互上,JIT 无法带来收益。
- 包含大量 Python 高阶容器与复杂对象:例如字典(dict)的复杂键查找、自定义对象类(class)调用、包含异构类型的列表解析。虽然 Numba 提供了
typed.Dict和typed.List,但易用性及性能优势远不及纯连续内存块(如 NumPy ndarray)。 - 已经高度向量化的成熟算子:若原本的代码已由成熟的 BLAS/LAPACK 库(如
np.dot、矩阵分解)支撑,且没有嵌套纯 Python 循环,Numba 能够带来的额外优化非常有限。
2. “首次执行延迟”的工程处理
JIT 编译本身需要占用 CPU 资源。如果服务对请求延迟极其敏感(例如线上高频实时预测系统),第一次请求落到尚未编译的函数上可能导致超时尖刺。解决这一现象的规范做法是服务启动时预热(Warm-up):在程序初始化阶段,使用一组尺寸极小的虚拟数据主动调用一次该函数,提前触发 JIT 编译并缓存机器码。
七、核心要点总结
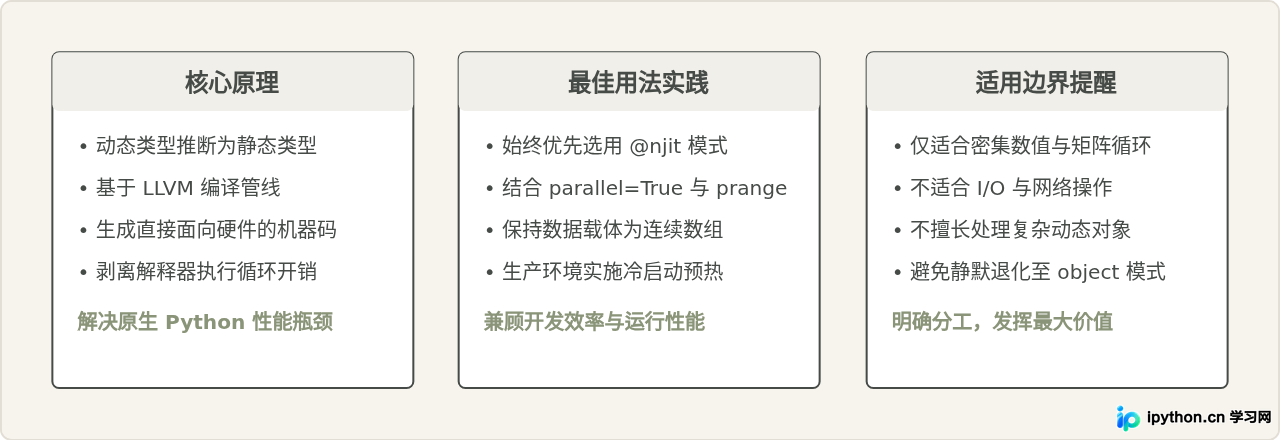
综上所述,Numba 的价值在于让开发者既能保留 Python 语言的简洁表达与快速原型构建能力,又能在关键数值循环段落中获取比肩 C/C++ 的执行性能。合理隔离数据流,始终坚持 @njit 模式,并在部署时加入预热机制,是利用 Numba 构建高效数值计算程序的关键所在。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















