


解决Python中pandas读取*.csv文件出现编码问题

发布时间:2026-10-11 |
2人浏览过
在使用Python的pandas库读取CSV文件时,常因文件编码格式(如GBK)与默认UTF-8不匹配而抛出UnicodeDecodeError。本文介绍如何通过指定encoding参数(如gbk)直接解决,以及利用文本编辑器转换文件编码的备用方案,确保数据顺利加载。
pandas读取CSV文件编码错误排查与解决
在使用 pandas.read_csv() 读取数据时,如果文件包含非UTF-8编码的字符(例如中文GBK编码),程序会抛出 UnicodeDecodeError。典型的错误信息如下:
Traceback (most recent call last):
  File "pandas\_libs\parsers.pyx", line 1134, in pandas._libs.parsers.TextReader._convert_tokens
  File "pandas\_libs\parsers.pyx", line 1240, in pandas._libs.parsers.TextReader._convert_with_dtype
  File "pandas\_libs\parsers.pyx", line 1256, in pandas._libs.parsers.TextReader._string_convert
  File "pandas\_libs\parsers.pyx", line 1494, in pandas._libs.parsers._string_box_utf8
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xa0 in position 19: invalid start byte
该错误表明pandas默认尝试使用UTF-8解码文件,但遇到了无法识别的字节序列(如 0xa0)。解决此问题主要有两种方法:在代码中指定正确的编码,或转换文件本身的编码格式。
方法一:在代码中指定编码(推荐)
最直接的方式是在调用 read_csv 时显式指定 encoding 参数。对于大多数包含中文的CSV文件,编码通常为 gbk 或 gb2312。
import pandas as pd

# 指定编码为gbk
pheno = pd.read_csv(pheno_path, encoding='gbk')
如果不确定具体编码,可以尝试 encoding='utf-8-sig'(处理带BOM的UTF-8文件)或 encoding='latin1'(作为最后手段,可解码所有字节但可能显示乱码)。
方法二:转换文件编码
如果无法修改代码,或者需要确保文件符合标准,可以手动转换文件的编码格式:
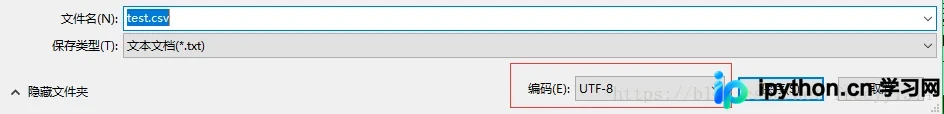
- 使用文本编辑器(如记事本、VS Code或Notepad++)打开CSV文件。
- 选择“另存为”选项。
- 在保存对话框中,将编码格式更改为
UTF-8。 - 保存文件,覆盖原文件或保存为新文件。
转换后,再次使用默认的 pandas.read_csv() 即可正常读取。
总结
处理CSV编码问题的核心在于确保读取代码与文件实际编码一致。优先建议在代码中通过 encoding 参数指定,这样既灵活又无需修改源文件。以上就是解决Python中pandas读取*.csv文件出现编码问题的详细内容,更多关于Python数据处理技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















