


Python Pandas数据集随机抽样方法详解

发布时间:2026-10-12 |
3人浏览过
本文介绍如何使用Python Pandas库对数据集进行随机抽样。通过DataFrame.sample()方法,可以指定抽取行数(n)、比例(frac)、是否放回(replace)及权重(weights)。此外,还探讨了利用Numpy进行索引抽样的替代方案,适用于不同场景下的数据采样需求。
使用Pandas进行随机抽样
在Python数据分析中,从大型数据集中提取代表性子集是一项常见任务。Pandas库提供了便捷的sample方法来实现这一目标。
sample方法参数详解
DataFrame.sample()方法支持多个参数来控制抽样行为:
- n:指定要抽取的行数。例如,抽取20000行数据。
- frac:指定抽取的比例(0到1之间的小数)。
- replace:布尔值,默认为False。设为True时表示有放回抽样(即可能重复抽取同一行)。
- weights:指定每个样本的权重,用于非均匀抽样。
- random_state:随机种子,确保结果可复现。
- axis:指定抽样的轴。0表示抽取行,1表示抽取列。
代码示例
以下示例展示了如何使用Pandas从数据集中随机抽取指定行数的数据:
import pandas as pd
# 假设df是你的DataFrame对象
df.sample(n=20000)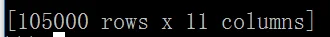
使用Numpy进行抽样
除了Pandas,还可以利用Numpy库进行随机抽样,特别是当需要基于索引进行抽样时。
Numpy抽样方法
使用np.random.sample()或相关函数,可以基于给定的索引列表进行抽样。这种方法适用于更底层的索引操作。
import numpy as np
# 假设Your_index是你想要抽样的索引列表
np.random.sample(Your_index)
总结
通过Pandas的sample方法和Numpy的随机抽样功能,可以灵活地从数据集中提取子集。选择哪种方法取决于具体的应用场景和需求。Pandas方法更直观,适合DataFrame对象;而Numpy方法则提供了更底层的控制。
以上就是Python Pandas数据集随机抽样方法的详细内容,更多关于Python数据处理、Pandas技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















