


Python3.6实现根据电影名称(支持电视剧名称),获取下载链接的方法

发布时间:2026-10-11 |
2人浏览过
本文介绍如何利用Python3.6结合urllib和BeautifulSoup库,根据电影或电视剧名称自动获取下载链接。通过构建搜索URL、解析HTML页面、提取详情链接及最终下载地址,实现自动化抓取。代码包含处理编码、过滤特定类型内容及模拟浏览器请求等关键步骤,适用于学习网络爬虫基础及数据提取技术。
实现思路与核心逻辑
该方案的核心在于模拟用户在电影网站上的搜索行为,并自动解析返回的页面以提取目标资源。整个过程可以分为以下几个关键阶段:
- 构造搜索请求:根据输入的电影名称,生成对应的搜索URL。由于部分网站对中文编码有特定要求(如GBK),需要进行相应的编码转换。
- 获取并解析HTML:使用
urllib发起HTTP请求,获取页面源码,并利用BeautifulSoup进行结构化解析。 - 提取详情链接:从搜索结果页中筛选出指向电影详情页面的链接,通常通过正则表达式匹配特定的ID格式来过滤无效链接。
- 获取下载地址:进入详情页面,提取包含下载链接(如迅雷链接)的
a标签,并整理成字典返回。
代码实现详解
1. 基础工具函数
首先,需要定义一个通用的HTML获取函数,用于处理网络请求。为了模拟浏览器行为,需添加User-Agent头,并处理可能的编码错误。
# -*- coding: utf-8 -*-
import urllib
from bs4 import BeautifulSoup
import re
#访问url,返回html页面
def get_html(url):
  req = urllib.request.Request(url)
  req.add_header('User-Agent','Mozilla/5.0')
  response = urllib.request.urlopen(url)
  html = response.read()
  return html
2. 构建搜索URL
根据电影名称生成搜索页面的URL。注意,部分网站(如示例中的dydytt.net)可能需要将中文关键词编码为GBK格式。
def get_movie_url(movie_name):#根据电影名称,生成搜索结果的URL
  host_url = 'http://s.dydytt.net/plus/search.php?kwtype=0&keyword='
  movie_sign = urllib.parse.quote(movie_name.encode('GBK'))
  search_url = host_url + movie_sign
  return search_url
3. 提取电影列表
从搜索结果页中提取所有指向电影详情页面的链接。通过正则表达式\d{8}匹配特定的ID格式,并排除主机域名内的链接,以确保获取的是有效的电影详情页。
#从搜索结果页面,提取电影的详情页面链接,存入列表返回
def get_movie_list(url):
  m_list = []
  html = get_html(url)
  soup = BeautifulSoup(html,'html.parser')
  fixed_html = soup.prettify()
  a_urls = soup.find_all('a')
  host = "http://www.ygdy8.com"
  for a_url in a_urls:
    m_url = a_url.get('href')
    m_url = str(m_url)
    if re.search(r'\d{8}',m_url) and (host not in m_url):
      m_list.append(host + m_url)
  return m_list
4. 解析详情页获取下载地址
进入电影详情页后,需要提取电影标题和所有下载链接。通过查找特定样式的td标签或包含thunder关键字的a标签,可以获取迅雷等下载工具的链接。
#从电影详情页面中获取此页面所有的的下载链接
def get_movie_download_url(html):
  soup = BeautifulSoup(html,'html.parser')
  fixed_html = soup.prettify()
  td = soup.find_all('td',attrs={'style':'WORD-WRAP: break-word'})
  down_urls = []
  for t in td:
    down_urls.append(t.a.get('href'))
  return down_urls
5. 整合流程与过滤
最后,将所有步骤整合,并添加对电影类型的过滤(如排除游戏和动画片),返回最终的下载链接字典。
#传入电影列表,获取每个电影的下载地址
def get_movie(movie_list):
  movie_dict = {}
  for i in range(0,len(movie_list)):
    html = get_html(movie_list[i])
    html = html.decode('GBK','ignore') #忽略编码错误
    m_title = get_movie_title(html)
    if u'游戏' not in m_title: #过滤游戏
      if u'动画' not in m_title: #过滤动画片
        m_url_list = get_movie_download_url(html)
        for m_url in m_url_list:
          movie_dict[m_url] = m_title
  return movie_dict
另一种实现方式:基于拼音搜索
部分网站(如kankanwu.com)可能采用拼音作为URL的一部分。此时可以使用xpinyin库将中文转换为拼音,并遍历不同类型的电影页面进行匹配。
# -*- coding: utf-8 -*-
from xpinyin import Pinyin
from bs4 import BeautifulSoup
from urllib import request,error
import time,re
import ssl
ssl._create_default_https_context = ssl._create_unverified_context #关闭https协议验证证书
def get_html(url): #访问url,返回html页面,如果url错误,则返回状态码,一般是404
  req = request.Request(url)
  req.add_header('User-Agent','Mozilla/5.0')
  try:
    response = request.urlopen(url)
    html = response.read()
    return html
  except error.HTTPError as e:
    return e.code
def get_m_html(movie_name):#根据电影名称,返回正确的电影html
  pin = Pinyin()
  pinyin_movie_name = pin.get_pinyin(movie_name,"")#不使用分隔符,默认是-
  movie_type = {
    "Sciencefiction":"科幻片",
    "Horror"    :"恐怖片",
    "Drama"     :"剧情片",
    "Action"    :"动作片",
    "Comedy"    :"喜剧片",
    "Love"     :"爱情片",
    "War"      :"战争片"
  }
  host = "https://www.kankanwu.com"
  for k,v in movie_type.items():
    movie_url = host + "/" + k + "/" + pinyin_movie_name + "/"
    html = get_html(movie_url)
    if isinstance(html,int):
      time.sleep(10)
    else:
      return html
def get_dload_url(html): #从电影html页面中获取下载地址
  movie_dict = {}
  soup = BeautifulSoup(html,'lxml')
  fixed_html = soup.prettify()
  a_urls = soup.find_all(href=re.compile("thunder"))#找到含有thunder链接的href
  for url in a_urls:
    m_title = url.get('title')
    m_url = url.get('href')
    movie_dict[m_title] = m_url
  return movie_dict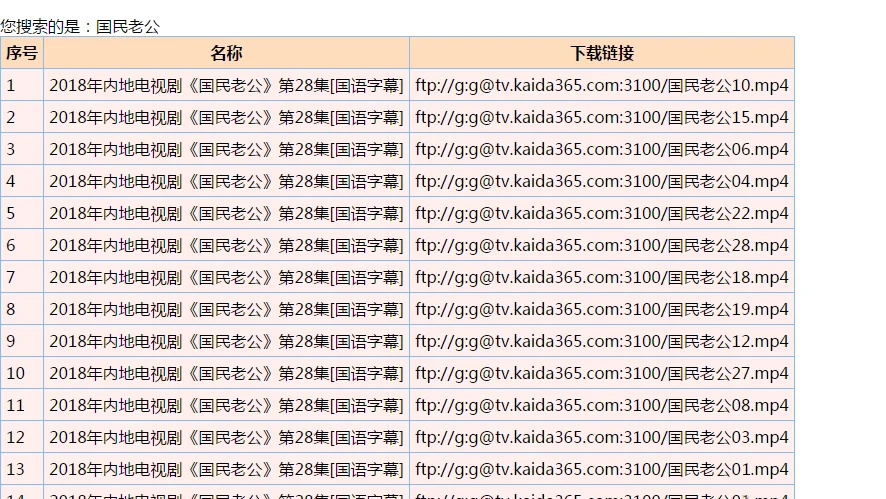
注意事项
- 编码处理:不同网站对中文编码的要求不同,需根据目标网站的实际编码(如GBK、UTF-8)进行相应处理。
- 反爬机制:部分网站可能设有反爬机制,如IP限制或验证码。在实际应用中,可能需要添加代理IP或使用更复杂的请求头。
- 法律风险:获取和使用下载链接时,请确保遵守相关法律法规,尊重版权,仅用于学习和合法用途。
以上就是Python3.6实现根据电影名称(支持电视剧名称),获取下载链接的详细内容,更多关于Python爬虫、电影下载、BS4、urllib的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















