


Python 使用 Camelot 库提取 PDF 表格数据

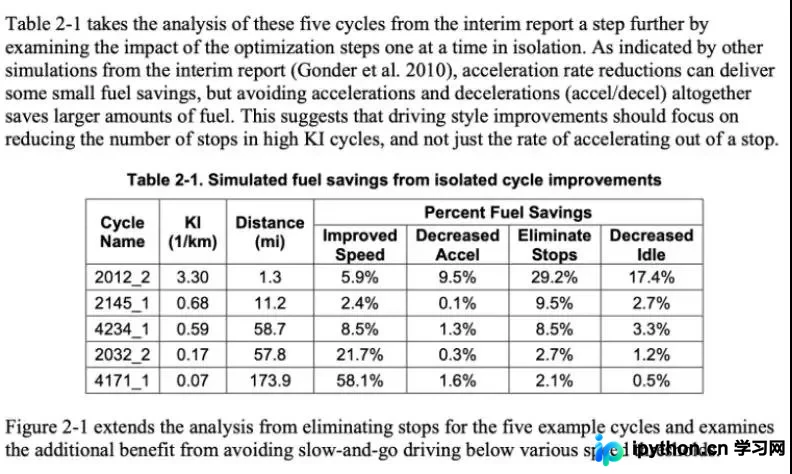
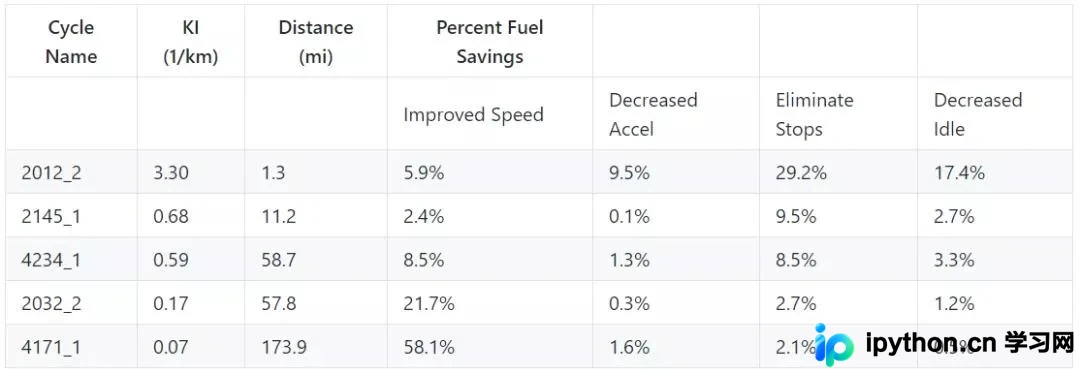
本文介绍如何使用 Python 的 Camelot 库从 PDF 文件中高效提取表格数据。通过简单的几行代码,即可将 PDF 表格转换为 Pandas DataFrame,并支持导出为 CSV、Excel 等多种格式。文章涵盖安装方法及核心 API 使用示例,帮助开发者快速处理文档数据。
Camelot 库核心功能
Camelot 是一个专为从 PDF 文档中提取表格数据设计的 Python 工具。其核心优势在于能够将 PDF 中的表格直接转换为 Pandas DataFrame 对象,从而无缝集成到现有的数据处理流程中。此外,该库支持指定多种输出格式,例如直接生成 CSV 文件。对于包含合并单元格的复杂表格,Camelot 会在抽取后自动进行空行处理,以保持数据的结构完整性。
安装方式
开发者可以通过多种途径安装 Camelot,具体取决于使用环境:
- 通过 Conda 安装:适用于 Conda 环境用户。
conda install -c conda-forge camelot-py- 通过 Pip 安装:适用于标准 Python 环境,需包含 cv 选项以支持图像处理。
pip install camelot-py[cv]- 从源码安装:适合需要定制或开发的用户。
git clone https://www.github.com/camelot-dev/camelot
cd camelot
pip install ".[cv]"
代码实现与数据导出
安装完成后,可以通过以下核心步骤提取并处理 PDF 表格。首先导入库并读取 PDF 文件,这类似于 Pandas 读取 CSV 文件的逻辑:
import camelot
tables = camelot.read_pdf('foo.pdf') # 类似于Pandas打开CSV文件的形式
提取后的数据存储在 TableList 对象中。可以通过索引访问具体的表格,并将其转换为 Pandas DataFrame:
tables[0].df # get a pandas DataFrame!Camelot 提供了丰富的导出选项,支持将数据保存为 JSON、Excel、HTML 或 SQLite 格式。以下是两种常见的导出方式:
- 使用 export 方法,可指定压缩选项:
tables.export('foo.csv', f='csv', compress=True) # json, excel, html, sqlite,可指定输出格式- 直接使用 DataFrame 方法导出:
tables[0].to_csv('foo.csv') # to_json, to_excel, to_html, to_sqlite, 导出数据为文件解析报告与结果验证
在提取过程中,Camelot 会生成解析报告,帮助用户评估提取质量。通过查看 tables 对象及其子项,可以获取表格形状和详细的解析指标:
tables
<TableList n=1>
tables[0]
<Table shape=(7, 7)> # 获得输出的格式
解析报告通常包含以下关键指标:
- accuracy(准确率):数值越高表示提取越精确。
- whitespace(空白率):反映表格内的空白区域比例。
- order(顺序):表示单元格读取的顺序是否正确。
- page(页码):指示表格所在的页面。
tables[0].parsing_report
{
 'accuracy': 99.02,
 'whitespace': 12.24,
 'order': 1,
 'page': 1
}
项目官方地址为 https://github.com/camelot-dev/camelot,开发者可在此获取更多文档与支持。
以上就是 Python 使用 Camelot 库提取 PDF 表格数据的详细内容,更多关于 Python 数据处理及 Camelot 库的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















