


Python NumPy ndarray对象核心用法与内存机制详解

本文深入解析Python Num库中ndarray对象的核心用法,涵盖从基础创建、形状属性修改到类型转换的完整流程。重点讲解arange、linspace等生成函数,以及fromstring、fromfunction等特殊创建方式。深入剖析ndarray的内存结构、C与Fortran格式差异、视图与副本的内存共享机制,并结合结构体数组与切片操作,帮助开发者高效掌握科学计算中的数组处理技巧。
写在前面
近期,笔者系统梳理了Python科学计算相关开源库的内容。尽管此前对部分功能有所接触,但知识体系较为零散。此次整理旨在归纳常用函数及注意事项,供初学者参考。文中涉及的函数命名与用法主要基于个人理解进行记录,并非完全遵循官方文档的声明格式。资深用户可酌情略过。
numpy.ndarray
numpy.ndarray创建
numpy.ndarray的构造方式多样,此处不再赘述。在科学计算的实际场景中,数据通常来源于文件读取,此时多使用pandas库进行读取操作。具体用法可参考官方文档或相关技术文章。
numpy.ndarray.shape & numpy.ndarray.reshape
可通过numpy.ndarray.shape属性获取数组的形状,该属性返回一个元组(tuple),反映了数组各维度的长度。
na_a = np.array([1,2,3,4]) #长度为4的一维数组
na_b = np.array([[1,2,3,4],[5,6,7,8]]) #2行4列的二维数组

out:
#print na_a
[1 2 3 4]
#print na_b
[[1 2 3 4]
 [5 6 7 8]]
#print na_a.shape
(4,)
#print na_b.shape
(2, 4)
numpy.ndarray.shape类似于C++中的public成员变量,既可用于读取,也可用于修改数组形状。当某一维度的值指定为-1时,该维度的长度将根据其他维度的长度自动计算得出。
na_b.shape = (4,2)
na_a.shape = (2,-1)

out:
#print na_b
[[1 2]
 [3 4]
 [5 6]
 [7 8]]
#print na_a
 [[1 2]
 [3 4]]
需特别注意:通过shape属性修改数组形状时,并未改变数组元素在内存中的存储位置,仅改变了数组的外观呈现,即所谓的“换马甲”。
若熟悉相关函数操作,也可使用ndarray.reshape()方法来改变形状。该方法返回的新数组与原数组共享内存空间,这意味着对其中一个数组元素的修改将同步反映在另一个数组上。
na_c = na_b.reshape((4,2))
na_c[0][0] = 100

out:
#print na_c
[[1 2]
 [3 4]
 [5 6]
 [7 8]]
#print na_c
[[100 2]
 [ 3 4]
 [ 5 6]
 [ 7 8]]
#print na_b
[[100 2]
 [ 3 4]
 [ 5 6]
 [ 7 8]]
numpy.ndarray.dtype
可通过dtype属性获取数组元素的类型,或在构造数组时指定类型。需注意,在NumPy中,float默认为64位,complex默认为128位。此处提及的float和complex为Python内置数据类型,NumPy定义了更细粒度的类型,如float16、float32、float64和float128等。
af = np.array([1,2,3,4], dtype=float)
ac = np.array([5,6,7,8], dtype=complex)
af.dtype
ac.dtype

dtype('float64')
dtype('complex128')
Python完整数据类型中大部分按所占字节数进行细化,完整类型定义在typeDict中,可通过numpy.typeDict.values()获取。NumPy在多维数组计算上效率极高,但在标量数值计算上可能比Python原生类型更慢,因此在进行纯数值计算时应谨慎使用NumPy。
numpy.ndarray.astype() 类型转换
numpy.ndarray.astype()方法可对数组中的元素逐一进行类型转换。
a = np.array([1,2,3,4], dtype=np.float)
a.dtype
dtype('float64')

b = a.astype(np.int32)
b.dtype
dtype('int32')

c.dtype
c = a.astype(np.complex)
c.dtype
dtype('complex128')
numpy.ndarray的自动生成
1. np.arange(start, end, step, dtype):指定起始值、结束值和步长生成等差数列,生成的数组不包含end值。
2. np.linspace(start, end, element_nums, endpoint, dtype):指定起始值、结束值和元素个数生成等差数列,通过endpoint参数控制是否包含end值,默认为True。
3. np.logspace(start, end, element_nums, base, endpoint):endpoint默认为True,base默认为10,该函数生成等比数列,元素为 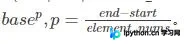 。
4. np.zeros(dim, dtype):将维度为dim的数组初始化为0,数据类型为dtype。
5. np.ones(dim, dtype):将维度为dim的数组初始化为1,数据类型为dtype。
6. np.empty(dim, dtype):该函数仅为数组分配内存空间,不进行初始化,因此产生的元素值不确定,切勿假设其为0。
7. np.full(dim, val, dtype):生成维度为dim的数组,并将所有元素初始化为val。前述的zeros()和ones()可视为该函数的特例。
8. 上述函数的like版本,即np.zeros_like(object)、np.ones_like(object)、np.empty_like(object)、np.full_like(object)。其中object为数组对象,生成的新数组维度(shape)和数据类型(dtype)与传入参数一致,例如np.zeros_like(object)等价于np.zeros(object.shape, object.dtype)。
9. fromstring(s, dtype):该函数功能有趣,可将字符串转换为数组对象。首先观察其输出情况。
s="abcdefgh"
np.fromstring(s)

array([ 8.54088322e+194]) ## 这是什么鬼?
### 输出一下dtype呢?
dtype('float64')
显然,此处按float64类型存储。若更换数据类型,结果会有何不同?
np.fromstring(s,dtype=np.int8)

array([ 97, 98, 99, 100, 101, 102, 103, 104], dtype=int8)
学过C语言的用户应知这是ASCII编码,由此可知Python中一个字符占8位(1字节)。继续观察:
np.fromstring(s,dtype=np.int16)

array([25185, 25699, 26213, 26727], dtype=int16)
此处将数据类型改为2个字节,即两个字符联合表示一个int16。例如25185=98*256+97,高位存放在低字节中,这符合小端模式。若需存储如['a','b'…'h']这样的数组对象,数据类型应为何种?应为‘|s1'。
np.fromstring(s,'|S1')

array(['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h'],
  dtype='|S1')
frombuffer()也可创建数组对象,但此时创建的数组与原字符串共享内存空间。C++中string类型为只读,无法修改,因此frombuffer()创建的数组不可修改。如需修改,请使用fromstring()。
fromfunction(fun, dim):通过自定义函数接口创建数组,fun为函数名(视为指针),dim为创建对象的维度。
def fun(i):
 return i%4+1
np.fromfunction(fun,(10,))

array([ 1., 2., 3., 4., 1., 2., 3., 4., 1., 2.])
可见,利用fromfunction()创建数组时,参数i从0开始自增,自增次数由维度大小决定。例如维度为(10,)的一维数组,i从0自增至9(共10次)。再看另一个例子:
def fun2(i,j):
 return (i+1)*(j+1)
np.fromfunction(fun2,(9,9))

array([[ 1., 2., 3., 4., 5., 6., 7., 8., 9.],
  [ 2., 4., 6., 8., 10., 12., 14., 16., 18.],
  [ 3., 6., 9., 12., 15., 18., 21., 24., 27.],
  [ 4., 8., 12., 16., 20., 24., 28., 32., 36.],
  [ 5., 10., 15., 20., 25., 30., 35., 40., 45.],
  [ 6., 12., 18., 24., 30., 36., 42., 48., 54.],
  [ 7., 14., 21., 28., 35., 42., 49., 56., 63.],
  [ 8., 16., 24., 32., 40., 48., 56., 64., 72.],
  [ 9., 18., 27., 36., 45., 54., 63., 72., 81.]])
行可视为j的自增,列可视为i的自增,因此可看作两个嵌套for循环。
numpy.ndarray的元素存取
存取方式与Python中list类似。
a = np.arange(10) #array([0, 1, 2, 3, 4, 5, 6, 7, 8, 9])
a[5]  #5
a[3:5] #[3,4]
a[:5] #[0,1,2,3,4]
a[:-1] #[0, 1, 2, 3, 4, 5, 6, 7, 8]

### 也可以指定步长,通过第三个数指定
a[1:-1:2] #从开始到结束,没隔两个数取一次 array([1, 3, 5, 7])
a[5:1:-2] #反向取 array([5, 3])
注意,通过这种方式获取的新数组与原始数组共享内存,因此任何一方的改变都会影响另一方。此外,NumPy还提供以下几种存取方式:使用list存取,list中的每个元素作为下标,这种方式得到的新数组与原始数组不共享内存。
a = np.arange(10)
a[[1,1,7,7]] #array([1, 1, 7, 7])
使用数组提取新数组,数组元素作为下标,得到的新数组维度与参数数组维度相同。这点较为复杂,请看示例:
a[np.array([2,1,3,6])] #array([2, 1, 3, 6])
a[np.array([[2,1,3,6],[7,4,6,1]])]
##
## array([[2, 1, 3, 6],
  [7, 4, 6, 1]])
使用bool数组提取,提取bool数组中为True的下标对应的元素:
a[np.array([True, False,True,False,False,False,True,False,False,False])]

## array([0, 2, 6])

a[np.array([True,False,True,False,False,False,True,False,False,False])]=-1,-2,-3
print a #array([-1, 1, -2, 3, 4, 5, -3, 7, 8, 9])
多维数组
请先看一张图:
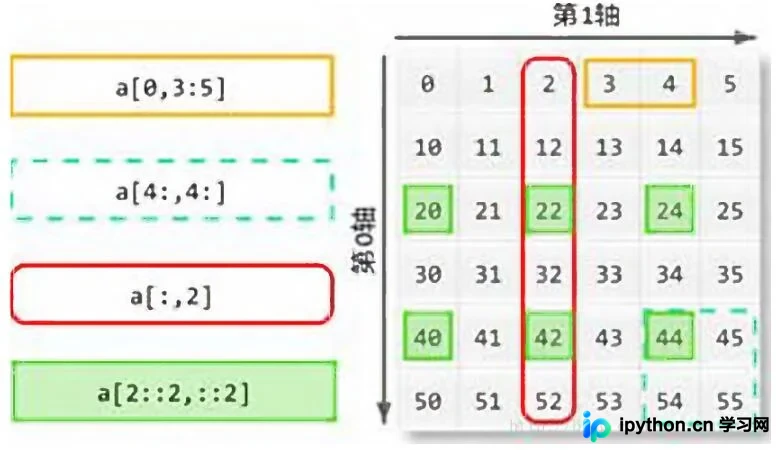
左侧展示了通过切片方式提取右侧6*6数组对象元素的过程。这种提取方式与原数组共享内存。
个人理解,利用切片方式提取的新数组与原数组共享内存,而使用列表、bool数组等方式则不共享。原因很简单:切片方式(如a[3:5])是从第三个元素到第五个元素(不含),通过元素所占字节数进行移动,类似C语言中的指针操作,较为便捷。其他方式使用下标,这些下标往往不连续,若采用指针方式则需频繁移动,较为繁琐,因此不提供内存共享。
此前切片均在[]中指定起点、终点及步长。若要单独创建切片对象,可使用slice对象,创建方式简单,将[]中的:替换为None即可。
a = np.arange(0,60,10).reshape(-1,1)+np.arange(6)
### 广播,后面会说到
array([[ 0, 1, 2, 3, 4, 5],
  [10, 11, 12, 13, 14, 15],
  [20, 21, 22, 23, 24, 25],
  [30, 31, 32, 33, 34, 35],
  [40, 41, 42, 43, 44, 45],
  [50, 51, 52, 53, 54, 55]])
a[::2,2:]
##
array([[ 2, 3, 4, 5],
  [22, 23, 24, 25],
  [42, 43, 44, 45]])
idx = slice(None,None,2),slice(2,None)
a[idx]
##
array([[ 2, 3, 4, 5],
  [22, 23, 24, 25],
  [42, 43, 44, 45]])
同时,NumPy提供了IndexExpression类的对象s_来方便slice的创建。
np.s_[::2,2:]
##
(slice(None, None, 2), slice(2, None, None))
结构体数组
NumPy提供了类似C的结构体数组,且可相互读取。以下通过一个例子说明:
## 创建persontype类型
persontype=np.dtype({
 'names':['name','age','weight'],
 'formats':['S30','i','f']}, align=True)
## 创建结构体数组
a=np.array([("zhang",20,55.5), ("wang",24,65.2)], dtype=persontype)
persontype包含两个键:names和formats。names以字典形式标明结构体字段,formats指定相应字段的数据类型。S30表示长度不超过30字节的字符串,i相当于np.int32,f相当于np.float32。在创建结构体数组时指定数据类型为我们创建的persontype。
## print a
array([('zhang', 20, 55.5  ), ('wang', 24, 65.19999695)],
  dtype={'names':['name','age','weight'], 'formats':['S30','<i4','<f4'], 'offsets':[0,32,36], 'itemsize':40, 'aligned':True})

## print a[0]
('zhang', 20, 55.5)
## a[0].dtype
dtype({'names':['name','age','weight'], 'formats':['S30','<i4','<f4'], 'offsets':[0,32,36], 'itemsize':40}, align=True)
## a[0]["name"]
'zhang'
b=a['age'] ## 20 24
b[0]=50
## print a[0]
('zhang', 50, 55.5)
通过tostring()和tofile()可将结构体数组写入文件,并可通过C语言读取。由于C语言中存在结构体对齐,因此在Python创建结构体数组时也需使用相应的对齐方式,这一点通过align参数指定,True为对齐,False不对齐。
ndarray内存结构
以二维数组对象为例,观察其在内存中的结构。
a = np.array([[0,1,2],[3,4,5],[6,7,8]], dtype=np.float32)
该二维数组结构如下图所示:
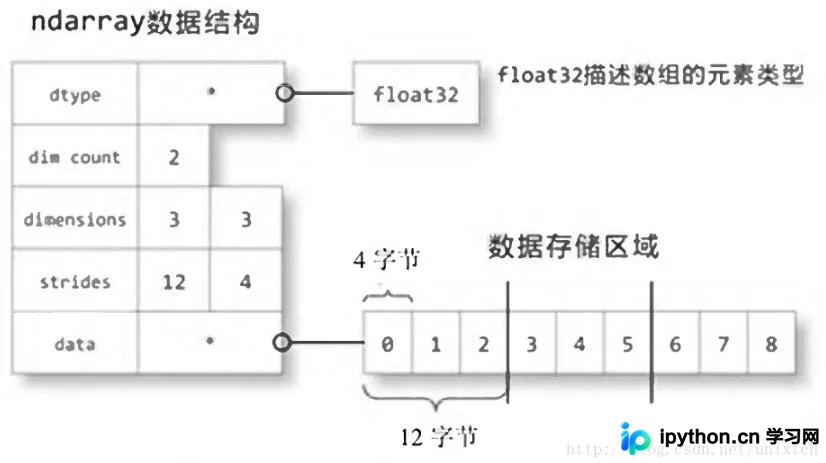
左侧为一个结构体,描述了数组的基本信息,包括数据类型(np.float32)、维度(轴的数量)、每个轴的数据个数、每个轴相邻元素的字节差,最后是存放数据的内存地址。通过切片方式得到的新数组即在data字段表示的内存上获得原始数组的视图,我们来看看:
b=a[::2,::2]
## b
array([[ 0., 2.],
  [ 6., 8.]], dtype=float32)
## b.strides
(24, 8)
获得的新数组strides发生了变化,该变化恰好对应每个轴相邻元素跨越的字节数。数组在内存中的排列有两种形式,分别是C和FORTRAN格式。上文展示的是C格式,第0轴位于最上位,即第0轴作为行,因此第0轴相邻元素跨越的字节数最多(例如此处为3*4=12)。而FORTRAN结构与C格式相反,第1轴跨越的字节数最多。NumPy默认采用C格式,若需改为FORTRAN格式,只需在创建数组时设置order='F'。数组的flags属性描述了存储区的一些属性:
## a.flags
C_CONTIGUOUS : True  #C语言格式
F_CONTIGUOUS : False #Fortran语言格式
OWNDATA : True   #数组是否拥有该存储区,如果是一个narray的视图则不拥有
WRITEABLE : True  #是否可写 (改变其中数据)
ALIGNED : True   # 对齐
UPDATEIFCOPY : False
OK,这里引出一个问题,若要将a进行转置,是否只需将a顺时针旋转90°?是否有更简单的方法?我们先看看a.T.flags:
## a.T.flags
 C_CONTIGUOUS : False
 F_CONTIGUOUS : True
 OWNDATA : False
 WRITEABLE : True
 ALIGNED : True
 UPDATEIFCOPY : False
从上述输出可见,对于a的转置,NumPy改变了其内存格式,从C语言格式变为Fortran格式,且转置后的a是原数组的一个视图。这种方式比物理旋转更加快速。
以上关于Python科学计算中ndarray对象用法的介绍即为全部内容,希望能对大家有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















