


Python scipy 计算概率密度、累计分布及逆函数详解

本文介绍如何使用 Python 的 scipy 库计算连续与离散随机分布的概率密度(pdf)、累计分布(cdf)及逆函数(ppf)。通过正态分布、二项分布等示例,展示 loc 和 scale 参数的调整方法。此外,深入解析基于 CDF 逆函数生成随机数的两种实现路径:公式法与数值模拟法,并附带伯努利分布生成的代码示例。
在计算概率分布相关参数时,通常使用 scipy 库。常用的统计函数主要包括以下几类:
pdf:用于计算连续随机分布的概率密度函数值。
pmf:用于计算离散随机分布的概率质量(密度)函数值。
cdf:累计分布函数,表示随机变量小于或等于某值的概率。
ppf:百分位点函数,即累计分布函数的逆函数。
lsf:生存函数的逆函数,对应于 1 减去 cdf 后的逆运算。
这些函数不仅支持标量输入,也支持数组输入。以下以正态分布为例进行说明:
>>> import scipy.stats as st

>>> st.norm.cdf(0) # 标准正态分布在 0 处的累计分布概率值
0.5

>>> st.norm.cdf([-1, 0, 1])# 标准正态分布分别在 -1, 0, 1 处的累计分布概率值
array([0.15865525, 0.5, 0.84134475])

>>> st.norm.pdf(0) # 标准正态分布在 0 处的概率密度值
0.3989422804014327

>>> st.norm.ppf(0.975)# 标准正态分布在 0.975 处的逆函数值
1.959963984540054

>>> st.norm.lsf(0.975)# 标准正态分布在 0.025 处的生存函数的逆函数值
1.959963984540054
针对非标准正态分布,可以通过调整 loc(均值)和 scale(标准差)参数来改变分布形态:
>>> st.norm.cdf(0, loc=2, scale=1) # 均值为 2,标准差为 1 的正态分布在 0 处的累计分布概率值
0.022750131948179195
其他随机分布可能涉及不同的参数调整,具体需参考官方文档。以下列举几种常用分布的计算示例:
>>> st.binom.pmf(4, n=100, p=0.05) # 参数值 n=100, p=0.05 的二项分布在 4 处的概率密度值
0.17814264156968956

>>> st.geom.pmf(4, p=0.05) # 参数值 p=0.05 的几何分布在 4 处的概率密度值
0.04286875

>>> st.poisson.pmf(2, mu=3) # 参数值 mu=3 的泊松分布在 2 处的概率密度值
0.22404180765538775

>>> st.chi2.ppf(0.95, df=10) # 自由度为 10 的卡方分布在 0.95 处的逆函数值
18.307038053275146

>>> st.t.ppf(0.975, df=10) # 自由度为 10 的 t 分布在 0.975 处的逆函数值
2.2281388519649385

>>> st.f.ppf(0.95, dfn=2, dfd=12) # 自由度为 2, 12 的 F 分布在 0.95 处的逆函数值
3.8852938346523933
补充拓展:基于给定概率密度生成随机数的 Python 实现方法
实现该目标的方法有多种,常见的包括:
拒绝采样法(rejection sampling)
逆 CDF 法(invert the cdf)
Metropolis 算法(MCMC 方法之一)
本文重点介绍基于累积分布函数逆函数(即方法 2:invert the CDF)的生成策略。
以下理解仅为个人总结,如有错误欢迎指正。
目标设定:
已知概率密度函数 y=pdf(x),现需根据给定的 pdf 生成符合该分布的 x 值。
PDF 是概率密度函数,对其积分(连续)或求和(离散)可得 CDF(累积分布函数)。PDF 的积分或求和结果恒为 1。
具体步骤(详细解释见后文):
1. 根据已知的 pdf 推导或计算 cdf。
2. 由 cdf 求得其逆函数(inverse of the cdf)。
3. 生成服从 [0,1) 均匀分布的随机数,将其代入逆 cdf 函数,所得结果即为符合目标分布的 x 值。
求 cdf 逆函数的具体实现方法:
针对上述第二步,可分为两种情况处理:
1. 若 cdf 的逆函数解析解易于求得,直接利用公式计算。
2. 若 cdf 的逆函数难以解析求解,则采用数值模拟方法近似处理。
个人理解:为何需要通过 cdf 的逆函数来获取 x?
原因一:
因为 cdf 是单调递增函数,因此必然存在逆函数。相比之下,pdf 不一定是单调的(例如正态分布呈钟形,不单调),对于给定的 y 值,可能存在两个对应的 x 值,导致直接求逆不可行。
原因二:
这仅是直观理解,参考下图(左上为 pdf,右上为 cdf)。
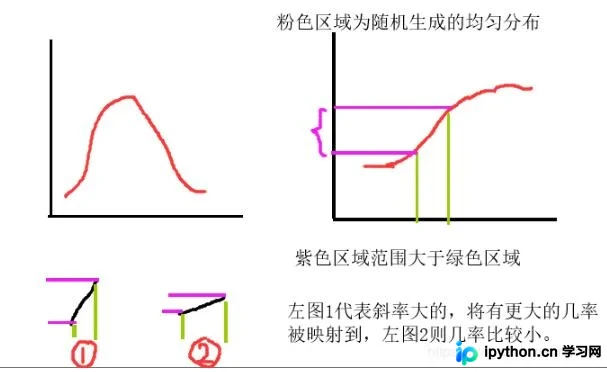
根据步骤 3,我们首先生成 [0, 1) 区间内的均匀随机数,将该随机数作为 cdf 的 y 值,映射到 cdf 对应的 x 值(若用逆函数表示,即由 x 映射到 y)。参考上图右侧,由于 cdf 的 y 值是均匀分布的,那么在 cdf 中斜率较大的部分(对应 pdf 值较大),会有更大的概率被映射到,因为其对应的 y 范围更宽(而 y 是均匀随机的)。换言之,cdf 的斜率等同于 pdf 的值,这正好符合若 x 的 pdf 较大,则该 x 出现概率更高的直观逻辑(即重复多次后,该 x 出现的频次最高)。
代码实现——方法一:公式法
import numpy as np
import math
import random
import matplotlib.pyplot as plt
import collections

count_dict = dict()
bin_count = 20

def inverseCDF():
 """
 return the x value in PDF
 """
 uniform_random = random.random()
 return inverse_cdf(uniform_random)


def pdf(x):
 return 2 * x

# cdf = x^2, 其逆函数很好求,因此直接用公式法
def inverse_cdf(x):
 return math.sqrt(x)


def draw_pdf(D):
	global bin_count
 D = collections.OrderedDict(sorted(D.items()))
 plt.bar(range(len(D)), list(D.values()), align='center')
 # 因为映射bin的时候采用的floor操作,因此加上0.5
 value_list = [(key + 0.5) / bin_count for key in D.keys()]
 plt.xticks(range(len(D)), value_list)
 plt.xlabel('x', fontsize=5)
 plt.ylabel('counts', fontsize=5)
 plt.title('counting bits')
 plt.show()

for i in range(90000):
 x = inverseCDF()
 # 用bin去映射,否则不好操作
 bin = math.floor(x * bin_count) # type(bin): int
 count_dict[bin] = count_dict.get(bin, 0) + 1

draw_pdf(count_dict)
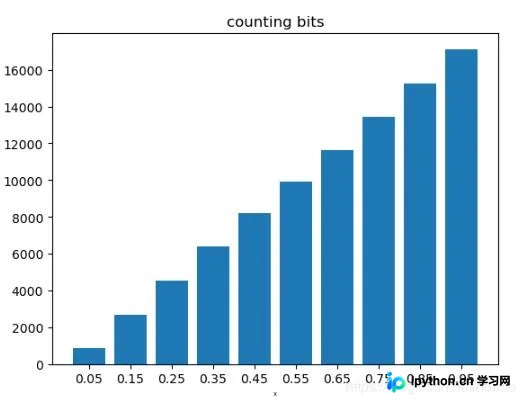
运行结果如下:
代码实现——方法二:数值法
数值模拟 cdf 的关键在于创建查找表(lookup table)。
表格的 size 越大,结果越接近真实分布(即区间划分的粒度越细)。
import numpy as np
import math
import random
import matplotlib.pyplot as plt
import collections

lookup_table_size = 40
CDFlookup_table = np.zeros((lookup_table_size))

count_dict = dict()
bin_count = 20

def inverse_cdf_numerically(y):
 global lookup_table_size
 global CDFlookup_table
 value = 0.0
 for i in range(lookup_table_size):
  x = i * 1.0 / (lookup_table_size - 1)
  value += pdf2(x)
  CDFlookup_table[i] = value
 CDFlookup_table /= value # normalize the cdf

 if y < CDFlookup_table[0]:
  t = y / CDFlookup_table[0]
  return t / lookup_table_size
 index = -1
 for j in range(lookup_table_size):
  if CDFlookup_table[j] >= y:
   index = j
   break
 # linear interpolation
 t = (y - CDFlookup_table[index - 1]) / \
  (CDFlookup_table[index] - CDFlookup_table[index - 1])
 fractional_index = index + t # 因为index从0开始,所以不是 (index-1)+t
 return fractional_index / lookup_table_size


def inverseCDF():
 """
 return the x value in PDF
 """
 uniform_random = random.random()
 return inverse_cdf_numerically(uniform_random)


def pdf2(x):
 return (x * x * x - 10.0 * x * x + 5.0 * x + 11.0) / (10.417)

def draw_pdf(D):
 global bin_count
 D = collections.OrderedDict(sorted(D.items()))
 plt.bar(range(len(D)), list(D.values()), align='center')
 value_list = [(key + 0.5) / bin_count for key in D.keys()]
 plt.xticks(range(len(D)), value_list)
 plt.xlabel('x', fontsize=5)
 plt.ylabel('counts', fontsize=5)
 plt.title('counting bits')
 plt.show()


for i in range(90000):
 x = inverseCDF()
 bin = math.floor(x * bin_count) # type(bin): int
 count_dict[bin] = count_dict.get(bin, 0) + 1

draw_pdf(count_dict)
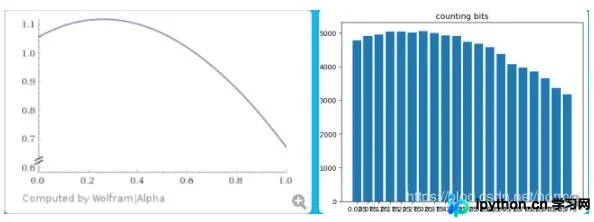
真实函数曲线与数值模拟结果的对比图。
扩展应用:生成伯努利分布与正态分布随机数。
import numpy as np
import matplotlib.pyplot as plt
"""
reference:
https://blog.demofox.org/2017/07/25/counting-bits-the-normal-distribution/
"""


def plot_bar_x():
 # this is for plotting purpose
 index = np.arange(counting.shape[0])
 plt.bar(index, counting)
 plt.xlabel('x', fontsize=5)
 plt.ylabel('counts', fontsize=5)
 plt.title('counting bits')
 plt.show()


# if dice_side=2, is binomial distribution
# if dice_side>2 , is multinomial distribution
dice_side = 2
# if N becomes larger, then multinomial distribution will more like normal distribution
N = 100

counting = np.zeros(((dice_side - 1) * N + 1))

for i in range(30000):
 sum = 0
 for j in range(N):
  dice_result = np.random.randint(0, dice_side)
  sum += dice_result

 counting[sum] += 1

# normalization
counting /= np.sum(counting)
plot_bar_x()
以上关于 Python 计算概率密度、累计分布及逆函数的示例分享完毕,希望能对大家有所帮助,也欢迎继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















