


Python生成符合正态分布的多个随机数
详细讲解在Python中生成多个符合正态分布(高斯分布)随机数的实现方法,涵盖标准库random模块、NumPy高性能向量化生成及SciPy统计抽样,并提供参数配置、统计校验与选型建议。
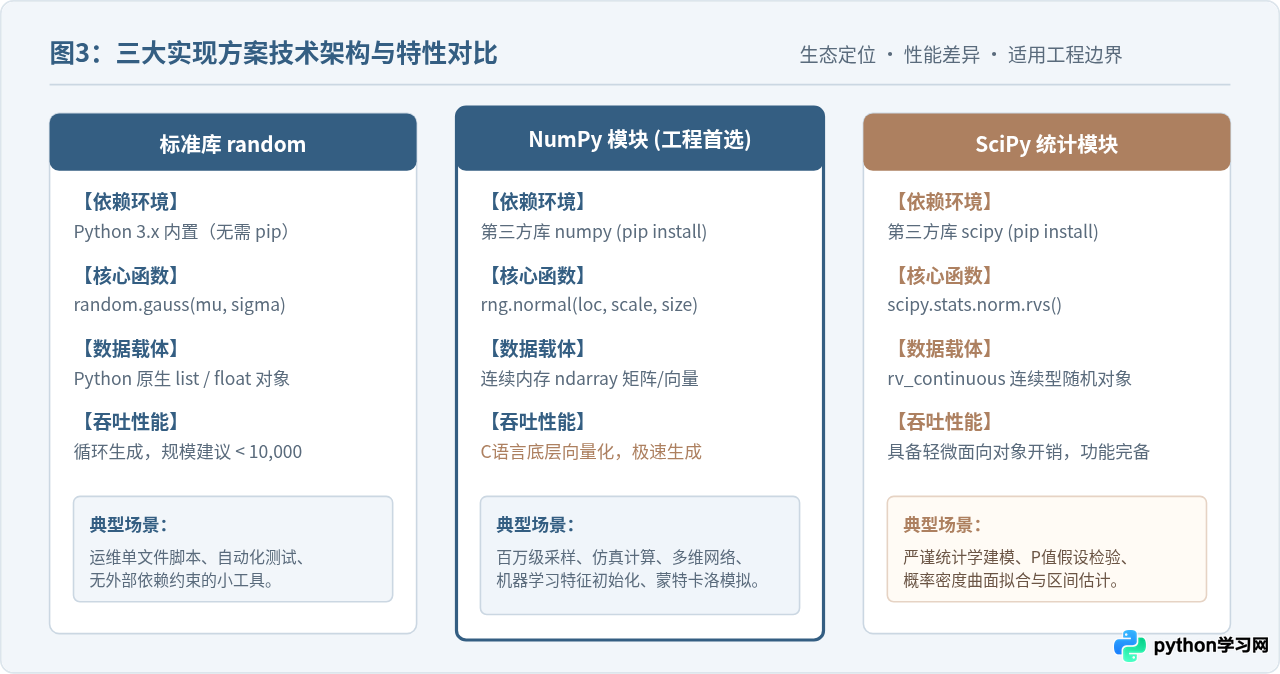
在 Python 中生成多个符合正态分布(高斯分布)的随机数,主要有三种成熟实现路径:轻量无外部依赖时使用标准库 random.gauss() 结合列表推导式;数据科学与工程计算中优先使用 numpy.random.default_rng().normal() 进行向量化批量生成;而在严谨的统计建模与分布拟合任务中,则借助 scipy.stats.norm.rvs()。本文将具体讲解各方案的调用方式、参数含义、运行效率及校验手段,帮助读者按需选择最合适的实现方法。
一、正态分布核心参数与生成机理
正态分布(Normal Distribution)由两个核心数学参数唯一定义:均值(记作 $\mu$,代码中常写作 loc 或 mu)与标准差(记作 $\sigma$,代码中常写作 scale 或 sigma)。均值决定了概率密度曲线对称中心的横坐标位置;标准差衡量数据偏离均值的离散程度,数值越大曲线越平缓,数值越小曲线越陡峭尖锐,且标准差必须严格为正数。
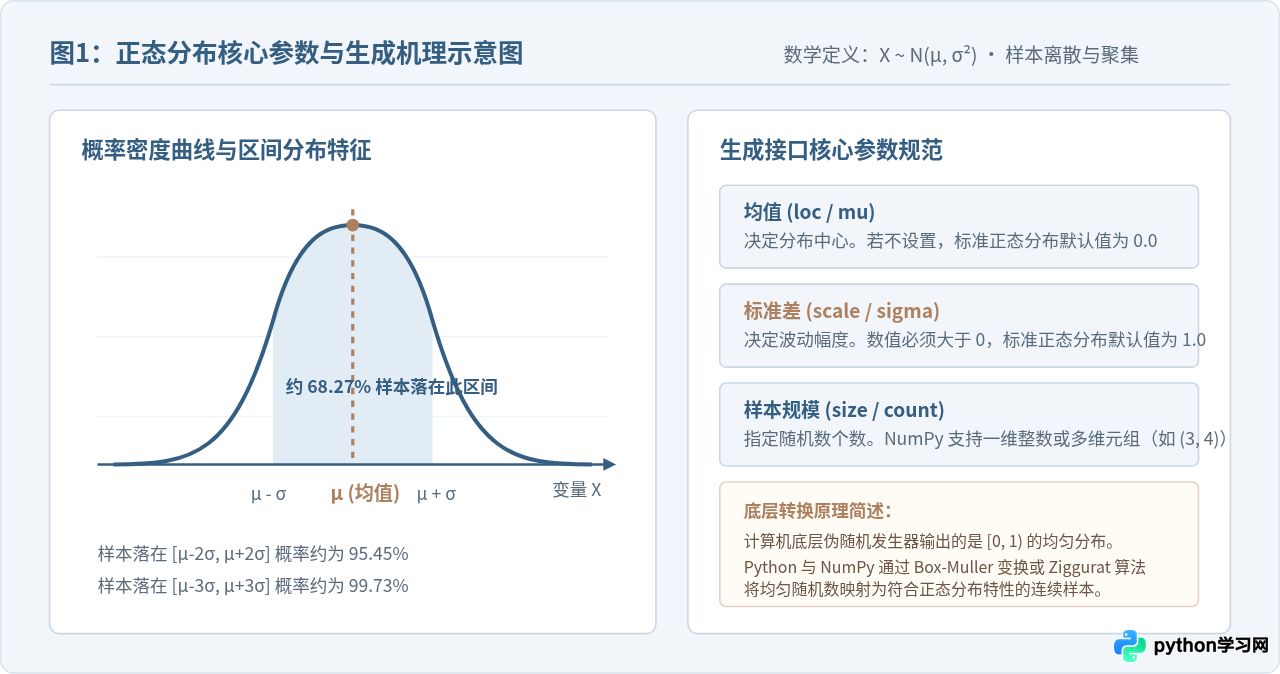
当计算机生成正态分布随机数时,并非直接凭空抽样,而是首先利用伪随机数发生器产生均匀分布的实数序列,再通过数学变换(如 Box-Muller 算法或更为高效的 Ziggurat 算法)投影为标准正态分布 $Z \sim N(0, 1)$,最后根据公式 $X = \mu + \sigma \cdot Z$ 线性放缩为任意目标均值和方差的数值序列。
二、正态分布随机数生成的通用操作步骤
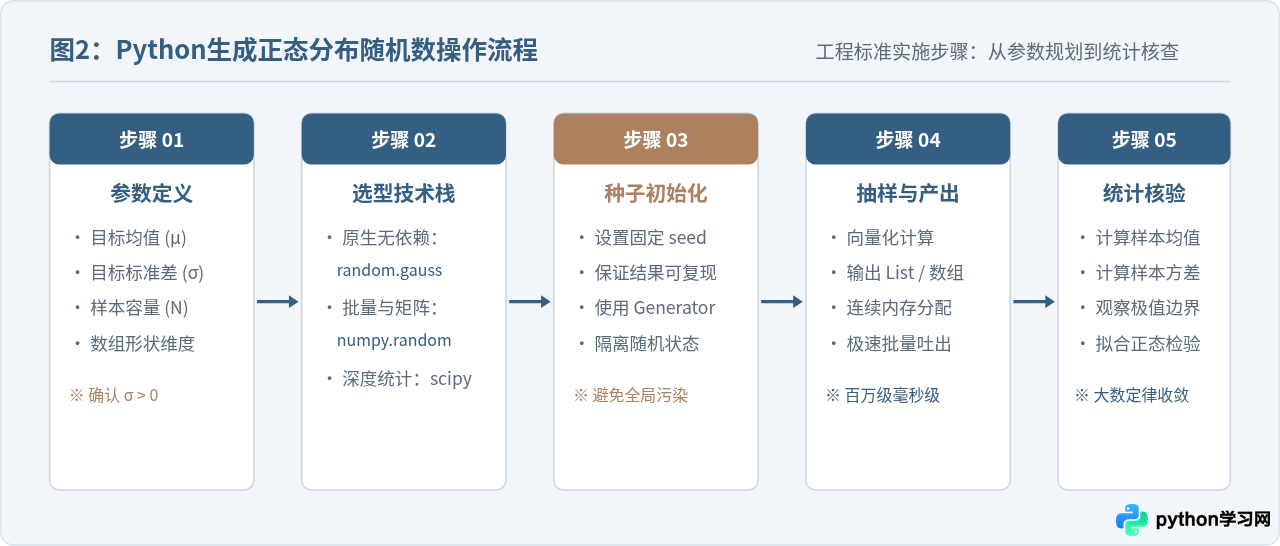
在实际编码中,生成正态分布随机数通常遵循明确的工程操作链条。遵循该流程可以避免产生不可复现的脏数据或因参数设置不当导致的异常崩溃。
三、方案一:使用标准库 random 模块(无需安装任何依赖)
如果当前开发环境受限,无法使用 pip 安装第三方扩展库,或者仅需生成少量随机数用于简单的脚本逻辑,Python 内置的 random 模块是最直接的选择。
标准库提供了 random.gauss(mu, sigma) 与 random.normalvariate(mu, sigma) 两个函数。两者数学意义相同,但底层实现机制略有区别:random.gauss() 采用了 Box-Muller 变换并且稍快一些;random.normalvariate() 采用了 Kinderman 和 Monahan 的比例对数算法。官方推荐在绝大多数场景下直接使用 random.gauss()。
完整代码示例:列表推导式批量生成
import random

# 1. 明确分布参数
mu = 0.0       # 目标均值
sigma = 1.0    # 目标标准差 (必须大于 0)
count = 10     # 需要生成的随机数个数

# 2. 设定随机数种子(用于确保每次运行结果一致)
random.seed(42)

# 3. 使用列表推导式连续生成多个数值
random_numbers = [random.gauss(mu, sigma) for _ in range(count)]

# 4. 打印示例输出
print("生成的正态分布随机数列表:")
for index, value in enumerate(random_numbers, start=1):
    print(f"[{index:02d}] {value:.6f}")
示例输出参考
生成的正态分布随机数列表:
[01] 0.509741
[02] -0.138407
[03] 0.647689
[04] 1.523030
[05] -0.234153
[06] -0.234137
[07] 1.579213
[08] 0.767435
[09] -0.469474
[10] 0.542560
random.gauss() 单次调用仅返回一个 Python 浮点数对象。如果需要生成上百万个数据,由于 Python 解释器的循环开销和对象指针分配机制,耗时将显著增加(生成 100 万个数据约需数百毫秒至数秒)。当面对大规模数据处理时,应切换到 NumPy 模块。
四、方案二:使用 NumPy 生成高维/大规模正态分布数组(工程首选)
在涉及科学计算、金融量化、物理仿真或机器学习的场景中,NumPy 是生成正态分布随机数的标准工具。NumPy 底层由 C 语言实现,支持 SIMD 指令级并行与连续内存存储,百万级数据的生成仅需数毫秒。
推荐使用 Generator 现代 API
在较旧的代码中,读者经常会看到 numpy.random.normal() 或 numpy.random.seed()。NumPy 官方自 1.17 版本起引入了全新的 Generator 接口(np.random.default_rng()),不仅将默认底层随机算法升级为高质量的 PCG64,而且消除了修改全局状态带来的并发安全隐患,属于现代 Python 项目的强制推荐规范。
完整代码示例:一维数组与多维矩阵生成
import numpy as np

# 1. 初始化独立随机数生成器(指定 seed 保证复现性)
rng = np.random.default_rng(seed=42)

# 2. 设置生成参数
loc = 50.0     # 均值 (μ)
scale = 10.0   # 标准差 (σ)

# 3. 生成一维包含 1,000,000 个随机数的高性能数组
data_1d = rng.normal(loc=loc, scale=scale, size=1_000_000)

# 4. 生成 3 行 4 列的二维正态分布矩阵
matrix_2d = rng.normal(loc=loc, scale=scale, size=(3, 4))

print(f"一维数组形状: {data_1d.shape}")
print(f"前5个采样值: {np.round(data_1d[:5], 4)}")
print(f"样本均值: {data_1d.mean():.4f} (理论目标: {loc})")
print(f"样本标准差: {data_1d.std():.4f} (理论目标: {scale})\n")

print("二维矩阵 (3x4):")
print(np.round(matrix_2d, 2))
示例输出参考
一维数组形状: (1000000,)
前5个采样值: [53.05  48.55  56.48  65.23  47.66]
样本均值: 49.9982 (理论目标: 50.0)
样本标准差: 10.0021 (理论目标: 10.0)

二维矩阵 (3x4):
[[53.05 48.55 56.48 65.23]
 [47.66 47.66 65.79 57.67]
 [45.31 55.43 45.34 50.62]]
五、方案三:使用 SciPy 进行统计学抽样与拟合检验
当任务不仅要求产生数据,还需对正态分布的理论概率密度(PDF)、累积分布(CDF)进行计算,或对抽样结果进行严谨的统计学假设检验(例如检验数据是否通过 Shapiro-Wilk 正态性测试)时,scipy.stats.norm 是最完备的选择。
完整代码示例:生成并执行正态性检验
from scipy import stats
import numpy as np

# 1. 实例化正态分布对象(均值 100,标准差 15)
norm_distribution = stats.norm(loc=100.0, scale=15.0)

# 2. 生成 500 个随机样本 (rvs = Random Variates Sample)
# random_state 参数等价于设置独立种子
samples = norm_distribution.rvs(size=500, random_state=42)

# 3. 统计指标计算
sample_mean = float(np.mean(samples))
sample_std = float(np.std(samples, ddof=1))  # ddof=1 表示样本无偏标准差

# 4. 执行 Shapiro-Wilk 正态性检验(原假设:样本服从正态分布)
stat_value, p_value = stats.shapiro(samples)

print(f"样本均值: {sample_mean:.2f}")
print(f"样本标准差: {sample_std:.2f}")
print(f"Shapiro-Wilk 检验统计量: {stat_value:.4f}, P值: {p_value:.4f}")
if p_value > 0.05:
    print("检验结果:P值大于0.05,无法拒绝原假设,样本高度吻合正态分布。")
六、结果校验与工程避坑指南
在实际工程中,生成伪随机序列需要时刻关注统计收敛性与边界异常:
1. 大数定律收敛校验
理论上的均值 $\mu$ 和标准差 $\sigma$ 是无限样本下的期望值。在有限样本下,样本均值与理论值之间必然存在抽样误差。当 $N=10$ 时,计算得到的均值可能偏离数个百分点;当 $N$ 增至 $10^6$ 时,误差通常会收敛至万分级。如果业务逻辑对统计参数敏感,必须设置足够的样本规模。
2. 随机种子(Seed)的正确使用
很多开发者习惯在脚本中随意调用 np.random.seed(0),该操作会修改当前进程中 NumPy 的全局随机状态。若工程中引入了其他并行计算任务或第三方依赖,可能会意外被篡改。必须坚持使用 np.random.default_rng(seed) 创建专用的 Generator 实例。
3. 非负物理量的截断防范
数学正态分布的取值范围覆盖整个实数域 $(-\infty, +\infty)$。如果用它模拟现实生活中的非负指标(例如接口响应延迟、用户年龄、网络带宽),直接采用正态分布可能会生成极少量的负数。若盲目使用 max(0, x) 强行截断,会在 0 处形成不自然的尖峰堆积破坏连续性,此时更应选用对数正态分布(numpy.random.lognormal)或截断正态分布(scipy.stats.truncnorm)。
七、选型决策与实践总结
为了直观帮助读者在不同项目中进行技术决策,下表汇总了三种实现手段的维度对比:
| 对比维度 | Python 标准库 random | NumPy (default_rng) | SciPy (stats.norm) |
|---|---|---|---|
| 外部安装依赖 | 无需安装(Python内置) | 需要 numpy |
需要 scipy 及 numpy |
| 数据输出类型 | Python 基础浮点数 / 列表 | 连续内存 np.ndarray |
np.ndarray / 统计对象 |
| 多维矩阵支持 | 不支持(需多层嵌套推导) | 原生支持 size=(M, N, ...) |
原生支持多维形状 |
| 百万级生成耗时 | 约 400 ~ 800 毫秒 | 约 8 ~ 15 毫秒(极快) | 约 15 ~ 25 毫秒 |
| 统计分析配套 | 仅提供基础数学函数 | 提供基础统计指标聚合 | 具备完整概率论与检验工具集 |
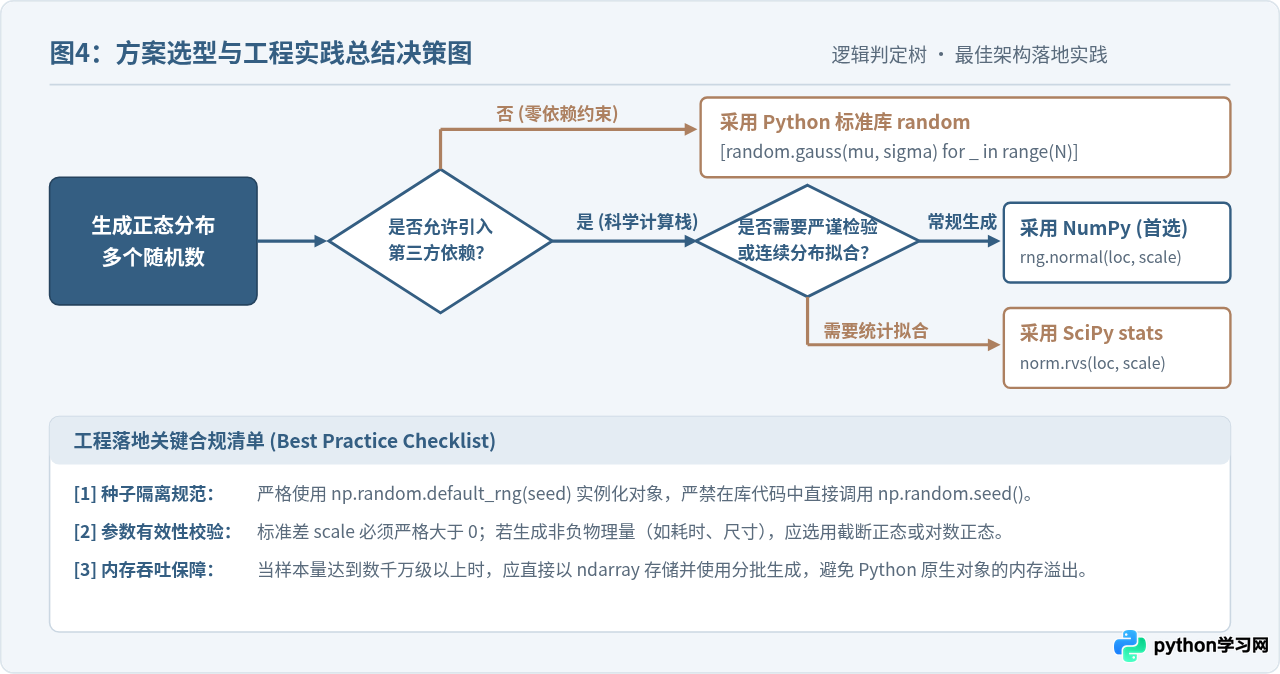
综上所述,生成符合正态分布的随机数在 Python 中有着层次分明的解决方案:轻量脚本首选标准库 random.gauss();批量工程计算与科学仿真优先选用 numpy.random.default_rng().normal();深入概率分析与分布检验则依托 scipy.stats.norm。在工程落地时,始终明确均值与方差参数,规范设置随机种子,并对样本均值与离散度进行大数收敛核验,即可高效、可靠地完成正态分布数据的生成与模拟。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















