


sklearn中predict_proba与predict的区别及概率解读

本文详解sklearn中predict_proba与predict的区别。predict_proba返回所有类别的概率值,列数由分类数量决定,按self.classes_排序。通过示例展示如何解读概率值(如大于0.5判定为某类),并对比predict直接返回预测标签。包含逻辑回归与SVM的完整代码及可视化示例,帮助理解概率输出机制。
核心区别:概率输出与预测结果
在sklearn的分类器中,predict_proba与predict是两个常用但功能不同的方法。理解它们的差异对于模型评估和结果解释至关重要。
- predict:直接返回唯一的预测类别标签。这是最直接的分类结果。
- predict_proba:返回所有可能类别的概率值。返回值的列数取决于分类任务中的类别数量(例如,二分类返回2列,多分类返回N列)。
概率值的解读规则
predict_proba返回的概率值是按照self.classes_排序后的顺序排列的。这意味着:
- 列的顺序对应于模型训练时去重排序后的标签(通常通过
np.unique(Label)确定)。 - 对于二分类问题(标签为0和1),第一列通常对应类别0的概率,第二列对应类别1的概率。
- 判断逻辑:如果类别0的概率大于0.5,则预测结果为0;反之,若类别0的概率小于等于0.5(即类别1概率大于0.5),则预测结果为1。
代码示例:逻辑回归中的概率输出
以下示例展示了如何使用逻辑回归模型,并对比predict与predict_proba的输出结果。
from sklearn.linear_model import LogisticRegression
import numpy as np

# 生成训练数据和测试数据
train_X = np.array(np.random.randint(0,10,size=30).reshape(10,3))
train_y = np.array(np.random.randint(0,2,size=10))
test_X = np.array(np.random.randint(0,10,size=12).reshape(4,3))

# 训练模型
model = LogisticRegression()
model.fit(train_X,train_y)

# 获取概率预测结果
test_y_proba = model.predict_proba(test_X)

print("训练数据 X:", train_X)
print("训练标签 y:", train_y)
print("测试数据概率:", test_y_proba)
运行上述代码,你将看到类似以下的输出:
[[2 9 8]
 [0 8 5]
 [7 1 2]
 [8 4 6]
 [8 8 3]
 [7 2 7]
 [6 4 3]
 [1 4 4]
 [1 9 3]
 [3 4 7]]
[[4 3 0]  #测试数据
 [3 0 4]
 [2 9 5]
 [2 8 5]]
[[0.48753831 0.51246169]
 [0.58182694 0.41817306]
 [0.85361393 0.14638607]
[0.57018655 0.4291345]]在输出的概率矩阵中,每一行代表一个测试样本,两列分别代表预测为类别0和类别1的概率。例如,第一行[0.48753831, 0.51246169]表示该样本预测为类别0的概率约为0.49,预测为类别1的概率约为0.51。由于0.51 > 0.5,该样本最终会被predict方法判定为类别1。
多分类与SVM可视化示例
对于多分类问题,predict_proba同样适用。以下示例使用支持向量机(SVM)进行多分类,并可视化决策边界。
import matplotlib.pyplot as plt
import numpy as np
from sklearn.svm import SVC

# 定义样本点和标签
X = np.array([[-1,-1],[-2,-1],[1,1],[2,1],[-1,1],[-1,2],[1,-1],[1,-2]])
y = np.array([0,0,1,1,2,2,3,3])

# 训练SVM模型,设置probability=True以启用概率输出
clf = SVC(probability=True)
clf.fit(X, y)

# 输出决策函数值(用于理解分类间隔)
print("决策函数值:", clf.decision_function(X))

# 输出预测标签
print("预测标签:", clf.predict(X))

# 获取概率预测结果
probabilities = clf.predict_proba(X)
print("概率预测:", probabilities)
决策函数与概率的关系
在SVM中,decision_function返回的是样本到分类超平面的距离。对于n分类问题,如果是“一对多”(ovr)策略,会有n个分类器;如果是“一对一”(ovo)策略,会有n*(n-1)/2个分类器。这些距离值用于计算概率,而predict_proba返回的是经过校准后的各类别概率,取最大概率对应的类别即为最终预测结果。
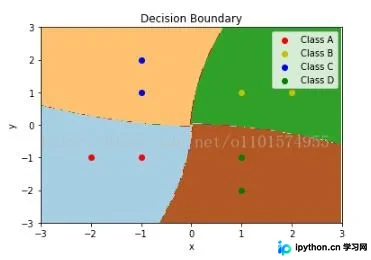
可视化决策边界
为了直观展示分类器的决策区域,我们可以绘制决策边界:
# 设置绘图参数
plot_step=0.02
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1

# 创建网格点
xx, yy = np.meshgrid(np.arange(x_min, x_max, plot_step),
           np.arange(y_min, y_max, plot_step))

# 对网格点进行预测,用于绘制分界面
Z = clf.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)

# 绘制等高线图
cs = plt.contourf(xx, yy, Z, cmap=plt.cm.Paired)
plt.axis("tight")

class_names="ABCD"
plot_colors="rybg"
for i, n, c in zip(range(4), class_names, plot_colors):
  idx = np.where(y == i)
  plt.scatter(X[idx, 0], X[idx, 1],
        c=c, cmap=plt.cm.Paired,
        label="Class %s" % n)

plt.xlim(x_min, x_max)
plt.ylim(y_min, y_max)
plt.legend(loc='upper right')
plt.xlabel('x')
plt.ylabel('y')
plt.title('Decision Boundary')
plt.show()
该可视化代码通过网格点预测,绘制出不同类别的决策区域。分界线即为概率相等(如0.5)的边界。通过观察图形,可以更直观地理解模型是如何划分不同类别的数据空间。
总结
predict_proba提供了比predict更丰富的信息,它不仅给出了预测结果,还给出了每个类别的可能性。这在需要权衡不同错误代价的场景中非常有用。通过理解概率值的排序规则和输出格式,可以更准确地评估和利用分类模型的结果。
以上就是sklearn中predict_proba与predict区别及概率解读的详细内容,更多关于sklearn分类器概率输出的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















