


Python实战:批量抓取LOL英雄数据与皮肤图片

发布时间:2026-10-12 |
3人浏览过
本文介绍使用Python批量获取英雄联盟英雄属性并生成Excel,以及下载所有英雄皮肤图片的完整流程。通过requests获取接口数据,利用xlwt处理表格写入,并结合IO流实现图片本地存储,提供可直接运行的示例代码供参考。
整体实现方案分为两个主要步骤:首先,从网页接口获取数据,并利用xlwt库生成Excel文件(也可根据需求选择存入数据库);其次,再次获取网页数据,通过IO流将对应的图片文件保存至本地目录。
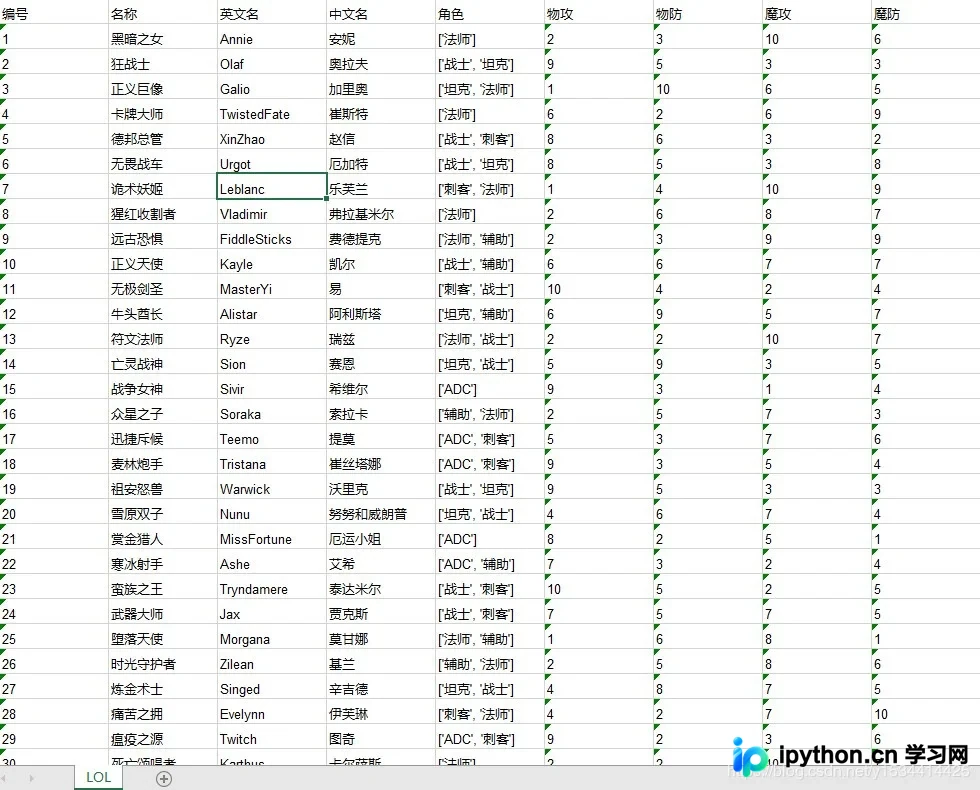
一、爬取所有英雄属性并生成Excel表格
1. 相关代码实现
import json

import requests
import xlwt

# 设置头部信息,防止被检测出是爬虫
headers = {
 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/83.0.4103.116 Safari/537.36'
}
url = "https://game.gtimg.cn/images/lol/act/img/js/heroList/hero_list.js"
response = requests.get(url=url, headers=headers).text
loads = json.loads(response)
dic = loads['hero']
# 创建一个workbook 设置编码
workbook = xlwt.Workbook(encoding='utf-8')
# 创建一个worksheet
worksheet = workbook.add_sheet('LOL')
try:
 for i in range(len(dic)):
  # 设置单元格宽度大小
  worksheet.col(i).width = 4000
  # 设置单元格高度大小
  style = xlwt.easyxf('font:height 300')
  worksheet.row(i).set_style(style)
  # 第一行用于写入表头
  if i == 0:
   worksheet.write(i, 0, '编号')
   worksheet.write(i, 1, '名称')
   worksheet.write(i, 2, '英文名')
   worksheet.write(i, 3, '中文名')
   worksheet.write(i, 4, '角色')
   worksheet.write(i, 5, '物攻')
   worksheet.write(i, 6, '物防')
   worksheet.write(i, 7, '魔攻')
   worksheet.write(i, 8, '魔防')
   continue
  worksheet.write(i, 0, dic[i - 1]['heroId'])
  worksheet.write(i, 1, dic[i - 1]['name'])
  worksheet.write(i, 2, dic[i - 1]['alias'])
  worksheet.write(i, 3, dic[i - 1]['title'])
  roles_ = dic[i - 1]['roles']
  roles = []
  for data in roles_:
   if 'mage' == data:
    roles.append('法师')
   if 'tank' == data:
    roles.append('坦克')
   if 'fighter' == data:
    roles.append('战士')
   if 'marksman' == data:
    roles.append('ADC')
   if 'assassin' == data:
    roles.append('刺客')
   if 'support' == data:
    roles.append('辅助')
  worksheet.write(i, 4, str(roles))
  worksheet.write(i, 5, dic[i - 1]['attack'])
  worksheet.write(i, 6, dic[i - 1]['defense'])
  worksheet.write(i, 7, dic[i - 1]['magic'])
  worksheet.write(i, 8, dic[i - 1]['difficulty'])
  # 保存
 workbook.save('C:\\Users\\Jonsson\\Desktop\\lol.xls')
except Exception as e:
 print(e)
2. 运行效果展示
二、爬取所有英雄皮肤图片并保存至本地
1. 相关代码实现
import json
import os

import requests
import xlwt

# 设置头部信息,防止被检测出是爬虫
headers = {
 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/83.0.4103.116 Safari/537.36'
}
url = "https://game.gtimg.cn/images/lol/act/img/js/heroList/hero_list.js"
# 请求英雄列表的url地址
response = requests.get(url=url, headers=headers).text
loads = json.loads(response)
dic = loads['hero']
for data in dic:
 id_ = data['heroId']
 skinUrl = 'https://game.gtimg.cn/images/lol/act/img/js/hero/%s.js' % id_
 # 请求每个英雄皮肤的url地址
 skinResponse = requests.get(url=skinUrl, headers=headers).text
 json_loads = json.loads(skinResponse)
 hero_ = json_loads['hero']
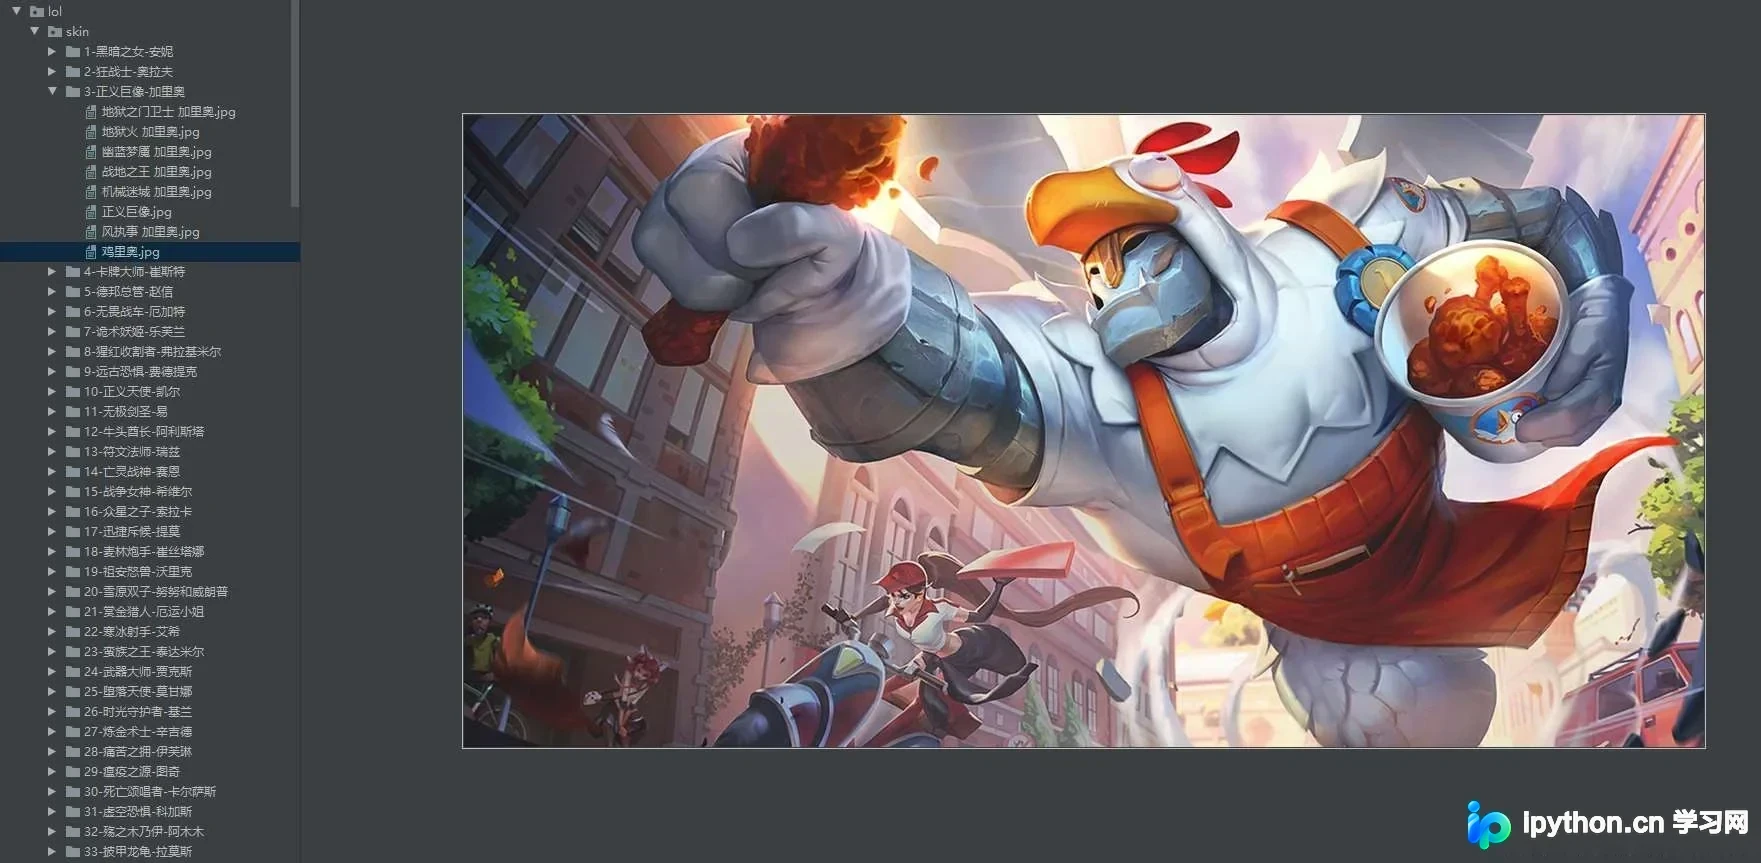
 save_path = './skin/%s-%s-%s' % (hero_["heroId"], hero_['name'], hero_['title'])
 # 文件夹不存在,则创建文件夹
 folder = os.path.exists(save_path)
 if not folder:
  os.makedirs(save_path)
 skins_ = json_loads['skins']
 for data in skins_:
  if data['chromas'] == '0':
   content = requests.get(url=data['mainImg'], headers=headers).content
   try:
    with open('%s/%s.jpg' % (save_path, data['name']), "wb") as f:
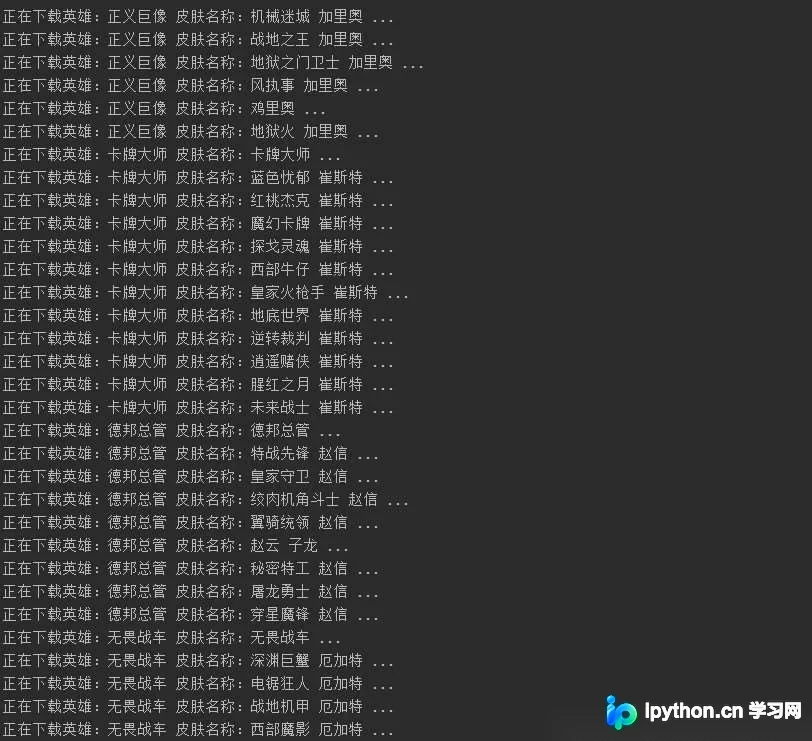
     print("正在下载英雄:%s 皮肤名称:%s ..." % (hero_['name'], data['name']))
     f.write(content)
   except Exception as e:
    print('下载失败')
    print(e)
2. 运行效果展示
至此,关于使用Python爬取LOL所有英雄信息及英雄皮肤的示例代码介绍完毕。如需了解更多Python爬取LOL相关内容,建议搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















