


深入解析Python爬虫框架Scrapy架构与组件

本文详细解析Python爬虫框架Scrapy的核心架构与运行机制。文章系统介绍了Scrapy Engine、Scheduler、Downloader、Spiders及Item Pipeline等关键组件的功能,并梳理了从URL请求到数据存储的完整数据处理流程。同时探讨了基于Twisted的事件驱动模型及各类中间件的作用,帮助开发者深入理解Scrapy的高效抓取原理。
网络爬虫是用于在互联网上自动抓取数据的程序,主要功能是从特定网页中提取HTML内容。虽然开发者可以使用各种库手动编写爬虫,但采用成熟的框架能显著提升开发效率并缩短项目周期。Scrapy是一款基于Python开发的轻量级爬虫框架,以其设计简洁、功能强大且易于上手而备受推崇。
一、概述
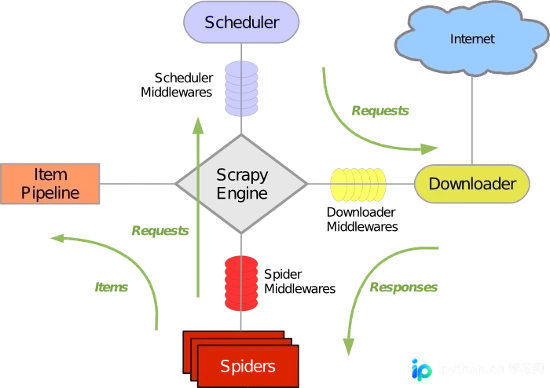
下图展示了Scrapy的整体架构,涵盖了其核心组件及系统内部的数据处理流程(图中绿色箭头指示了数据流向)。接下来将逐一解析各组件的具体职责及数据流转过程(注:参考图片来源于互联网)。
二、组件
1、Scrapy Engine(Scrapy引擎)
Scrapy引擎负责控制整个系统的数据处理流程,并触发各项事务处理。关于其具体运作机制,可参考下文详细的数据处理流程部分。
2、Scheduler(调度器)
调度器接收来自Scrapy引擎的请求,对其进行排序并加入队列;当引擎发出请求时,调度器会将相应的请求返回给引擎。
3、Downloader(下载器)
下载器的核心职责是抓取网页内容,并将获取到的网页数据返还给蜘蛛(Spiders)。
4、Spiders(蜘蛛)
蜘蛛是由Scrapy用户自定义的类,用于解析网页并抓取指定URL返回的内容。每个蜘蛛通常负责处理一个域名或一组域名,实质上定义了针对特定网站的抓取与解析规则。
蜘蛛的完整抓取流程(周期)如下:
首先获取初始URL的请求。当请求返回后,系统会调用一个回调函数。初始请求通过调用start_requests()方法生成,该方法默认从start_urls列表中的URL生成请求,并执行解析以调用相应的回调函数。
在回调函数中,你可以解析网页响应,并返回项目对象(Items)和请求对象(Requests)的迭代结果。这些新生成的请求同样包含回调函数,随后由Scrapy下载器处理,并由指定的回调函数进行后续处理。
在回调函数中,你解析网站内容,Scrapy默认使用XPath选择器(当然,你也可以选择使用BeautifulSoup、lxml或其他你偏好的工具),从而生成解析后的数据项。
最后,从蜘蛛返回的数据项通常会进入项目管道(Item Pipeline)进行处理。
5、Item Pipeline(项目管道)
项目管道的主要责任是处理由蜘蛛从网页中提取的项目,其核心任务包括清理、验证和存储数据。当页面被蜘蛛解析后,数据将被发送至项目管道,并按特定顺序进行处理。每个项目管道组件均由简单的Python类方法组成,它们接收项目并执行相应操作,同时需判断是否继续处理该项目或直接丢弃。
项目管道通常执行以下过程:
清洗HTML数据 验证解析到的数据(检查项目是否包含必要的字段) 检查是否是重复数据(如果重复则删除) 将解析到的数据存储到数据库中
6、Downloader middlewares(下载器中间件)
下载中间件是位于Scrapy引擎和下载器之间的钩子框架,主要用于处理引擎与下载器之间的请求及响应。它提供了一种自定义代码的方式来扩展Scrapy的功能。作为一个轻量级且对Scrapy进行全局控制的底层系统,下载中间件处理请求和响应的钩子机制是其核心特征。
7、Spider middlewares(蜘蛛中间件)
蜘蛛中间件是介于Scrapy引擎和蜘蛛之间的钩子框架,主要处理蜘蛛的响应输入和请求输出。它提供了一种自定义代码的方式来扩展Scrapy的功能。蜘蛛中间件是一个挂接到Scrapy蜘蛛处理机制的框架,允许你插入自定义代码来处理发送给蜘蛛的请求以及返回给蜘蛛的响应内容和项目。
8、Scheduler middlewares(调度中间件)
调度中间件位于Scrapy引擎和调度器之间,主要处理从Scrapy引擎发送到调度器的请求。它提供了一个自定义代码的接口来扩展Scrapy的功能。
三、数据处理流程
Scrapy的整个数据处理流程由Scrapy引擎控制,其主要的运行方式如下:
1. 引擎打开一个域名,使蜘蛛处理该域名,并让蜘蛛获取第一个要爬取的URL。
2. 引擎从蜘蛛处获取第一个需要爬取的URL,然后将其作为请求在调度器中进行调度。
3. 引擎从调度器处获取接下来要爬取的页面。
4. 调度器将下一个要爬取的URL返回给引擎,引擎通过下载中间件将其发送给下载器。
5. 当网页被下载器下载完成后,响应内容通过下载中间件被发送回引擎。
6. 引擎收到下载器的响应,并通过蜘蛛中间件将其发送给蜘蛛进行处理。
7. 蜘蛛处理响应并返回爬取到的项目,然后向引擎发送新的请求。
8. 引擎将抓取到的项目送入管道,并向调度器发送新的请求。
9. 系统重复第二步之后的操作,直到调度器中没有剩余请求,此时断开引擎与域名的连接。
四、驱动器
Scrapy是基于Twisted编写的一个流行的Python事件驱动网络框架,它采用非阻塞的异步处理方式。
以上就是详解Python爬虫框架Scrapy的详细内容,更多关于Python爬虫框架Scrapy的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















