


pandas数据筛选实战:布尔索引、位置与标签索引详解

发布时间:2026-10-12 |
1人浏览过
本文详解pandas中筛选指定列值对应行的多种方法。涵盖布尔索引、基于iloc的位置索引、基于loc的标签索引及高效的query API。通过具体代码示例,演示如何筛选等于标量、属于范围、多条件组合及排除特定值的行,帮助开发者高效处理数据子集。
在pandas库中,如何实现类似MySQL数据库中查找语句的功能?
select * from table where column_name = some_value;
在pandas中获取和筛选数据主要包含以下几种常用方法:
- 布尔索引
- 位置索引
- 标签索引
- 使用API接口
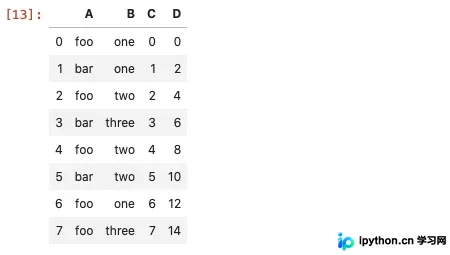
假设我们拥有如下示例数据:
import pandas as pd
import numpy as np

df = pd.DataFrame({'A': 'foo bar foo bar foo bar foo foo'.split(),
          'B': 'one one two three two two one three'.split(),
          'C': np.arange(8), 'D': np.arange(8) * 2})
布尔索引
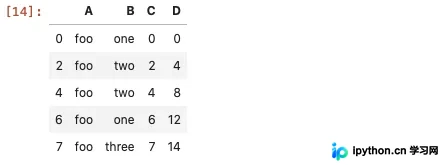
该方法的核心逻辑是找出每一行中满足条件的真值(true value)。例如,若要找出列A中所有值等于'foo'的行,可通过构建布尔掩码来实现。
df[df['A'] == 'foo'] # 判断等式是否成立
位置索引
使用iloc方法,可以根据索引的具体位置来查找数据。此例中,首先需要确定符合条件的行在DataFrame中的具体位置索引。
mask = df['A'] == 'foo'
pos = np.flatnonzero(mask) # 返回的是array([0, 2, 4, 6, 7])
df.iloc[pos]

#常见的iloc用法
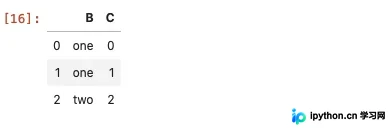
df.iloc[:3,1:3]
标签索引
如果DataFrame的行和列都设置了标签,那么使用loc方法将非常便捷。
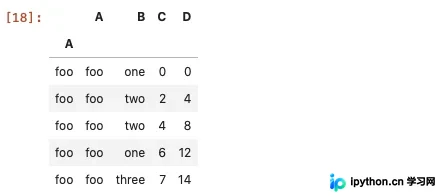
df.set_index('A', append=True, drop=False).xs('foo', level=1) # xs方法适用于多重索引DataFrame的数据筛选

# 更直观点的做法
df.index=df['A'] # 将A列作为DataFrame的行索引
df.loc['foo', :]

# 使用布尔
df.loc[df['A']=='foo']
使用API
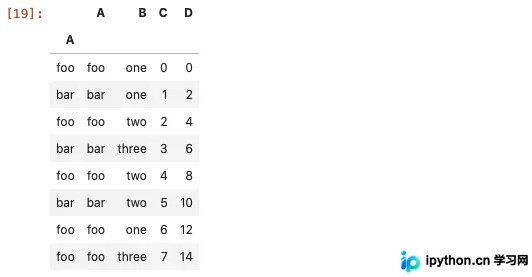
pd.DataFrame.query方法在处理大规模数据时,其执行效率通常优于常规的布尔索引方法。
df.query('A=="foo"')

# 多条件
df.query('A=="foo" | A=="bar"')
数据提取的应用场景不仅限于上述情况,参考最佳答案可归纳出以下几种常见筛选模式:
1、筛选出列值等于特定标量的行,使用==运算符。
df.loc[df['column_name'] == some_value]
2、筛选出列值属于某个集合或范围内的行,使用isin方法。
df.loc[df['column_name'].isin(some_values)] # some_values是可迭代对象
3、在多种条件限制下使用时,需使用&连接条件。注意&的优先级高于>=或<=运算符,因此务必注意括号的使用以确保逻辑正确。
df.loc[(df['column_name'] >= A) & (df['column_name'] <= B)]
4、筛选出列值不等于某个或某些特定值的行。
df.loc[df['column_name'] != 'some_value']

df.loc[~df['column_name'].isin('some_values')] #~取反
至此,关于使用pandas实现筛选出指定列值所对应行的介绍已完毕。如需了解更多关于pandas筛选指定列值的内容,请搜索本站历史文章或继续浏览下方的相关文章。希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















