


Python 爬取动态网页图片实战:以 Pixiv 为例

本文详细解析如何利用 Python 爬取动态网页中的图片,以知名插画网站 Pixiv 为例。文章涵盖请求头构造、JSON 数据解析、图片 ID 提取及真实地址获取等核心步骤,并提供完整的代码实现。通过手动输入 Cookie 的方式绕过登录限制,实现批量下载指定画师的所有插画作品。
动态网页爬取的核心逻辑
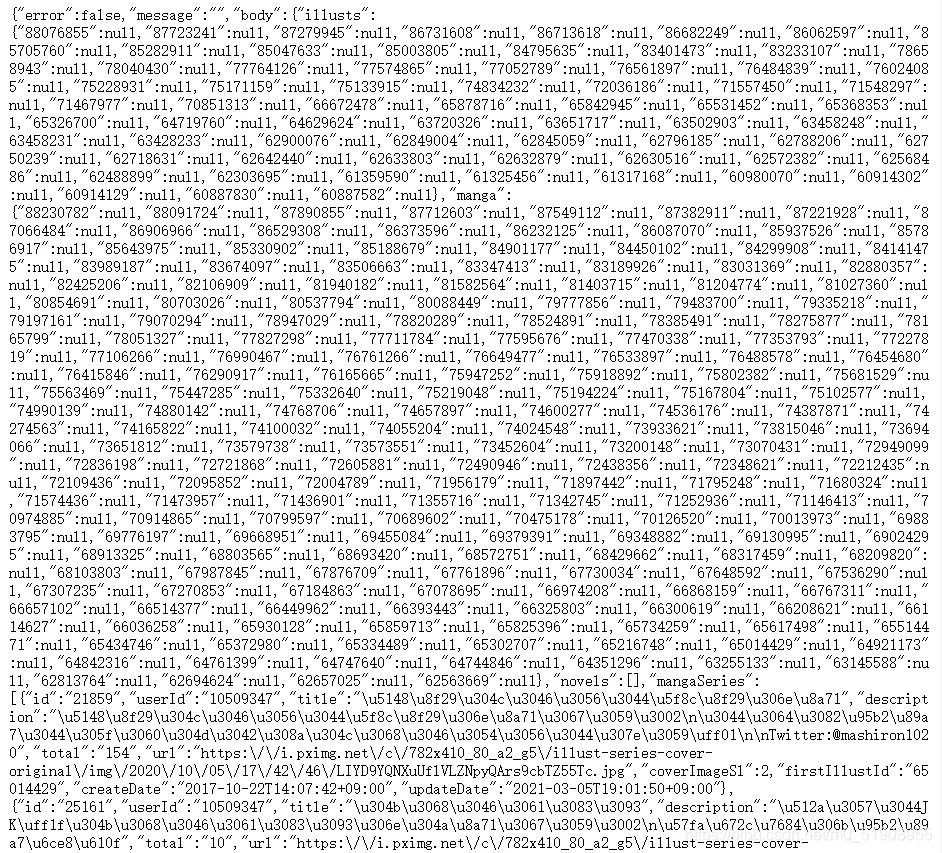
动态网页爬取是爬虫学习中的难点,其核心在于理解前端与后端的数据交互方式。以 Pixiv 为例,网页内容并非直接包含在 HTML 源码中,而是通过异步请求加载 JSON 数据。因此,爬虫需要模拟浏览器的行为,构造特定的请求头,并解析返回的 JSON 数据,从中提取出图片的真实地址。
准备工作与依赖库
在开始编写代码之前,需要确保已安装必要的 Python 库。本示例主要依赖 requests 库进行网络请求,fake_useragent 库生成随机 User-Agent 以模拟不同浏览器,以及标准的 json、re 和 os 库处理数据与文件操作。
import requests
from fake_useragent import UserAgent
import json
import re
import os

global i
i = 0
ua = UserAgent() # 生成假的浏览器请求头,防止被封ip
user_agent = ua.random # 随机选择一个浏览器
proxies = {'http': 'http://127.0.0.1:51837', 'https': 'http://127.0.0.1:51837'} # 代理,根据自己实际情况调整,注意在请求时一定不要忘记代理!!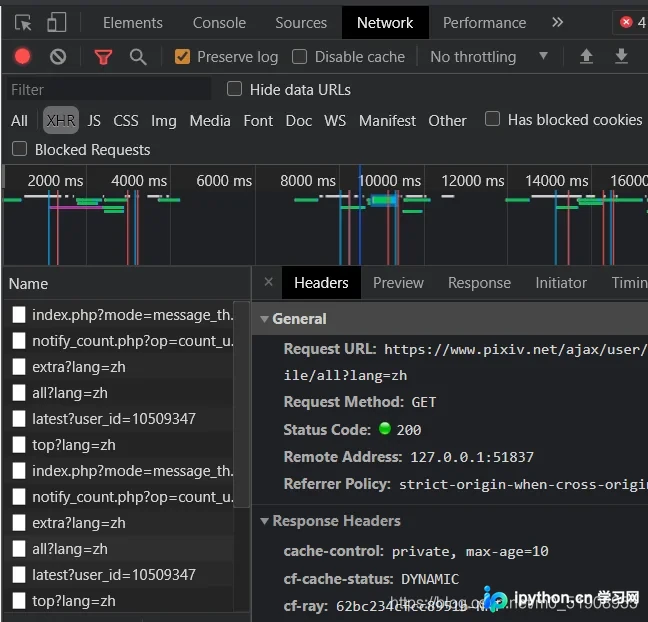
创建存储文件夹
为了有序管理下载的图片,程序首先根据画师的 ID 创建对应的文件夹。如果文件夹已存在,则提示用户并退出程序,避免数据覆盖。
def makefolder(id): # 根据画师的id创建对应的文件夹
	try:
		folder = os.path.join('E:\pixivimages', id)
		os.mkdir(folder)
		return folder
	except(FileExistsError):
		print('the folder exists!')
		exit()
获取画师所有图片 ID
Pixiv 提供了专门的 API 接口用于获取画师的所有作品信息。通过访问特定的 JSON 网址,可以获取到该画师所有插画的 ID 列表。需要注意的是,请求时必须携带正确的 Cookie 和 Referer 头,否则可能会收到 403 错误。
def getAuthorAllPicID(id, cookie): # 获取画师所有图片的id
	url = 'https://pixiv.net/ajax/user/' + id + '/profile/all' # 访问存有画师所有作品
	headers = {
		'User-Agent': user_agent,
		'Cookie': cookie,
		'Referer': 'https://www.pixiv.net/artworks/'
		# referer不能缺少,否则会403
	}
	res = requests.get(url, headers=headers, proxies=proxies)
	if res.status_code == 200:
		resdict = json.loads(res.content)['body']['illusts'] # 将json转化为python的字典后提取元素
		return [key for key in resdict] # 返回所有图片id
	else:
		print("Can not get the author's picture ids!")
		exit()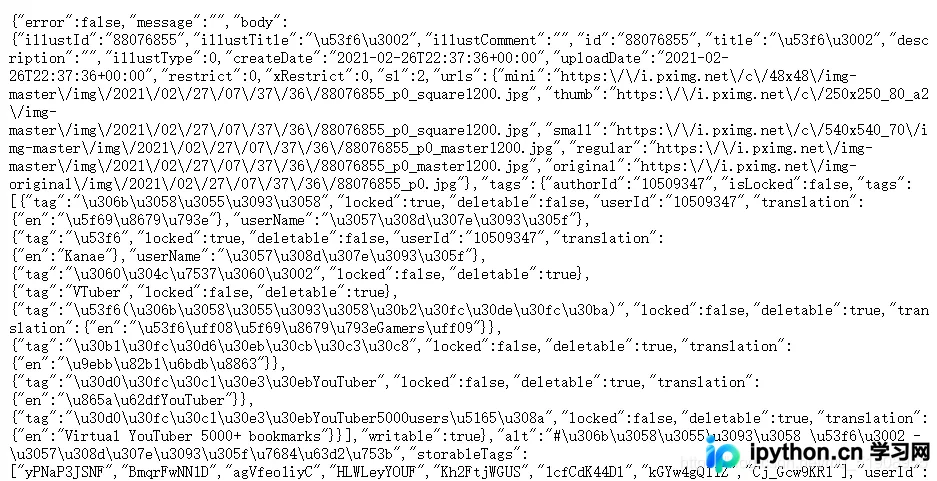
获取图片真实地址并下载
获取到图片 ID 后,下一步是访问每个图片的详情页面,通过另一个 JSON 接口获取图片的真实存储地址。该接口同样需要携带正确的请求头,特别是 Referer 必须指向具体的图片页面。
def getPictures(folder, IDlist, cookie): # 访问图片储存的真实网址
	for picid in IDlist:
		url1 = 'https://www.pixiv.net/artworks/{}'.format(picid) # 注意这里referer必不可少,否则会报403
		headers = {
			'User-Agent': user_agent,
			'Cookie': cookie,
			'Referer': url1
		}
		url = 'https://www.pixiv.net/ajax/illust/' + str(picid) + '?lang = zh' #访问储存图片网址的json
		res = requests.get(url, headers=headers, proxies=proxies)
		if res.status_code == 200:
			data = json.loads(res.content)
			picurl = data['body']['urls']['original'] # 在字典中找到储存图片的路径与标题
			title = data['body']['title']
			title = changeTitle(title) # 调整标题
			print(title)
			print(picurl)
			download(folder, picurl, title, headers)
		else:
			print("Can not get the urls of the pictures!")
			exit()
处理文件名与下载图片
在保存文件前,需要对图片标题进行清洗,去除文件名中不允许的特殊字符。此外,由于 Pixiv 上存在大量名为“無題”的图片,程序通过添加序号来避免文件覆盖。最后,将图片内容写入本地文件。
def changeTitle(title): # 为了防止
	global i
	title = re.sub('[*:]', "", title) # 如果图片中有下列符号,可能会导致图片无法成功下载
	# 注意可能还会有许多不能用于文件命名的符号,如果找到对应符号要将其添加到正则表达式中
	if title == '無題': # pixiv中有许多名为'無題'(日文)的图片,需要对它们加以区分以防止覆盖
		title = title + str(i)
		i = i + 1
	return title


def download(folder, picurl, title, headers): # 将图片下载到文件夹中
	img = requests.get(picurl, headers=headers, proxies=proxies)
	if img.status_code == 200:
		with open(folder + '\\' + title + '.jpg', 'wb') as file: # 保存图片
			print("downloading:" + title)
			file.write(img.content)
	else:
		print("download pictures error!")
完整代码与运行方式
将上述函数组合在一起,形成完整的爬虫程序。运行时需要手动输入画师 ID 和 Cookie 值。由于 Pixiv 的反爬机制,程序无法自动登录,因此需要用户事先登录网站并获取 Cookie。
import requests
from fake_useragent import UserAgent
import json
import re
import os

global i
i = 0
ua = UserAgent() # 生成假的浏览器请求头,防止被封ip
user_agent = ua.random # 随机选择一个浏览器
proxies = {'http': 'http://127.0.0.1:51837', 'https': 'http://127.0.0.1:51837'} # 代理,根据自己实际情况调整,注意在请求时一定不要忘记代理!!


def makefolder(id): # 根据画师的id创建对应的文件夹
	try:
		folder = os.path.join('E:\pixivimages', id)
		os.mkdir(folder)
		return folder
	except(FileExistsError):
		print('the folder exists!')
		exit()


def getAuthorAllPicID(id, cookie): # 获取画师所有图片的id
	url = 'https://pixiv.net/ajax/user/' + id + '/profile/all' # 访问存有画师所有作品
	headers = {
		'User-Agent': user_agent,
		'Cookie': cookie,
		'Referer': 'https://www.pixiv.net/artworks/'
	}
	res = requests.get(url, headers=headers, proxies=proxies)
	if res.status_code == 200:
		resdict = json.loads(res.content)['body']['illusts'] # 将json转化为python的字典后提取元素
		return [key for key in resdict] # 返回所有图片id
	else:
		print("Can not get the author's picture ids!")
		exit()


def getPictures(folder, IDlist, cookie): # 访问图片储存的真实网址
	for picid in IDlist:
		url1 = 'https://www.pixiv.net/artworks/{}'.format(picid) # 注意这里referer必不可少,否则会报403
		headers = {
			'User-Agent': user_agent,
			'Cookie': cookie,
			'Referer': url1
		}
		url = 'https://www.pixiv.net/ajax/illust/' + str(picid) + '?lang = zh' #访问储存图片网址的json
		res = requests.get(url, headers=headers, proxies=proxies)
		if res.status_code == 200:
			data = json.loads(res.content)
			picurl = data['body']['urls']['original'] # 在字典中找到储存图片的路径与标题
			title = data['body']['title']
			title = changeTitle(title) # 调整标题
			print(title)
			print(picurl)
			download(folder, picurl, title, headers)
		else:
			print("Can not get the urls of the pictures!")
			exit()


def changeTitle(title): # 为了防止
	global i
	title = re.sub('[*:]', "", title) # 如果图片中有下列符号,可能会导致图片无法成功下载
	# 注意可能还会有许多不能用于文件命名的符号,如果找到对应符号要将其添加到正则表达式中
	if title == '無題': # pixiv中有许多名为'無題'(日文)的图片,需要对它们加以区分以防止覆盖
		title = title + str(i)
		i = i + 1
	return title


def download(folder, picurl, title, headers): # 将图片下载到文件夹中
	img = requests.get(picurl, headers=headers, proxies=proxies)
	if img.status_code == 200:
		with open(folder + '\\' + title + '.jpg', 'wb') as file: # 保存图片
			print("downloading:" + title)
			file.write(img.content)
	else:
		print("download pictures error!")


def main():
	global i
	id = input('input the id of the artist:')
	cookie = input('input your cookie:') # 半自动爬虫,需要自己事先登录pixiv以获取cookie
	folder = makefolder(id)
	IDlist = getAuthorAllPicID(id, cookie)
	getPictures(folder, IDlist, cookie)


if __name__ == '__main__':
	main()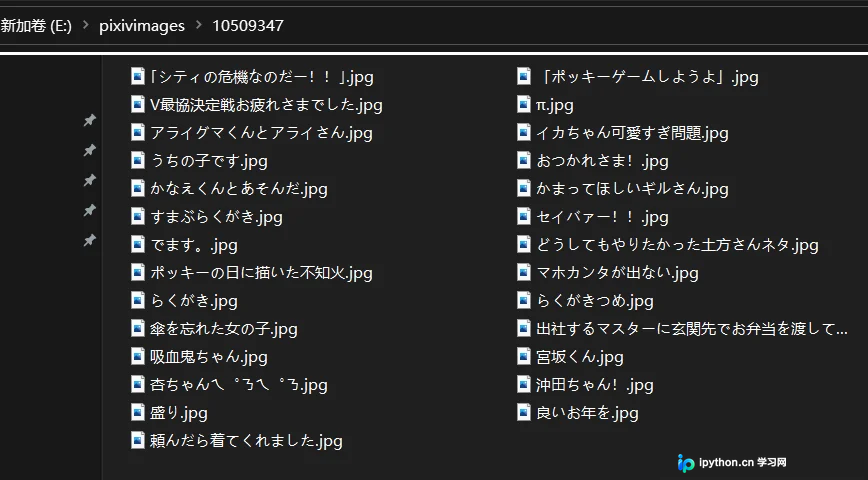
总结
通过本实例,我们学习了如何利用 Python 爬取动态网页中的图片。关键在于理解动态网页的数据加载机制,构造正确的请求头,并解析 JSON 数据。虽然本示例仅实现了半自动爬取,但掌握这一方法后,可以将其应用于其他类似的动态网页爬取场景中。
以上就是Python爬取动态网页中图片的完整实例的详细内容,更多关于Python爬虫的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















