Scrapy结合Selenium实现动态网页数据抓取详解
本文详解如何利用Scrapy框架结合Selenium解决动态网站数据抓取问题。通过自定义下载中间件,在Request阶段使用Selenium渲染JS并获取源码,直接返回Response对象,从而跳过默认Downloader。文章提供了middlewares.py和taobao.py的完整代码示例,并针对单爬虫与多爬虫场景下的Driver初始化策略进行了对比分析,帮助开发者高效实现动态内容抓取。
10-14
5




本文详解如何利用Scrapy框架结合Selenium解决动态网站数据抓取问题。通过自定义下载中间件,在Request阶段使用Selenium渲染JS并获取源码,直接返回Response对象,从而跳过默认Downloader。文章提供了middlewares.py和taobao.py的完整代码示例,并针对单爬虫与多爬虫场景下的Driver初始化策略进行了对比分析,帮助开发者高效实现动态内容抓取。
本文介绍使用Python爬取网易新闻评论的方法。针对动态加载的评论数据,通过开发者工具定位API接口,获取JSON格式数据。利用正则表达式剥离回调函数包裹,将JSON转换为Python字典后提取评论信息,并分别抓取热门与最新评论写入文件。
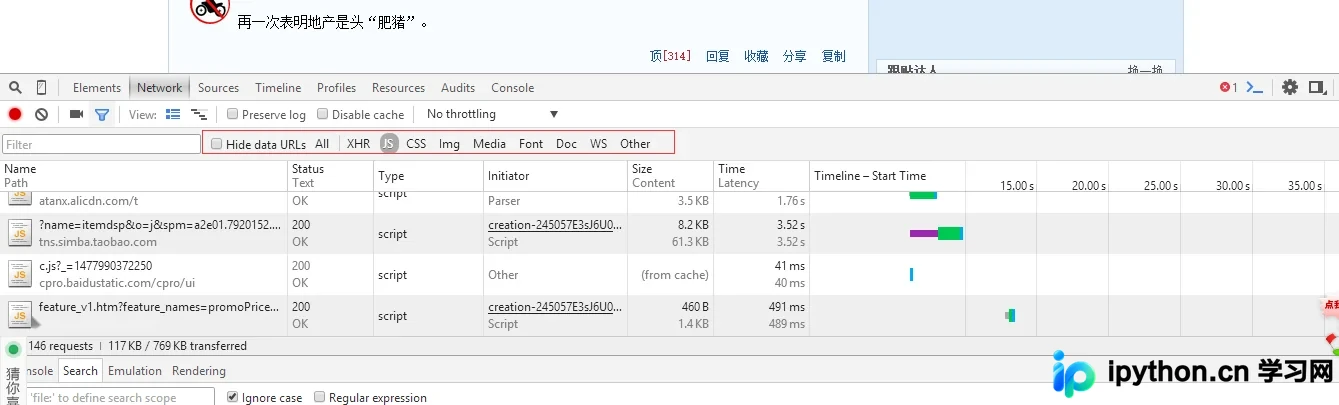
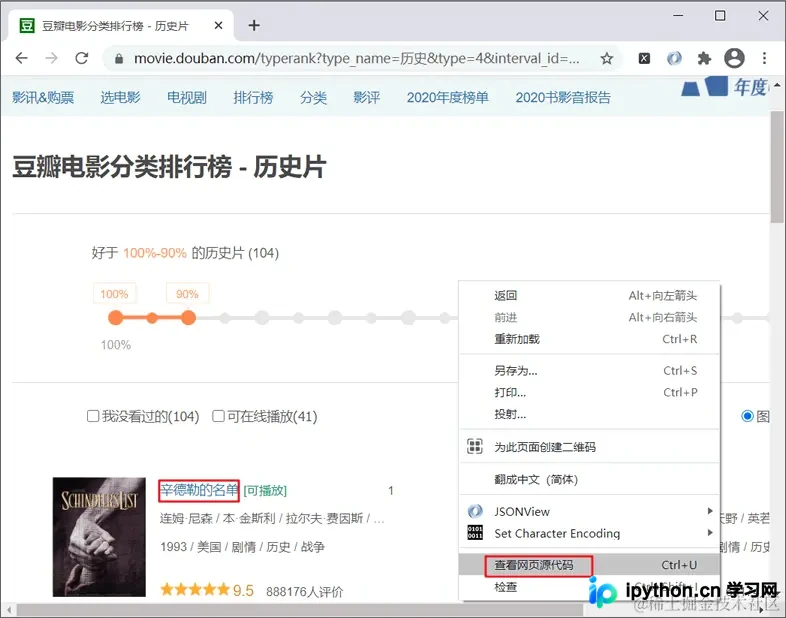
本文详解如何利用Python爬虫抓取豆瓣电影网站的动态加载数据。通过浏览器开发者工具分析网络请求,识别Ajax异步加载机制,提取关键查询参数与接口地址。文章提供了完整的代码实现,包括类型映射、分页抓取及数据保存逻辑,帮助开发者掌握动态网页数据抓取的核心技巧。
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的爬取难题。通过配置Spider与下载中间件,利用浏览器对象执行页面滚动并获取渲染后的HTML源码,成功抓取网易新闻多个版块的动态内容。文章提供了完整的代码实现、配置步骤及注意事项,帮助开发者高效处理复杂动态网页。
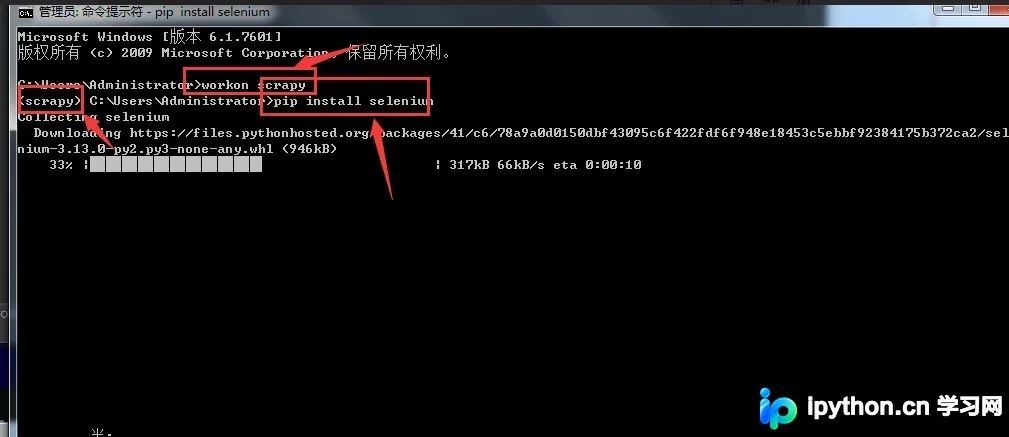
本文详解Python爬取动态网页的两种主流方案:Dryscrape与Selenium。重点讲解Selenium在Ubuntu下的安装步骤,包括geckodriver的下载与路径配置,以及解决Firefox版本兼容性问题。通过代码示例演示如何调用浏览器引擎获取JS执行后的页面源码,并解决常见报错,如模块调用错误及元素定位方法。
本文详细解析如何利用 Python 爬取动态网页中的图片,以知名插画网站 Pixiv 为例。文章涵盖请求头构造、JSON 数据解析、图片 ID 提取及真实地址获取等核心步骤,并提供完整的代码实现。通过手动输入 Cookie 的方式绕过登录限制,实现批量下载指定画师的所有插画作品。
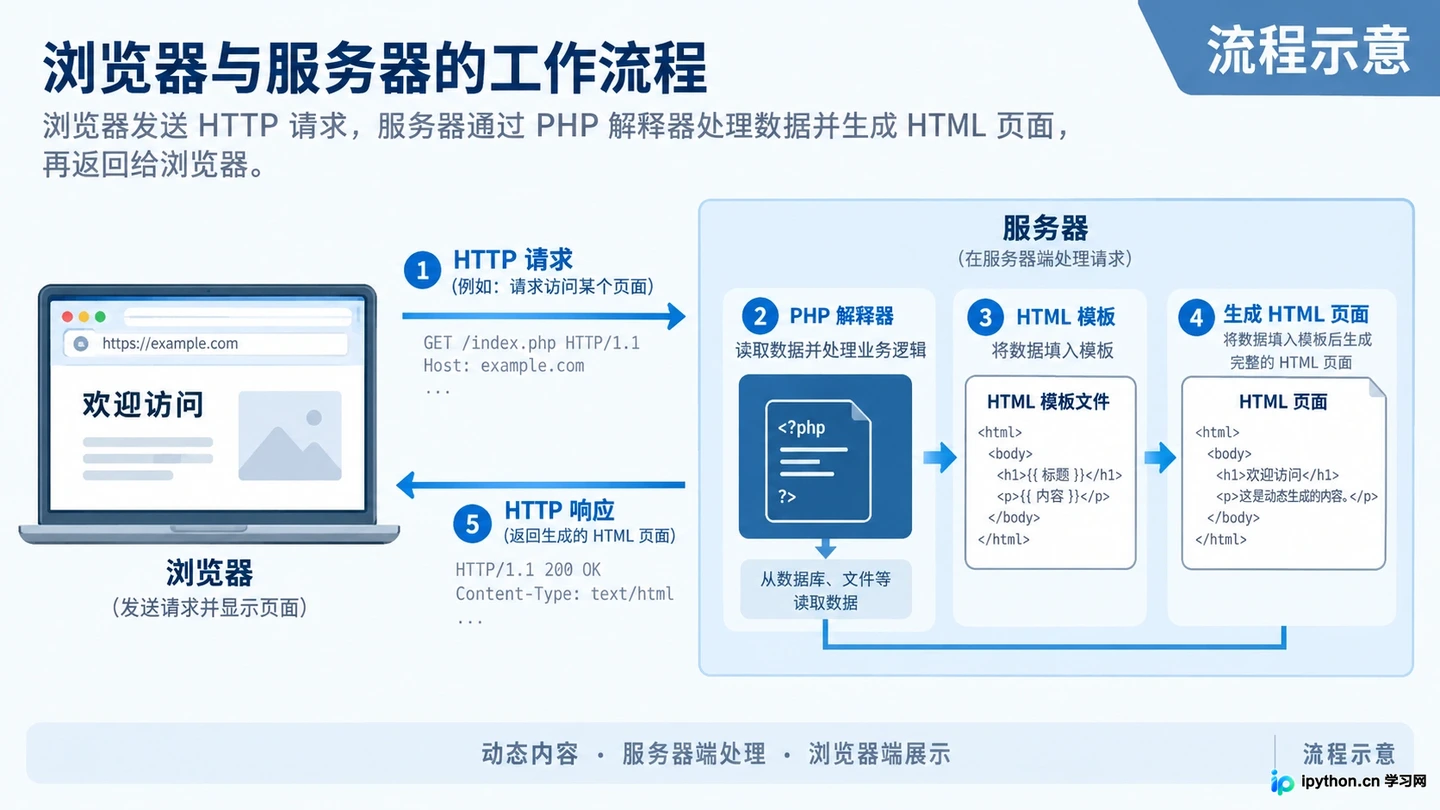
本文从实际Web开发场景出发,解析PHP作为服务器端脚本语言的核心价值。通过动态内容生成、数据库交互及生态兼容性三个维度,阐述PHP如何支撑起从个人博客到大型电商平台的后端逻辑,帮助初学者理解其在现代互联网架构中的不可替代性。