


Python正则表达式re模块核心函数详解

本文系统介绍Python中re模块的核心函数,涵盖match、search、sub、compile、findall、finditer及split等常用方法。详细解析各函数的参数含义、使用场景及与flags标志位的配合,通过代码示例对比match与search的区别,并展示如何利用正则表达式进行字符串匹配、替换、分割及迭代处理,帮助开发者高效掌握Python文本处理技巧。
Python3 正则表达式
正则表达式是一种用于描述字符串模式的特殊字符序列,它能帮助用户便捷地检查字符串是否符合特定规则。本文重点讲解Python标准库中re模块提供的主要函数及其用法。
在深入介绍re模块的具体函数之前,首先需要理解正则表达式的模式概念,即如何利用特定的语法结构来定义一个正则表达式。
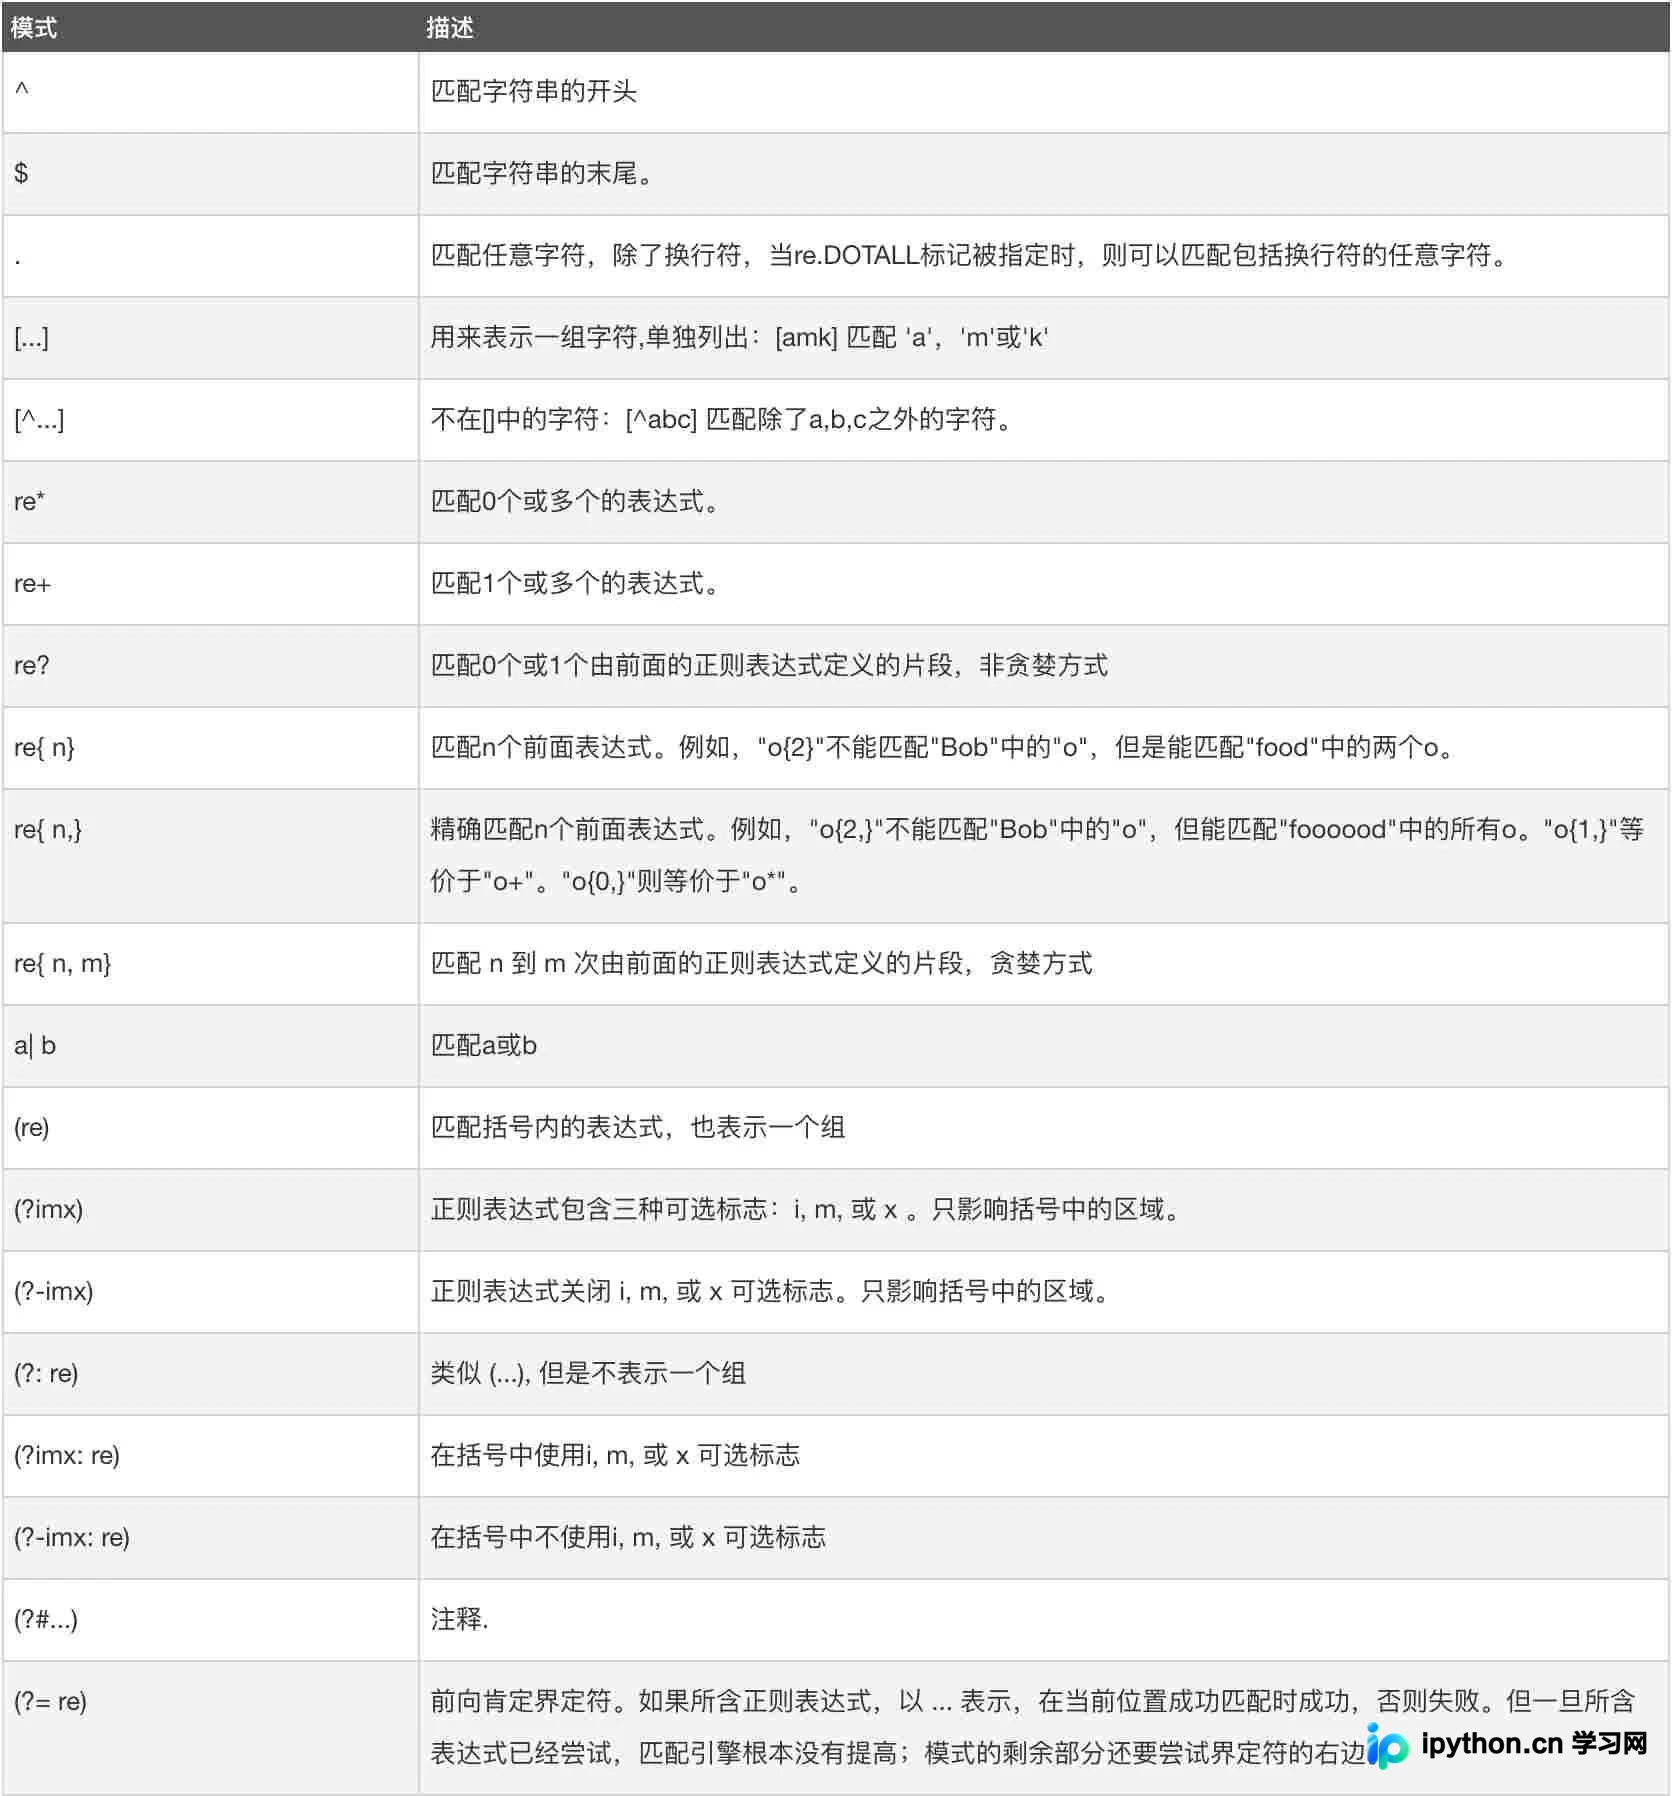
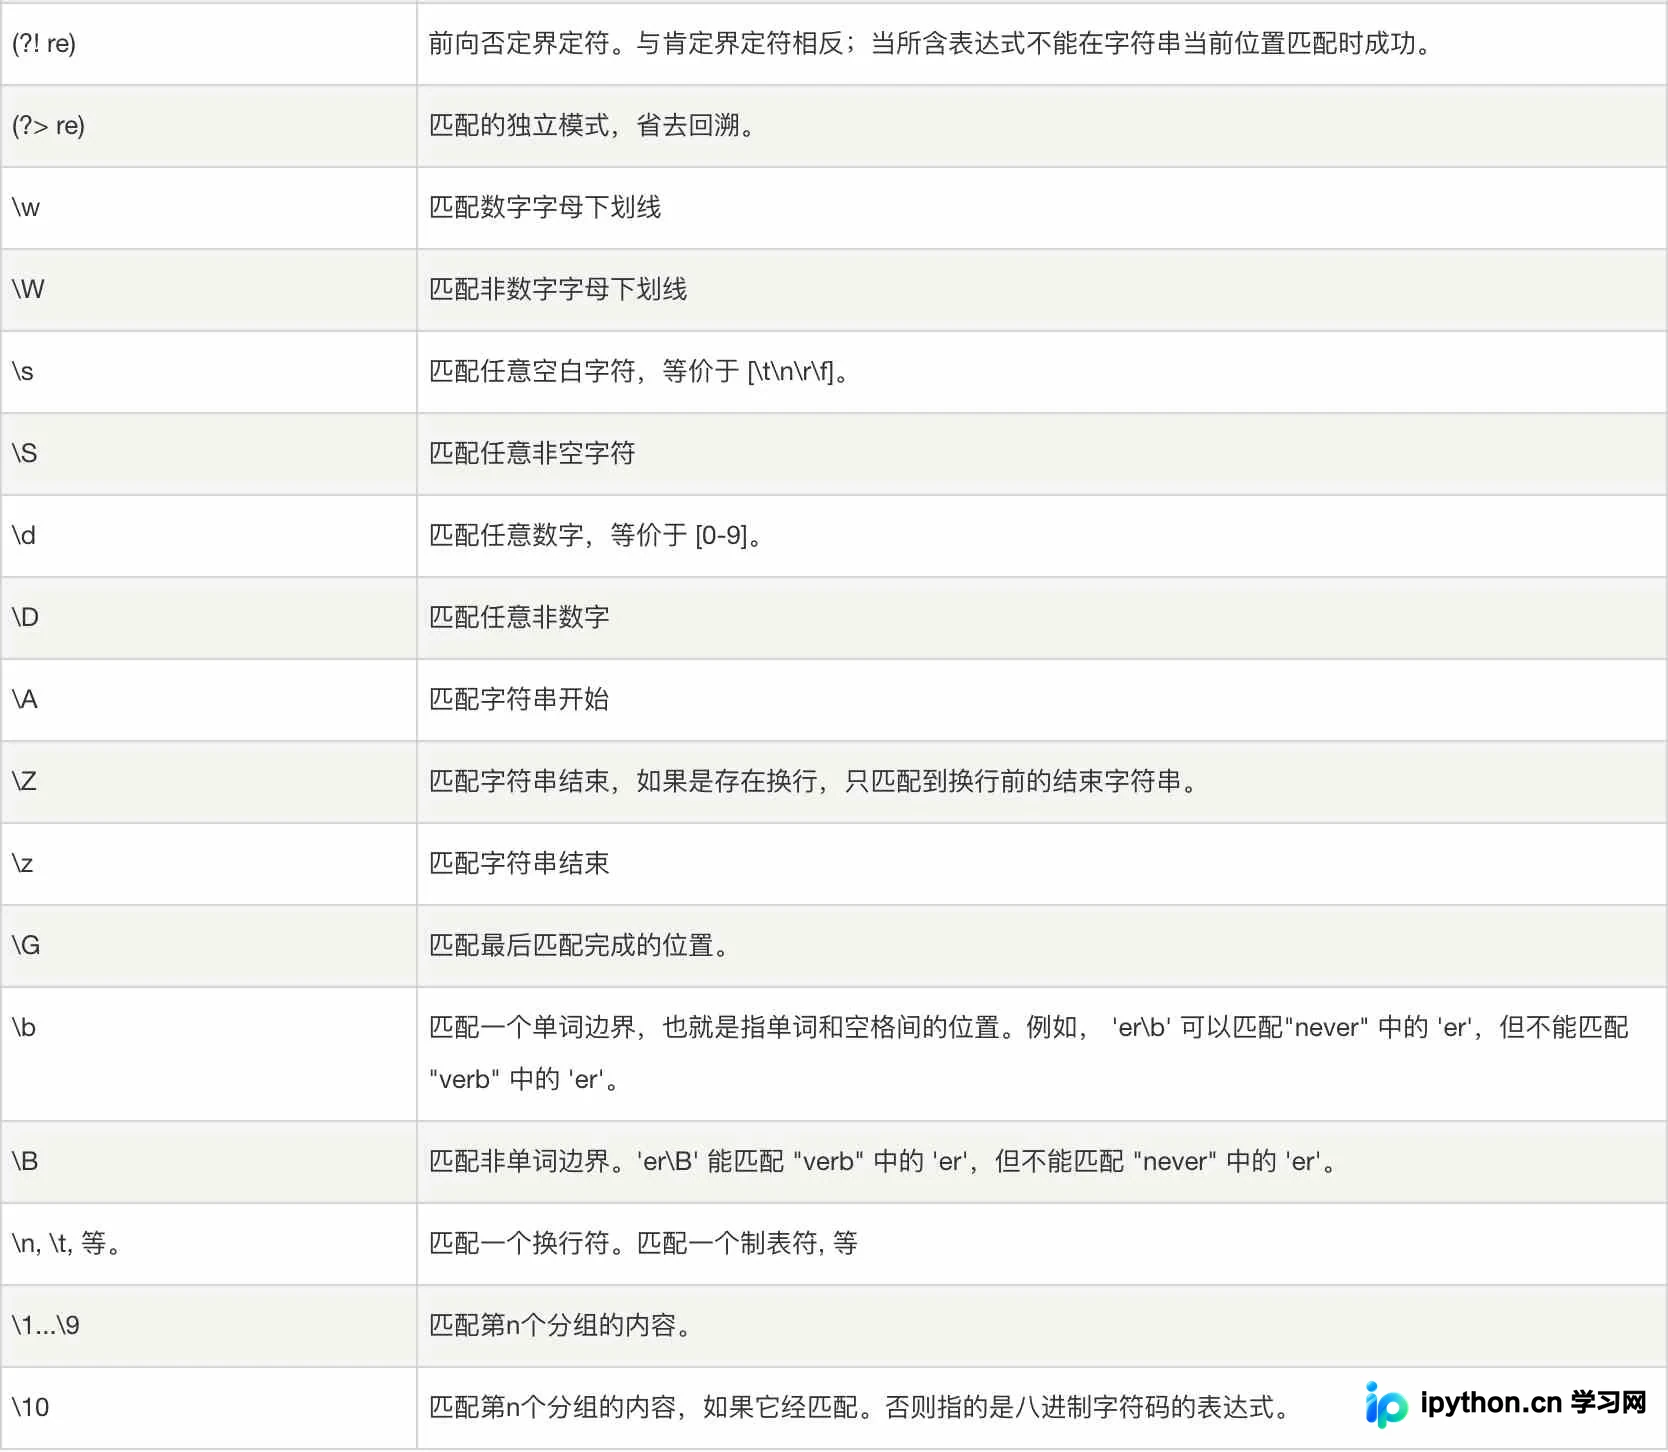
1. match函数
- re.match函数尝试从字符串的起始位置开始匹配指定的模式。如果字符串的起始位置无法匹配该模式,match()函数将返回None。
- 函数基本用法为:re.match(pattern, string, flags=0)
- pattern:所要匹配的正则表达式模式;string:需要匹配的字符串;flags:标志位,用于控制正则表达式的匹配方式,如是否区分大小写、多行匹配等。
- flags参数中,re.I表示忽略大小写匹配。
- re.L表示特殊字符集 \w, \W, \b, \B, \s, \S 的行为依赖于当前本地环境设置。
- re.M启用多行模式;re.S使特殊字符' . '匹配包括换行符在内的任意字符(默认情况下' . '不匹配换行符)。
- re.U表示特殊字符集 \w, \W, \b, \B, \d, \D, \s, \S 的行为依赖于Unicode字符属性数据库。
- re.X用于增加正则表达式的可读性,允许忽略空格以及' # '符号后的注释内容。
匹配对象提供以下方法:
- group(num=0):返回匹配整个表达式的字符串。若一次传入多个组号,则返回包含各组对应值的元组。
- groups():返回一个包含所有小组字符串的元组,组号范围从 1 到正则表达式中定义的小组总数。
import re
print(re.match("xixi", "xixi_haha_heihei").group())
xixi
line = 'Cats are smarter than dogs'
b = re.match(r'(.*) are (.*?) .*', line, re.M|re.I)

print(b.group()) # 返回所有
print(b.group(1)) # 返回第一组,即(.*)对应的
print(b.group(2)) # 返回第二组,即(.*?)对应的
Cats are smarter than dogs
Cats
smarter
2. search函数
re.search函数扫描整个字符串,并返回第一个成功匹配的对象。
函数用法:re.search(pattern, string, flags=0)
print(re.match('heihei', 'xixi_haha_heihei'))
print(re.search('heihei', 'xixi_haha_heihei').group())
None
heihei
line = 'Cats are smarter than dogs'
b = re.search(r'(.*) are (.*?) .*', line, re.M|re.I)

print(b.group()) # 返回所有
print(b.group(1)) # 返回第一组,即(.*)对应的
print(b.group(2)) # 返回第二组,即(.*?)对应的
Cats are smarter than dogs
Cats
smarter
search和match的区别
match函数仅匹配字符串的开头,若开头部分不符合正则表达式,则匹配失败并返回None;而search函数会扫描整个字符串,直到找到第一个匹配项为止。
3. sub函数
re模块提供了re.sub函数,用于替换字符串中符合正则表达式的匹配项。
函数用法:re.sub(pattern, repl, string, count=0, flags=0)
- pattern:正则表达式中的模式字符串。
- repl:用于替换的字符串,该参数也可以是一个函数。
- string:需要被查找和替换的原始字符串。
- count:指定模式匹配后替换的最大次数,默认值为 0,表示替换所有匹配项。
- flags:编译时使用的匹配模式,以数字形式表示。
phone = '133-3333-3333  # this is a phone number'

num = re.sub(r'#.*$', '', phone)
print('phone num', num)
# 移除注释,找到以#开头的。

num = re.sub(r'\D', '', phone)
print('phone num', num)
# 移除非数字内容
phone num 133-3333-3333
phone num 13333333333
当repl参数为函数时的处理情况
def double(matched):
    value = int(matched.group('value'))
    return str(value * 2)

s = 'A233Sfd34'
print(re.sub('(?P<value>\d+)', double, s))
A466Sfd68
4. compile函数
compile函数用于将正则表达式字符串编译成正则表达式对象(Pattern),以便后续供 match() 和 search() 等函数重复使用,提高执行效率。 函数使用:re.compile(pattern, flags)
pattern = re.compile(r'/d+')
m = pattern.match('ones123412')
print(m)
None
5. findall
findall函数在字符串中查找正则表达式所匹配的所有子串,并返回一个列表。若未找到任何匹配项,则返回空列表。 注意:match和search仅匹配一次,而findall会匹配所有符合条件的子串。
函数使用:findall(string, pos, endpos)
- string:待匹配的字符串。
- pos:可选参数,指定字符串搜索的起始位置,默认为 0。
- endpos:可选参数,指定字符串搜索的结束位置,默认为字符串的长度。
pattern = re.compile(r'\d+')
result1 = pattern.findall('xixixix 123 heihiehei 456')
result2 = pattern.findall('xixixix 123 heihiehei 456', 0, 15)

print(result1)
print(result2)
['123', '456']
['123']
6. finditer
finditer的功能与 findall 类似,也是在字符串中找到正则表达式所匹配的所有子串,但它将这些子串作为一个迭代器返回,而非列表。
ittt = re.finditer(r'\d+', '12dsfasdf123asdf534')
for ttt in ittt:
    print(ttt.group())
12
123
534
7. split
split方法依据能够匹配的子串将字符串进行分割,并返回分割后的列表。
函数使用:
re.split(pattern, string, maxsplit=0, flags=0)
- pattern:用于匹配的正则表达式模式。
- string:需要被匹配的原始字符串。
- maxsplit:指定最大分割次数,若maxsplit=1则仅分隔一次,默认为 0,表示不限制分割次数。
- flags:标志位,用于控制正则表达式的匹配方式,例如是否区分大小写或多行匹配等。
print(re.split('\W+', 'xxixix, xixixi, hehiehei'))
print(re.split('(\W+)', ' xxixix, xixixi, hehiehei'))
['xxixix', 'xixixi', 'hehiehei']
['', ' ', 'xxixix', ', ', 'xixixi', ', ', 'hehiehei']
总结
本文介绍了Python正则表达式re模块的核心内容,希望能为读者提供帮助。欢迎持续关注本站,获取更多技术更新与资源!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















