


MySQL属于关系型数据库吗?解析其核心特点与结构

直接给出明确结论:MySQL不仅属于关系型数据库,而且是目前全球应用最广泛的开源关系型数据库管理系统(RDBMS)之一。它以严谨的行与列构建二维表格,通过标准结构化查询语言(SQL)进行操作,并依托主键、外键以及严格的事务机制来确保数据之间的一致性与完整性。
什么是关系型数据库?判断MySQL属性的标准
要准确理解 MySQL 为何属于关系型数据库,首先需要明确“关系”这一概念在计算机领域的实际含义。这里的“关系”源于数学家埃德加·科德(E. F. Codd)提出的关系代数模型。在实际工程落地时,“关系”被具体映射为一张由行(元组)和列(属性)组成的二维表格。
判断一个数据库是否为关系型数据库(RDBMS),通常对照以下四项核心特征:
- 二维表格组织:所有业务实体及其属性必须以表格结构规整存放,表中的每一列具有统一的数据类型与约束。
- 关系建模支持:能够通过一对一、一对多或多对多建立表与表之间的约束关联,典型载体是主键(Primary Key)与外键(Foreign Key)。
- 标准 SQL 支持:支持使用结构化查询语言(Structured Query Language)进行数据定义(DDL)、操作(DML)与事务控制(TCL)。
- ACID 事务保障:具备原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)和持久性(Durability),保证高并发场景下数据读写的绝对可靠。
MySQL 完全符合上述每一项指标。无论是底层的实体联系建模,还是上层的查询语法支持,它都是标准的关系型数据库。
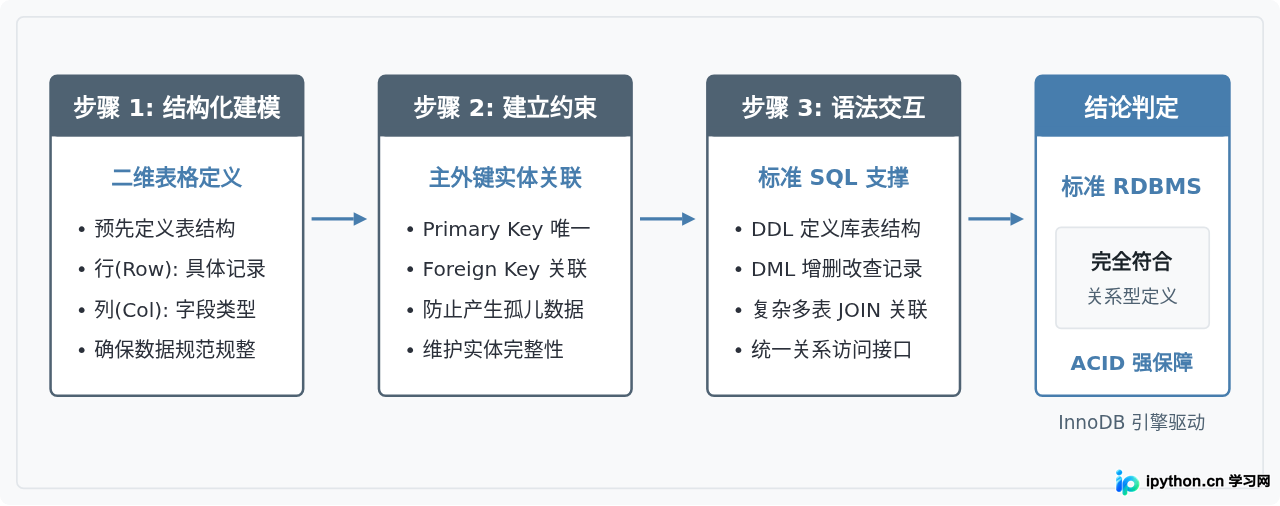
MySQL 的四大核心特点
作为关系型数据库的典型代表,MySQL 之所以能在互联网服务中长期占据主流地位,关键在于其成熟的事务支持、高效的数据管理能力以及高度可扩展的生态体系。
1. 严格支持 ACID 事务特性
在 MySQL 默认的 InnoDB 存储引擎下,所有修改操作都可以纳入事务控制,遵循四项底层原则:
- 原子性(A):事务内的所有 SQL 要么全部执行成功,要么全部回滚。底层依赖
undo log(回滚日志)提供撤销能力。 - 一致性(C):业务状态从一个有效状态变更到另一个有效状态,不破坏定义的任何约束与业务完整性。
- 隔离性(I):多个并发事务交叉运行时相互隔离。MySQL 通过多版本并发控制(MVCC)配合锁机制(行锁、间隙锁)解决脏读、不可重复读和幻读问题。
- 持久性(D):事务一旦提交,数据即永久写入磁盘。即使系统突发掉电,也可以通过
redo log(重做日志)在重启时恢复已提交内容。
2. 基于“主键-外键”的实体关联与完整性约束
关系型数据库通过关系约束杜绝无效或孤立的数据。例如,通过设置主键保证单行实体的唯一性;设置外键约束防止订单记录指向不存在的用户。同时支持 NOT NULL、UNIQUE 以及 CHECK 等多种数据级校验。
3. 插件式存储引擎体系
这是 MySQL 区别于 Oracle、PostgreSQL 等数据库的独特设计。MySQL 将“逻辑解析计算层”与“物理存储读写层”解耦,允许开发者针对不同的业务表选用不同的存储引擎:
- InnoDB:支持事务、外键、行级锁与崩溃恢复,是绝大多数业务系统的默认选择。
- MyISAM:早期默认引擎,支持表级锁,不支持事务,占用磁盘较小,现已较少用于核心事务系统。
- Memory:全内存存储引擎,读写速度极快,常用于临时数据汇总,重启后数据丢失。
4. 丰富成熟的高可用与扩展架构
MySQL 具备完备的主从复制(Replication)生态。通过记录并重放 binlog,可以快速实现“一主多从”的读写分离架构,显著分摊生产环境的读并发压力,并在主节点出现硬件故障时平滑切换。
解析 MySQL 的分层体系结构
为了实现高效可靠的关系型计算,MySQL 在架构上清晰地划分为三层:连接层、服务层与存储引擎层。
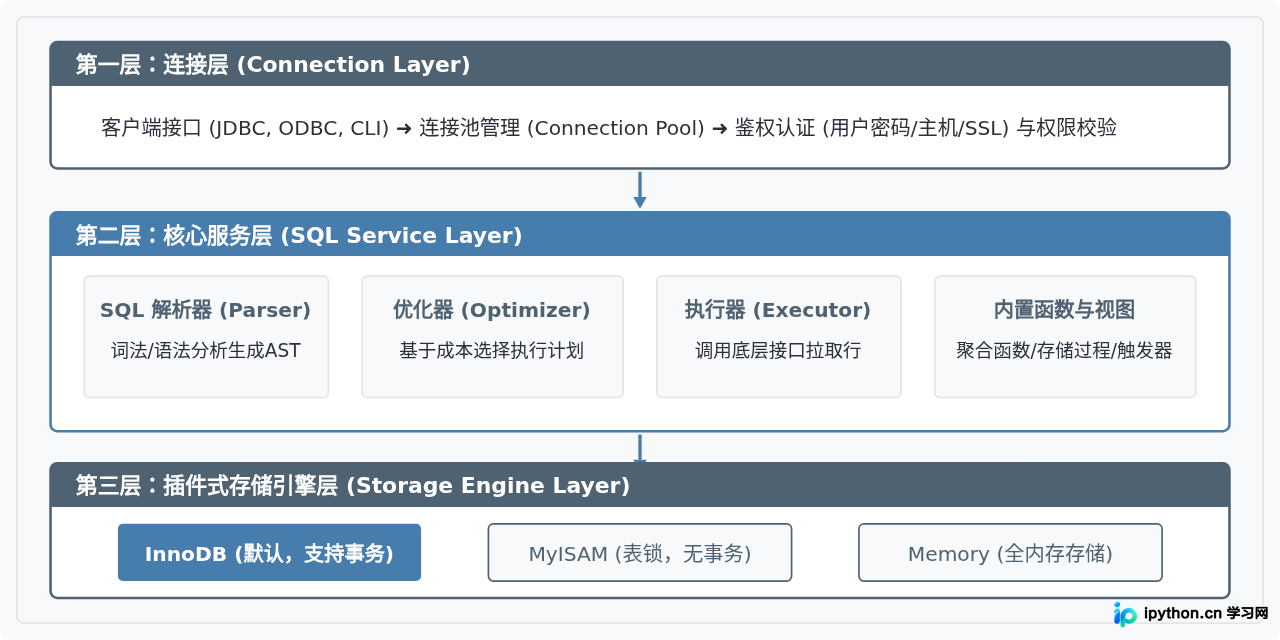
- 连接层(Connection Layer):负责处理外部应用与客户端工具发起的网络连接(TCP/IP、本地套接字等)。采用线程池或多线程模型管理连接生命周期,并验证用户的账号、密码及主从 IP 访问权限。
-
服务层(SQL Service Layer):MySQL 的运算大脑。所有跨存储引擎的功能都在此层完成。
- 解析器(Parser):校验语法规范,把 SQL 文本转化成抽象语法树(AST)。
- 优化器(Optimizer):分析索引使用情况与数据统计信息,基于计算成本(CBO)生成最优执行计划。
- 执行器(Executor):检查表的列级与表级操作权限,然后调用存储引擎的 API 接口读取或写入数据。
- 存储引擎层(Storage Engine Layer):具体负责底层磁盘文件或内存中数据的实际读取与持久化写入。服务层不关心数据在物理介质上是如何排列的,所有数据交互均通过统一的引擎接口封装实现。
实操验证:关系型结构的建立与数据关联
为了直观展示关系型数据库的核心特性,以下通过一个标准电商场景展开:创建一个用户表 users 和一个订单表 orders,并通过外键建立数据完整性约束。
1. 编写 DDL 建立数据表与关联关系
-- 1. 创建用户主表
CREATE TABLE users (
    user_id INT AUTO_INCREMENT PRIMARY KEY,
    username VARCHAR(50) NOT NULL,
    email VARCHAR(100) UNIQUE NOT NULL,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;

-- 2. 创建订单从表,并通过外键关联 users 表
CREATE TABLE orders (
    order_id INT AUTO_INCREMENT PRIMARY KEY,
    user_id INT NOT NULL,
    order_amount DECIMAL(10, 2) NOT NULL,
    order_status VARCHAR(20) DEFAULT 'PENDING',
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    CONSTRAINT fk_orders_user
        FOREIGN KEY (user_id) REFERENCES users(user_id)
        ON DELETE CASCADE ON UPDATE CASCADE
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
2. 插入测试数据并执行关联查询
-- 插入合规的基础数据
INSERT INTO users (username, email) VALUES
('Alice', 'alice@example.com'),
('Bob', 'bob@example.com');

INSERT INTO orders (user_id, order_amount, order_status) VALUES
(1, 199.50, 'PAID'),
(1, 45.00, 'SHIPPED'),
(2, 320.00, 'PAID');

-- 执行关系型多表关联查询 (INNER JOIN)
SELECT
    u.user_id,
    u.username,
    o.order_id,
    o.order_amount,
    o.order_status
FROM users u
INNER JOIN orders o ON u.user_id = o.user_id
WHERE o.order_amount > 50.00;
执行上述关联查询后,控制台返回合并后的规范二维结果:
-- 示例输出:
+---------+----------+----------+--------------+--------------+
| user_id | username | order_id | order_amount | order_status |
+---------+----------+----------+--------------+--------------+
|       1 | Alice    |        1 |       199.50 | PAID         |
|       2 | Bob      |        3 |       320.00 | PAID         |
+---------+----------+----------+--------------+--------------+
2 rows in set (0.00 sec)INSERT INTO orders (user_id, order_amount) VALUES (999, 50.00);(user_id=999 并不存在),MySQL 会立即报错:ERROR 1452 (23000): Cannot add or update a child row: a foreign key constraint fails。这种在数据库引擎层强制拦截破坏完整性操作的机制,正是关系型数据库的核心价值所在。
SQL 查询在 MySQL 内部的实际流转过程
当你在客户端输入一条 SQL 并按下回车,MySQL 内部会严格按照逻辑先后顺序进行处理。以常见的 SELECT 查询为例,执行流程包含六个关键步骤:
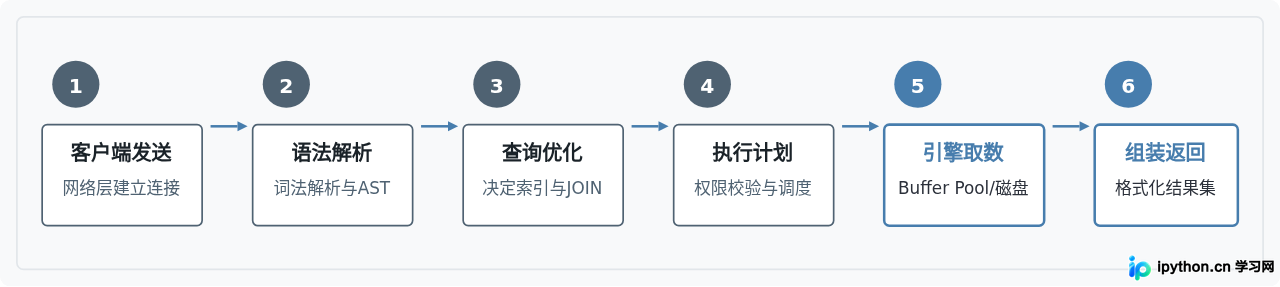
值得说明的是,早期 MySQL(5.7 及更早版本)在解析之前包含一个“查询缓存(Query Cache)”环节。但由于表数据只要发生微小变动该表所有缓存就会瞬间失效,实际命中率极低且锁竞争严重,官方已在 MySQL 8.0 中彻底移除了查询缓存模块。
MySQL 与常见非关系型(NoSQL)数据库的对比
为了帮助读者更清晰地判断业务选型,下表梳理了以 MySQL 为代表的 RDBMS 与主流 NoSQL(如 Redis、MongoDB)在核心维度的区别:
| 对比维度 | MySQL (RDBMS) | MongoDB (文档型 NoSQL) | Redis (键值型 NoSQL) |
|---|---|---|---|
| 数据结构 | 二维表格,预先定义 Schema | BSON 文档(树形/JSON 结构),无固定 Schema | Key-Value(支持字符串、哈希、列表、集合等) |
| 事务支持 | 完备的 ACID 事务(默认 InnoDB 引擎) | 多文档事务(支持但不如关系型灵活轻便) | 弱事务(保证单操作原子性,不支持回滚) |
| 查询方式 | 标准 SQL,支持极其复杂的多表 JOIN 关联 | JSON 风格查询语句,弱关联 | 固定命令式 API,无法多表关联合并 |
| 持久化机制 | 以磁盘持久化为主,内存(Buffer Pool)加速 | 磁盘持久化存储(WiredTiger 引擎) | 纯内存读写,配合 RDB 快照与 AOF 日志刷盘 |
| 典型场景 | 交易、订单、账户、具有严格业务约束的核心系统 | 日志聚合、内容管理、动态表单、结构频繁变更的数据 | 高频热点数据缓存、会话管理、分布式锁、实时计数 |
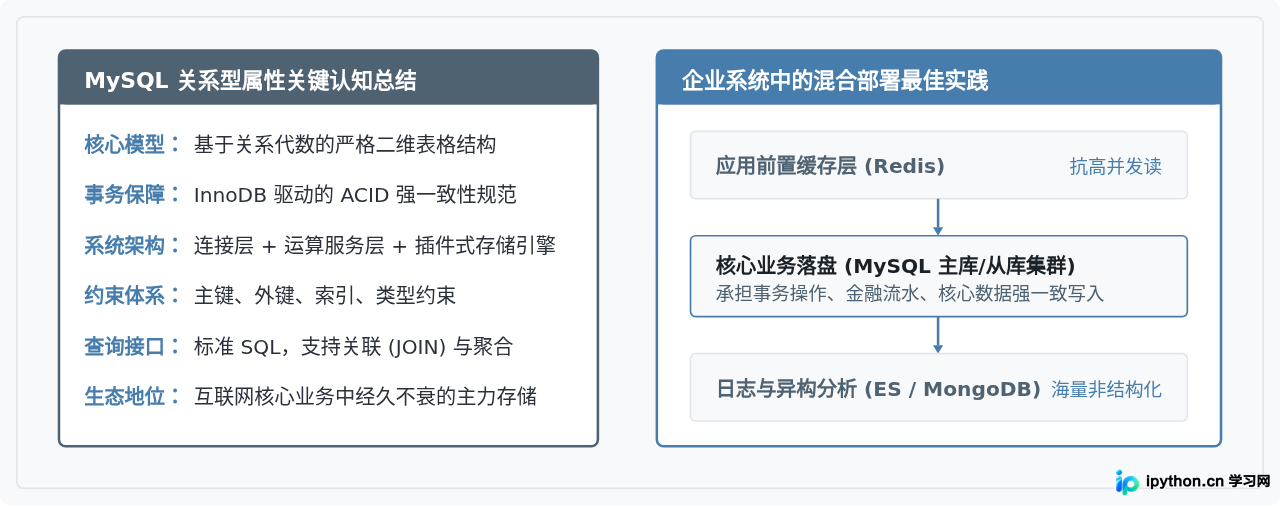
总结
毫无疑问,MySQL 是一款纯正且功能强大的开源关系型数据库。其核心基石在于规范的二维表格结构、完备的约束机制和标准的 SQL 语言支持;而其生命力则源于灵活的三层解耦架构以及由 InnoDB 引擎实现的严格 ACID 事务控制。
在现代后端工程体系中,关系型数据库与 NoSQL 并非简单的替代关系,而是分工互补:由 Redis 负责前置缓冲热点数据,由 MongoDB 等处理复杂或动态文档,而由 MySQL 坐镇最核心的数据底座,负责守护资产流水、用户账户与核心订单的绝对一致性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















