


C++贝叶斯分类器实现手写数字识别

发布时间:2026-10-16 |
6人浏览过
本文介绍使用C++配合OpenCV及朴素贝叶斯算法实现手写数字识别的完整方案,涵盖贝叶斯概率原理、图像特征提取与模型训练步骤。
贝叶斯分类器识别原理
贝叶斯公式的核心思想是通过先验概率和似然概率来估算后验概率,从而对样本进行分类。
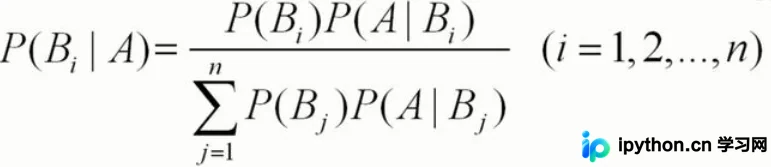
在手写数字识别任务中,目标是计算给定测试图像属于某个数字(如0-9)的概率。由于分母是常数,比较概率大小时可简化为比较分子。算法首先需将图像转换为二维特征向量(即每个像素点的状态),然后统计每个类别下各特征出现的概率。
第1步:图像数字化与特征压缩
目的:将原始图片转化为计算机易于处理的二进制字符串,并降低维度。
入口:读取训练集与测试集的文件夹。
动作:
- 读取BMP格式的二值化图像。
- 将灰度值大于阈值(如127)的像素点标记为1,否则标记为0。
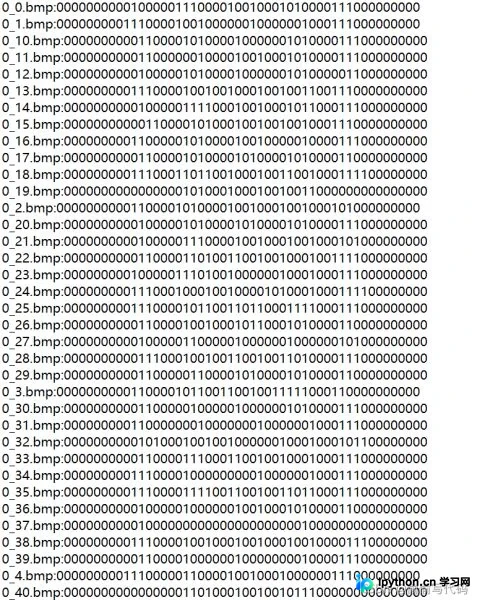
- 采用降采样策略:对于28x28的原图,每4x4的区域统计黑色像素总和,若大于等于6则将该区域压缩为一个1,否则为0。最终得到7x7共49个特征的字符串。
完成状态:得到一个包含数字标签与对应49位特征字符串的文本文件。
第2步:构建分类模型(概率统计)
目的:计算每个数字(0-9)在每一位上出现“1”的先验概率。
操作说明:
- 遍历所有训练好的样本数据。
- 按列(即每个特征位)统计各个数字样本为“1”的总次数。
- 除以该数字类别的总样本数,得到概率数组。
probability[数字][位索引],形成一个10x49的二维概率表。
关键参数:假设每个数字出现的概率相等(均为1/10),因此无需额外加权。
第3步:预测与评估
目的:利用构建的概率表对新输入的测试图像进行分类判定。
操作说明:
- 获取待测样本的特征字符串。
- 初始化一个长度为10的数组,存储当前测试样本分别属于数字0-9的可能性得分。
- 对于每一位特征,若特征值为1,则乘以该数字在该位的概率;若特征值为0,则乘以(1 - 该数字在该位的概率)。
- 得出最终的10个得分值,选择最大值对应的数字作为识别结果。
注意:为防止浮点数相乘导致精度丢失过小难以分辨,代码中采用了缩放方式计算,并在最后通过比较大小确定输出。
C++代码实现解析
以下为基于OpenCV与标准C++实现的完整示例代码。代码包含文件遍历、图像处理压缩、概率矩阵计算及识别判定逻辑。
#include<iostream>
#include<fstream>
#include<opencv2/opencv.hpp>
#include<opencv2/highgui.hpp>
#include<opencv2/core.hpp>
#include<io.h>                          //api和结构体
#include<string.h>
#include<string>
#include<sstream>                     //string 转 int 数据类型包含
using namespace std;
using namespace cv;
void ergodicTest(string filename, string name);    //遍历函数
string Image_Compression(string imgpath);          //压缩图片并返回字符串
void Bayes();                                     //贝叶斯分类器
int turn(char a);
void main()
{
	const char* filepath = "E:\\learn\\vsfile\\c++project\\pictureData\\train-images";
	ergodicTest(filepath, "train_num.txt");         //处理训练集
	const char* test_path = "E:\\learn\\vsfile\\c++project\\pictureData\\test-images";
	ergodicTest(test_path, "test_num.txt");
	Bayes();

}
void ergodicTest(string filename, string name)       //遍历并把路径存到files
{
	string firstfilename = filename + "\\*.bmp";
	struct _finddata_t fileinfo;
	intptr_t handle;            //不能用long,因为精度问题会导致访问冲突,longlong也可
	string rout = "E:\\learn\\vsfile\\c++project\\pictureData\\" + name;
	ofstream file;
	file.open(rout, ios::out);
	handle = _findfirst(firstfilename.c_str(), &fileinfo);
	if (_findfirst(firstfilename.c_str(), &fileinfo) != -1)
	{
		do
		{
			file << fileinfo.name<<":"<< Image_Compression(filename + "\\" + fileinfo.name) << endl;
		} while (!_findnext(handle, &fileinfo));
		file.close();
		_findclose(handle);
	}
}

string Image_Compression(string imgpath)   //输入图片地址返回图片二值像素字符
{
	Mat Image = imread(imgpath);               //输入的图片
	cvtColor(Image, Image, COLOR_BGR2GRAY);
	int Matrix[28][28];                        //将digitization转化为字符串类型
	for (int row = 0; row < Image.rows; row++)  //把图片的像素点传给数组
		for (int col = 0; col < Image.cols; col++)
		{
			Matrix[row][col] = Image.at<uchar>(row, col);
		}
	string img_str = "";                   //用来存储结果字符串
	int x = 0, y = 0;
	for (int k = 1; k < 50; k++)
	{
		int total = 0;
		for (int q = 0; q < 4; q++)
			for (int p = 0; p < 4; p++)
				if (Matrix[x + q][y + p] > 127) total += 1;
		y = (y + 4) % 28;
		if (total >= 6) img_str += '1';    //将28*28的图片转化为7*7即压缩
		else img_str += '0';
		if (k % 7 == 0)
		{
			x += 4;
			y = 0;
		}
	}
	return img_str;
}

int turn(char a)  //这个函数是把string类型转换成int类型
{
	stringstream str;
	int f = 1;
	str << a;
	str >> f;
	str.clear();
	return f;
}

void Bayes()
{
	ifstream data_test, data_train;     //从两个数据字符串文件中取数据的文件流
	string temp;                        //中间暂存字符串的变量
	double count[10] = { 0 };                      //用来计数每个数字样本1个数
	double probability[10][49] = { 0 };
	int t = 0;            //避免算数溢出

	for (int i = 0; i < 49; i++)    //按列处理训练样本(每一个样本数据长度位49位)
	{
		data_train.open("E:\\learn\\vsfile\\c++project\\pictureData\\train_num.txt");
		for (int j = 0; j < 1000; j++)   //按顺序取一千次数据
		{
			getline(data_train, temp);    //顺序取每一行数据
			if (temp.length() == 57)   //本来长度是49,因为我有文件名所以要跳过文件名
			{
				t = i + 8;     //用t来代替i+8是因为string的[]中没有+-重载,好像是这样
				if (turn(temp[t]) == 1) count[turn(temp[0])]++;         //相应数字为1计数加1
				else continue;
			}
			else if(temp.length() == 58)
			{
				t = i + 9;   //有的文件名为8位有的为9位
				if (turn(temp[t]) == 1) count[turn(temp[0])]++;         //相应数字
				else continue;
			}
		}
		data_train.close();  //一定要注意文件流打开和关闭的时机,打开和关闭一次之间是一次完整的遍历(getline)
		for (int q = 0; q < 10; q++)
		{
			probability[q][i] =count[q] / 100.0;                //计算每个数字数据样本的每一位1的概率
			count[q] = 0;//循环还要使用count,所以要初始化
		}
	}

	double probab[10] = { 1,1,1,1,1,1,1,1,1,1 };     //该数组是这个数字的概率(10个数字)
	data_test.open("E:\\learn\\vsfile\\c++project\\pictureData\\test_num.txt");
	double temp_prob = 0;             //对比可能性的中间变量:概率
	int temp_num = -1;                //对比可能性的中间变量:数字
	bool flag = true;                 //标志拒绝识别,假就拒绝
	int num_r = 0, num_f = 0, num_t = 0;   //分别表示拒绝,错误,正确
	for (int d = 0; d < 200; d++)    //200个测试样本
	{
		for (int o = 0; o < 10; o++) probab[o] = 1;//初始化概率数组,虽然前面有初始化,但是我们循环会多次使用,所以我们要每循环一次初始化一次
		getline(data_test, temp);
		for (int y = 0; y < 10; y++)   //分别和每个数字得出一个概率,既该测试用例是这个数字的概率
		{
			for (int s = 0; s < 49; s++)  //49位对应去累乘得到概率
			{
				if (temp.length() == 57)
				{
					t = s + 8;
					if (turn(temp[t]) == 1) probab[y] *=1+probability[y][s];        //加1是因为零点几越乘越小,不好比较,而且有的概率可能为0,
					else probab[y] *= 2 - probability[y][s]; //同样的,为0的概率也要加上1
				}
				else
				{
					t = s + 9;
					if (turn(temp[t]) == 1) probab[y] *=1+probability[y][s];         //相应数字
					else probab[y] *= (2 - probability[y][s]);
				}
			}
		}

		flag = true;         //标志置位真
		temp_prob = 0;       //重置中间变量
		temp_num = -1;       //开始前不标识为任何数值
		for (int l = 0; l < 10; l++)  //比较测试用例是某个数字的概率,确定最大的那个
		{
			if (probab[l] > temp_prob)
			{
				temp_prob = probab[l];
				temp_num = l;
				flag = true;          //不被拒绝
			}
			else if (probab[l] == temp_prob )
			{
				flag = false;          //拒绝识别
			}
		}
		if (!flag)
		{
			num_r++;
		}
		else
		{
			cout << temp[0] << " " << temp_num << endl;
			if (temp_num == turn(temp[0]))
			{
				cout << "识别为:" << temp_num << endl;
				num_t++;
			}
			else
			{
				cout << "识别错误!" << endl;
				num_f++;
			}
		}
	}
	data_test.close();
	cout << "拒绝识别率为:" << num_r / 200.0 << endl;
	cout << "正确识别率为:" << num_t / 200.0 << endl;
	cout << "错误识别率为:" << num_f / 200.0 << endl;
}
环境准备与注意事项
在运行上述代码前,请确保开发环境中已安装以下依赖:
- OpenCV:需正确配置头文件路径和动态链接库(dll/lib)。Windows环境下可通过包管理器或源码编译安装。
- 数据源:代码默认寻找目录下的
.bmp格式图像文件,需要预先建立好对应的文件夹结构(训练集与测试集)以及手动创建的.txt记录文件。
关于代码的结构优化建议:目前 Bayes() 函数承担了较多逻辑,在实际生产环境中建议拆分为独立的预处理、训练与推理模块,以提高可读性与调试效率。
以上就是C++贝叶斯分类器实现手写数字识别的详细内容,更多关于实现手写数字识别的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















