


详解NumPy中np.nanmax与数组.max()的区别及避坑指南

在数据分析与科学计算中,处理包含缺失值(NaN)的数值数组时,直接调用最大值或均值函数极易返回意外结果。本文深度对比np.nanmax与数组.max()的底层差异,解析自动过滤NaN的计算逻辑,提供多场景执行效率参考,并系统梳理常见统计函数的正确调用方式,帮助开发者规避数据处理陷阱。
核心差异与计算原理
在使用Pandas或NumPy进行数据运算时,缺失值的处理方式是导致结果意外的主要原因。Pandas的Series对象内置了跳过缺失值的机制,默认情况下调用max()方法会直接忽略NaN并返回正常最大值。
import pandas as pd
import numpy as np

s1 = pd.Series([1, 2, 3, 4, np.nan])
print(s1.max())  # 输出为 4.0
然而,当通过.values将Series转为纯NumPy ndarray后,调用原生.max()方法时,NumPy会将NaN视为普通浮点数参与比较。根据IEEE 754标准,任何与NaN的比较都会返回False,导致最终计算结果直接变为NaN,而非预期的最大值。
s1_arr = s1.values
print(s1_arr.max())  # 输出为 nan
若需使用NumPy直接获取忽略缺失值的最大值,应改用np.nanmax()。该函数内部会自动过滤NaN后再进行极值查找,从而返回准确的数值。除max()外,min()、mean()、std()等聚合函数在遇到NaN时同样会受此规则影响。
执行效率对比
在实际项目尤其是处理海量数据表时,计算速度是重要的考量因素。针对同一数据集,不同方式的性能表现大致如下:
s1 = pd.Series([1, 2, 3, 4, 5, np.nan])
# 性能排序参考:np.nanmax(array) > np.nanmax(series) > series.max()
print(np.nanmax(s1.values))
print(np.nanmax(s1))
print(s1.max())
注:实际运行耗时受Python版本、NumPy编译优化及硬件环境的影响,上述排序基于常规CPU单核测试场景,生产环境中建议结合perf或timeit模块进行针对性压测。
常见统计函数与NaN处理流程
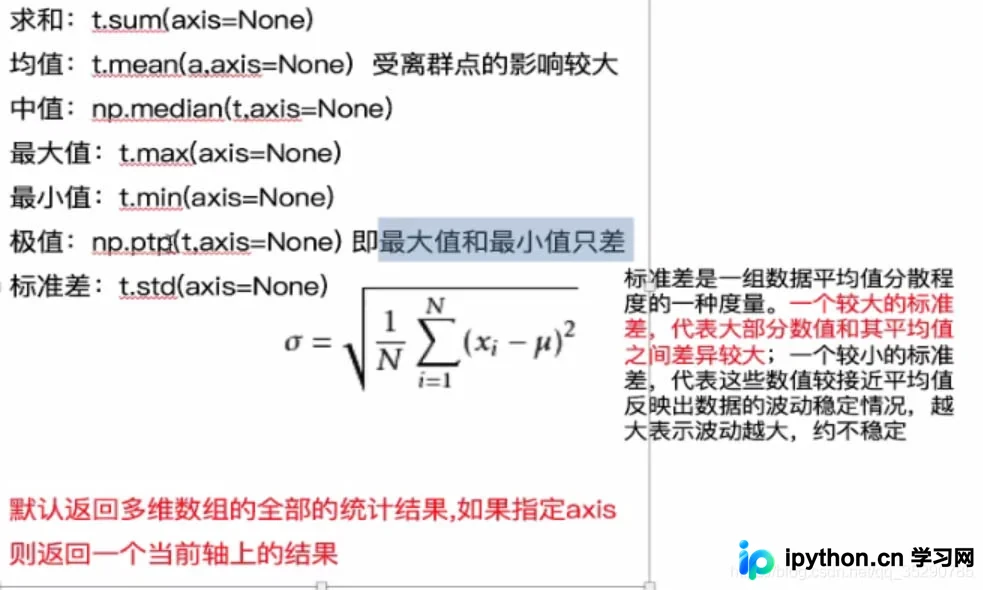
除了极值查询,NumPy还提供了完善的数组统计工具集。结合isnan()定位缺失值并进行填充或剔除,是标准化的数据处理前置步骤。以下代码演示了完整的基础统计流程:
#!/usr/bin/env python
# -*- coding:utf-8 -*-
import numpy as np

# 1. 创建含NaN的浮点数组
a = np.arange(9, dtype=float).reshape(3, 3)
a[[[1], [2]]] = np.nan

# 2. 检测并替换NaN(可替换为中位数或均值)
mask = np.isnan(a)
a[mask] = 0  # 实际操作中常使用a[mask] = np.nanmedian(a)

# 3. 基础统计与聚合
b = np.arange(12, dtype=int).reshape(2, 6)
print(b)
print("按列求和:", np.sum(b, axis=0))
print("按行求和:", np.sum(b, axis=1))
print("全局均值:", b.mean())
print("按列均值:", b.mean(axis=0))
print("按行均值:", b.mean(axis=1))
print("按列中位数:", np.median(b, axis=0))
print("全局最小值/最大值:", b.min(), b.max())
print("极差(ptp):", np.ptp(b))
print("按列标准差:", np.std(b, axis=0))
上述操作涵盖了从数据初始化、掩码过滤到多维降维统计的完整链路。配合axis参数控制运算维度,能够高效完成表格型数据的特征提取。
总结
掌握np.nanmax与原生聚合函数的行为差异,能有效规避大规模数值计算中的隐性故障。合理搭配isnan掩码、指定轴聚合以及专用的nan系列函数,是保障Python科学计算管线稳定运行的核心实践。
以上就是NumPy中处理NaN值的核心技巧与避坑指南的详细内容,更多关于Python科学计算与数据清洗的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















