


Python爬虫框架Newspaper使用详解与避坑指南

本文详细介绍Python爬虫框架Newspaper的安装、基本用法及高级功能。通过单条新闻获取、缓存机制配置及多任务爬取等实例,展示其核心能力。同时指出该框架在中文环境下可能存在的识别BUG,并提供结合requests与bs4的替代建议,帮助开发者更高效地实现内容抓取。
写在前面
原计划继续撰写关于Portia的使用教程,但在编写代码过程中发现,在Windows 7的DockerToolbox环境中运行Portia时错误频发。建议读者尽量在Linux虚拟机或直接部署在服务器上进行操作,以避免不必要的精力消耗。
今天我们将话题转向另一款工具newspaper。
newspaper
GitHub地址:github.com/codelucas/n…
从名称即可推测,该库与报纸或新闻内容相关。它主要用于文章的抓取和整理,由国内开发者主导,其GitHub页面也收录了其他开发者的推荐意见。
例如,requests库作者在Twitter上曾给予高度评价。
"Newspaper is an amazing python library for extracting & curating articles."
The Changelog网站也专门撰写了评价文章,值得参考。
Newspaper delivers Instapaper style article extraction.
鉴于这款爬虫库已走向国际,我们有必要对其进行详细介绍。
安装过程非常简单。
pip install newspaper3k -i pypi.tuna.tsinghua.edu.cn/simple
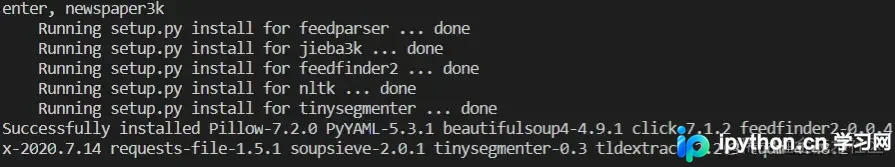
官方文档查阅地址:newspaper.readthedocs.io/en/latest/u…
newspaper框架的使用
该框架的使用难度较低,简单参照文档页面即可上手应用。
例如:单条新闻内容获取
第一种应用场景是直接获取网页内容。
from newspaper import Article
url = "https://36kr.com/p/857678806293124"
article = Article(url) # 创建文章对象
article.download()        # 加载网页
article.parse()           # 解析网页
print(article.html) # 打印html文档
当然,该框架还提供其他属性,但它是基于关键字识别的,因此存在一些BUG,有时识别结果可能不准确。
# print(article.html) # 打印html文档
print(article.text) # 新闻正文
print("-"*100)
print(article.title) # 新闻标题
print("-"*100)
print(article.authors)  # 新闻作者
print("-"*100)
print(article.summary)   # 新闻摘要
print(article.keywords) # 新闻关键词
# print(article.top_image) # 本文的top_image的URL
# print(article.images) # 本文中的所有图像url
newspaper文章缓存
默认情况下,newspaper会缓存所有待提取的文章,一旦文章被爬取完毕,缓存即被清除。此功能旨在防止重复爬取并提高提取速度。可以通过设置memoize_articles参数来选择是否启用缓存。
然而,当我尝试使用上述方法提取文章时,遇到了一个神奇的BUG,始终无法获取到预期的文章内容。看来该框架的完善工作仍需持续进行。
import newspaper
url = "https://news.sina.com.cn/c/2020-08-29/doc-iivhvpwy3651884.shtml"
# article = Article(url) # 创建文章对象
# article.download()        # 加载网页
# article.parse()           # 解析网页
news = newspaper.build(url, language='zh', memoize_articles=False)
article = news.articles[0]
article.download()
article.parse()
print('title=',article.title)
其他功能
在实际应用中发现,该框架的解析功能存在较大问题,但整体框架设计思路值得肯定。虽然前期期待较高,后期体验却有所落差。参考GitHub上的评价,对newspaper曾抱有较高期望,但实际使用后,建议结合requests库与bs4库自行开发可能更为合理。
除了上述简要介绍的功能外,它还具备一些扩展能力,如下所示:
- 结合
requests和newspaper解析网页正文,即使用requests进行爬取,newspaper作为解析器。 - 可以调用
Google Trends信息。 - 支持多任务爬取。
- 支持NPL自然语言处理。
- 甚至官方文档还提供了一个
Easter Eggs复活节彩蛋,可查阅文档底部获取。
总之,体验一言难尽。
写在后面
本打算深入玩转Python的NewSpaper爬虫框架,但看来难度较大。不过,扩展知识点也是有益的。当然,下载GitHub源码后,仔细研究大佬的编码规范,也能学到不少东西。
以上就是Python爬虫框架NewSpaper使用详解的详细内容,更多关于Python爬虫框架NewSpaper的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















