


Python字符串处理实战:错位键盘还原、单词平均长度计算与字母重排匹配详解

本文通过四个Python编程案例深入讲解字符串处理技巧。涵盖错位键盘字符映射还原、基于空格分割的单词平均长度统计、利用排序进行字母重排的高效匹配,以及Tex格式双引号状态机转换。结合C语言思路对比,提供完整代码实现与逻辑分析,适合初学者掌握字符串操作核心方法。
前言
在前一篇文章中,我们探讨了数值的多种处理方式。本文将重点转向字符串处理领域,分享几个经典且基础的编程题目,旨在记录并解析针对字符串操作的有效解决方案。
错位键盘🍓(即利用错位后的字符序列还原原始字符串)
单词的平均长度🥝(涉及字符串的分词处理)
字母重排🤑(子串与主串的匹配问题,此处的匹配思路颇具参考价值)
Tex括号问题(相对简单,下文将详细展开)。接下来,让我们正式进入今天的内容。
一、错位键盘🚩
🪐问题描述
在打字过程中,用户常因手误将相邻按键混淆,例如将A误敲为S,或将S误敲为D。
现有一位程序员因手误输入了一行字符串,请利用逻辑推理将其还原。已知标准键盘字符顺序为:"`1234567890-=QWERTYUIOP[]\ASDFGHJKL;'ZXCVBNM,./"。
样例输入:
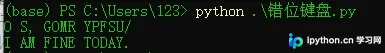
O S, GOMR YPFSU/
样例输出:
I AM FINE TODAY
🪐问题分析
此类问题的直观解法是字符替换,但鉴于键盘字符众多,逐个替换效率低下。更优策略是构建一个下标映射数组,记录每个字符在标准字符串中的位置。为避免复杂的类型转换,可将该数组大小设为255,使得字符的ASCII值直接作为数组下标,从而快速获取其在原字符串中的索引。
根据输入特征,字符串中包含空格,而标准键盘定义中不含空格,因此需进行分词处理。在Python中,分词操作极为简便;若使用C语言,可开辟字符指针数组存储各单词片段,处理逻辑与计算单词平均长度类似。完成分词后,遍历字符指针数组,按序列输出。输出时,先以字符为下标获取其在映射数组中的索引,再将该索引减1后作为下标从标准字符串中取出对应字符。需注意输出格式的控制。
🪐代码实现
按照惯例,先展示运行结果:
代码如下:
import sys
s=sys.stdin.readline().strip().split()
indexarr=[0]*255
# 将所有数据存放进一个数组,将键盘上相邻的两个字母在数组中以索引的形式相连
mystr="`1234567890-=QWERTYUIOP[]\\ASDFGHJKL;'ZXCVBNM,./"
# 将每一位字母的索引存储起来。供以后遍历输入的数据使用
for i in range(len(mystr)):
    indexarr[ord(mystr[i])]=i

flag=True
#遍历输入的n段字符串
for line in s:
    if flag:
        flag=False
        for i in line:
            print(mystr[indexarr[ord(i)]-1],end="")
    else:
        print(" ",end="")
        for i in line:
            print(mystr[indexarr[ord(i)]-1],end="")
二、单词的平均长度🚩
此题在Python中实现非常简洁。若使用C语言,需先统计空格数量:若空格后紧跟非空格字符,则单词计数加1;若后续仍为空格则继续遍历,直到遇到非空格字符时字母计数加1。最终需将单词数额外加1,因为在循环统计中首尾单词可能仅被统计了一次。
🪐问题描述
输入包含若干个单词,单词仅由字母组成,且单词之间由一个或多个空格分隔。
输出所有单词的平均长度。
样例输入:
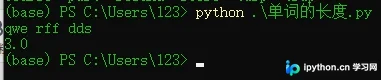
qwe qwe qwe
样例输出:
3.0
🪐问题分析
首先对字符串进行分词处理,计算每个子串的长度,将所有长度求和后除以单词总数,即可得到平均长度。
🪐代码实现
按照惯例,先展示运行结果:
代码如下:
import sys
num=0
n=0
# 这里使用strip()去除输入的末尾换行符
# 使用split()进行字符串分段最后得到的是一个列表形式
mystr=sys.stdin.readline().strip().split()

for i in mystr:
    num+=len(i)
    n+=1
print(num/n)
三、字母重排🚩
🪐问题描述
输入一个字典(以*****结尾),随后输入若干待查询单词。对于每个输入的单词w,需在字典中找出所有可由w的字母重排得到的单词,并按字典序从小到大在一行内输出(若未找到,则输出0)。输入单词间以空格或空行分隔,且所有输入单词均由不超过6个小写字母组成。注意,字典中的单词未必按字典序排列。
样例输入:
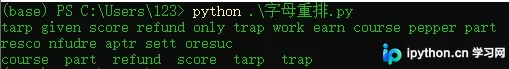
第一行 tarp given score refund only trap work earn course pepper part
第二行 resco nfudre aptr sett oresuc
样例输出:
course part refund score tarp trap
🪐问题分析
由于涉及字典查找,可预先对字典进行预处理,随后依据处理后的标准进行查词。
具体策略为:先对字典元素排序,得到首字母有序的字典序列;接着对字典中每个元素内部的字符进行排序。同时,对待查询的子串也进行内部字符排序。遍历处理后的有序字典进行比对,若待查词排序后的字符串与字典中某元素排序后的字符串一致,则直接输出原字典项(即对标准字典进行特定转换,将待查词进行相同转换后与字典比对)。
🪐代码实现
按照惯例,先展示运行结果:
代码如下:
import sys
# 元字典序字符串
mydic=list(sys.stdin.readline().strip().split())
mydic=sorted(mydic)
words=sys.stdin.readline().strip().split()
# 排序后的字符串
newdic=[]
newwords=[]
for i in mydic:
    # 字符串不可以直接排序,先转换成字典,然后进行排序
    newdic.append("".join(sorted(i)))

for i in words:
    newwords.append("".join(sorted(i)))
flag=False
i=0
while i<len(newdic):
    if newdic[i] in newwords:
        if not flag:
            print(mydic[i],end="")
            flag=True
        else:
            print(" ",mydic[i],end="")
    i+=1

if not flag:
    print(0)
四、Tex括号问题🚩
🪐问题描述
有一篇文章在撰稿时未遵循指定格式,现需将包含单引号或双引号的标点符号转换为中文双引号格式。
样例输入:
"anksdn,'dasd,"hhihi"
样例输出:
"anksdn,"dasd,"hhihi"
🪐问题分析
此问题与前述的灯光模拟逻辑类似,关键在于维护一个状态标记位。
可设计一个布尔标记flag,当flag为True时,遇到英文双引号"则输出左中文双引号“,
并立即将标记翻转为相反值;当flag为False时,遇到英文双引号"则输出右中文双引号”。
随后将flag标记重置为True,继续处理后续字符。
🪐代码实现
按照惯例,先展示运行结果:
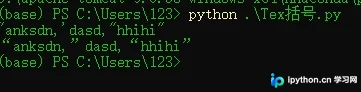
代码如下:
import sys
s=sys.stdin.readline().strip()
flag=True
for i in s:
    if i=="'" or i=="\"":
        if flag:
            print("“",end="")
        else:
            print("”",end="")
        flag=not flag
        continue
    print(i,end="")
ฅʕ•̫͡•ʔฅ
ᴴᴬᵛᴱ ᴬ ᴳᴼᴼᴰ ᵀᴵᴹᴱ🏁
至此,关于Python真题案例之错位键盘、单词长度及字母重排的详解介绍完毕。如需了解更多Python错位键盘相关内容,欢迎搜索本站历史文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















