


Java 对象实例化:new 关键字背后的内存机制解析

在 Java 开发中,new 关键字是创建对象的基础手段,但其背后的内存分配与引用传递机制往往被初学者忽视。理解堆(Heap)与栈(Stack)的交互关系,是掌握面向对象编程的关键。本文将剖析对象实例化时的内存布局,解释为何修改一个对象引用会影响另一个引用,从而澄清常见的内存误解。
核心内存模型:堆与栈的分工
要理解 new Student() 这一简单语句发生了什么,首先需要明确 Java 运行时数据区的两个核心部分:
- 堆内存 (Heap):用于存储实际的对象数据(成员变量的值)。这是通过
new关键字动态分配的空间,由垃圾回收器管理生命周期。 - 栈内存 (Stack):用于存储局部变量和方法调用信息。对于对象类型,栈中存储的并非对象本身,而是指向堆内存中对象位置的引用(Reference),通俗理解即为“钥匙”或“地址标签”。
第一步:声明与实例化的分离操作
以代码 Student student1 = new Student(); 为例,该过程在内存中分为两个紧密关联的步骤:
- 声明引用变量:
Student student1在栈内存中开辟一块空间,命名为student1,此时它尚未指向任何具体对象(默认为null)。 - 实例化对象:
new Student()在堆内存中开辟新空间,初始化对象属性,并生成唯一的内存地址。 - 建立关联: 等号
=将堆内存的地址赋值给栈中的student1。此时,student1持有指向堆中对象的“钥匙”,即可通过点语法访问或修改堆中的数据。
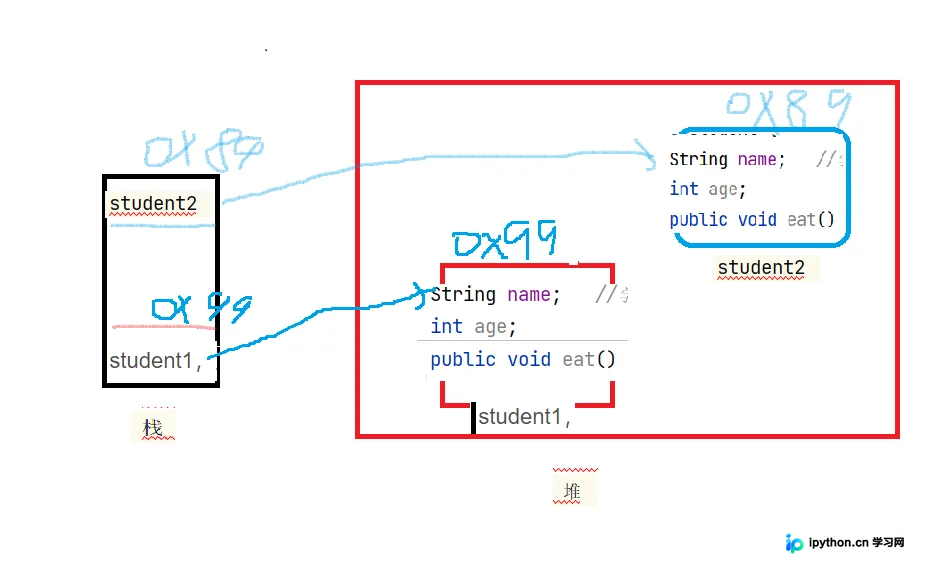
这种机制意味着,栈中的变量名只是对象的索引,真正的数据实体位于堆中。通过这把“钥匙”,程序可以在类的作用域内任意调用属性和方法。
场景一:独立对象的实例化
当分别创建多个对象时,每个对象在堆中拥有独立的内存块,栈中也存在对应的独立引用变量。它们之间互不干扰。
class Student {
    String name;
    int age;
    public void eat() {
        System.out.println(name + "在吃饭, 他" + age + "岁了");
    }
}

public class TestDemo {
    public static void main(String[] args) {
        // 创建第一个学生对象
        Student student1 = new Student();
        student1.name = "小强";
        student1.age = 18;
        student1.eat();

        // 创建第二个学生对象
        Student student2 = new Student();
        student2.name = "小红";
        student2.age = 23;
        student2.eat();
    }
}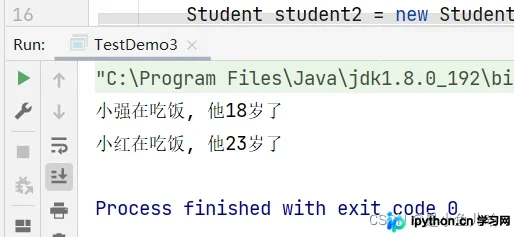
在此场景中,student1 和 student2 虽然属于同一个类,但在堆内存中是两个完全独立的实体。修改 student1 的属性不会影响 student2。
场景二:引用共享与内存覆盖
更复杂的情况出现在浅拷贝或引用赋值时。如果将一个已存在的对象引用赋值给另一个变量,两个栈变量将指向堆中的同一块内存地址。
class Dog {
    String name;
    int age;
    public void show() {
        System.out.println("姓名:" + name + "   年龄: " + age);
    }
}

public class TestDemoRef {
    public static void main(String[] args) {
        // 1. 实例化对象 one
        Dog one = new Dog();

        // 2. 引用赋值:two 获得 one 持有的堆内存地址
        Dog two = one;

        // 3. 通过 one 修改属性
        one.name = "阿黄";
        one.age = 10;

        // 4. 再次通过 two 覆盖属性
        two.name = "旺财";
        two.age = 3;

        // 输出结果验证
        one.show();
        System.out.println("========这是分割线========");
        two.show();
    }
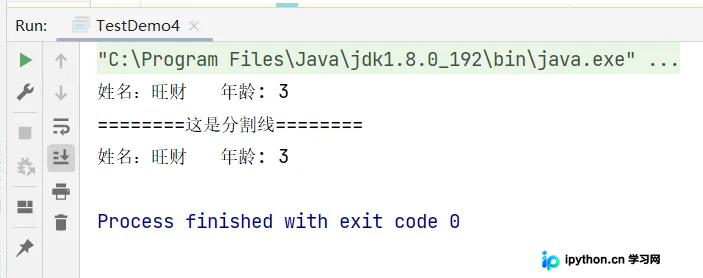
}
执行逻辑分析
上述代码的运行结果将显示 two 的输出为最后设定的值("旺财", 3岁),原因如下:
- 地址共享:
Dog two = one;并未在堆中创建新对象,而是让two栈变量指向了one所在的堆内存位置。 - 共同修改: 对
one或two的任何属性修改,实际上都是在操作同一块堆内存。 - 最后写入原则: 由于两者指向同一地址,后执行的赋值操作会覆盖先前的内容。最终堆内存中保留的是最后一次写入的数据。
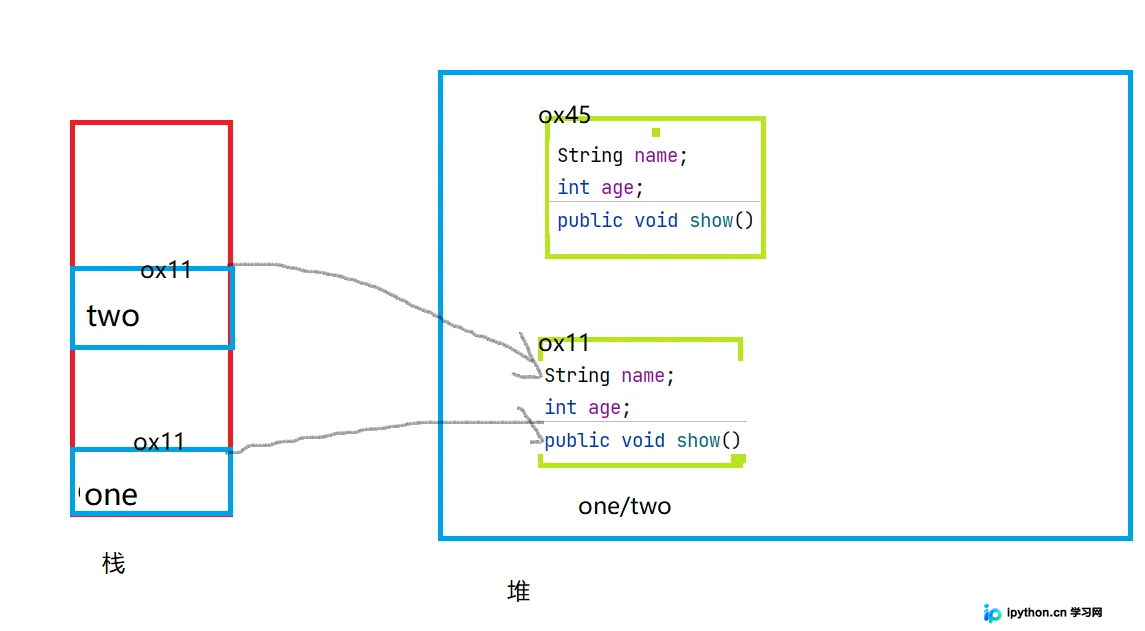
这种机制类似于夫妻共同拥有一幅画:无论谁去修改画作,最终呈现的都是最新的修改结果。在 Java 编程中,理解引用传递而非值传递,是避免意外数据污染和优化内存使用的基础。
总结
Java 的对象实例化不仅仅是代码层面的新建动作,更是 JVM 在堆栈内存间建立映射的过程。new 负责在堆中开辟空间,而赋值操作则在栈中建立指向该空间的引用链。掌握这一原理,有助于开发者更好地理解对象生命周期、防止空指针异常以及优化深层复制等高级操作。
以上就是 Java 对象实例化内存机制的详细解析,更多关于 Java 基础与 JVM 原理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















