



很多人遇到“程序跑起来就卡住”时,第一反应是 GDB 失灵了,或者 GCC 没法调试死循环。实际上,真正负责调试的是 GDB,而 GCC 只负责把足够的调试信息编进程序里。只要把编译参数、信号中断和符号表这几个关键点理顺,死循环通常都能先定位到“卡在哪”,再继续判断是变量没变、条件失真,还是优化把源码视角打乱了。
GCC 不能直接调死循环,真正工作的其实是 GDB
先说结论:GCC 本身不调试死循环,真正干活的是 GDB;但如果编译时没有带 -g,GDB 连变量名、函数名和源码行号都可能看不到。
因此,调试死循环的第一步不是直接怀疑 GDB,而是先确认可执行文件是不是按调试方式构建出来的。最基本的编译命令应当类似下面这样:
g++ -g -O0 main.cpp -o main这里两个参数都很关键:
-g:保留调试符号,方便 GDB 识别变量、函数和源码位置。-O0:关闭优化,避免内联、跳转折叠、行号漂移等现象干扰单步调试。
如果你用的是 g++ main.cpp -o main 这种默认命令,即便程序确实停在死循环里,GDB 也很可能只能给出残缺信息。
为什么 gdb ./a.out 之后一执行 run 就像“卡死”了
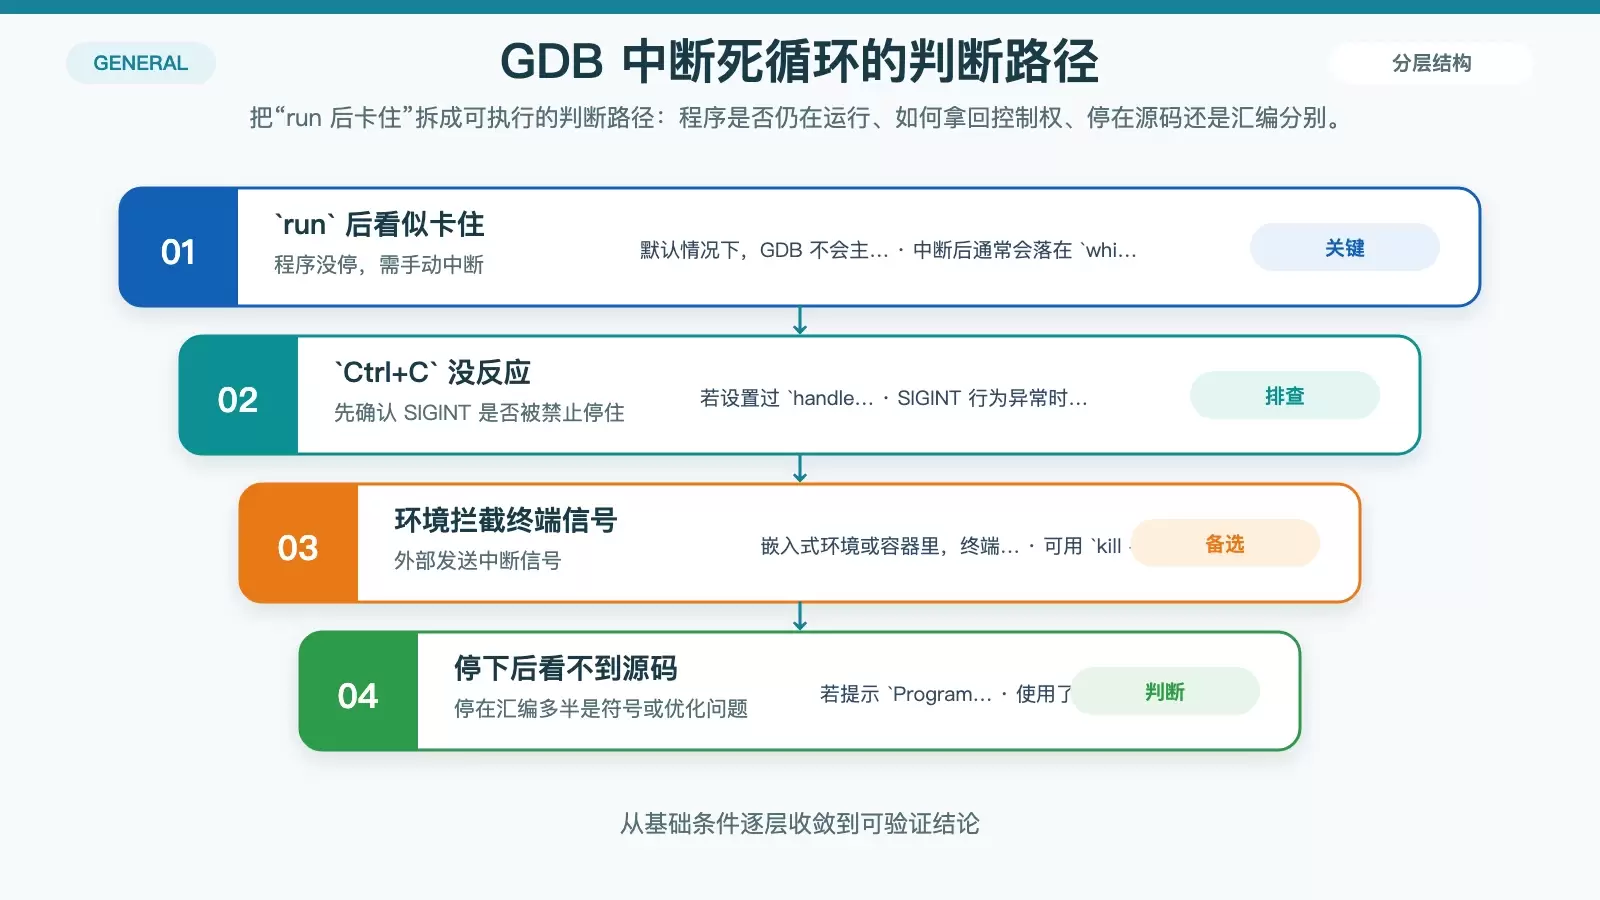
这通常不是 GDB 出问题,而是程序本身还在 CPU 上持续执行,只不过一直没有走出循环。GDB 默认不会主动打断正在运行的程序,所以你看到的“卡住”,本质上是程序还在空转。
正确做法是手动中断执行:
Ctrl+C按下后,控制权会回到 GDB。此时 GDB 通常会停在死循环当前执行的位置,例如 while(1)、for(;;) 对应的循环体附近。
如果 Ctrl+C 没有效果,重点检查这几种情况:
- 是否设置过
handle SIGINT nostop noprint。如果设置过,可重置为:handle SIGINT stop print - 某些嵌入式环境或容器里,
Ctrl+C可能被拦截。这时可以从外部发送中断信号:kill -INT $(pidof a.out) - 如果 GDB 已经显示
Program received signal SIGINT, Interrupt.,但停在汇编而不是 C/C++ 源码行,通常说明程序没有带-g,或者优化级别过高,比如用了-O2。
出现 backtrace 全是 ??,先查调试符号有没有丢
如果你执行 backtrace 后看到一串类似下面的结果:
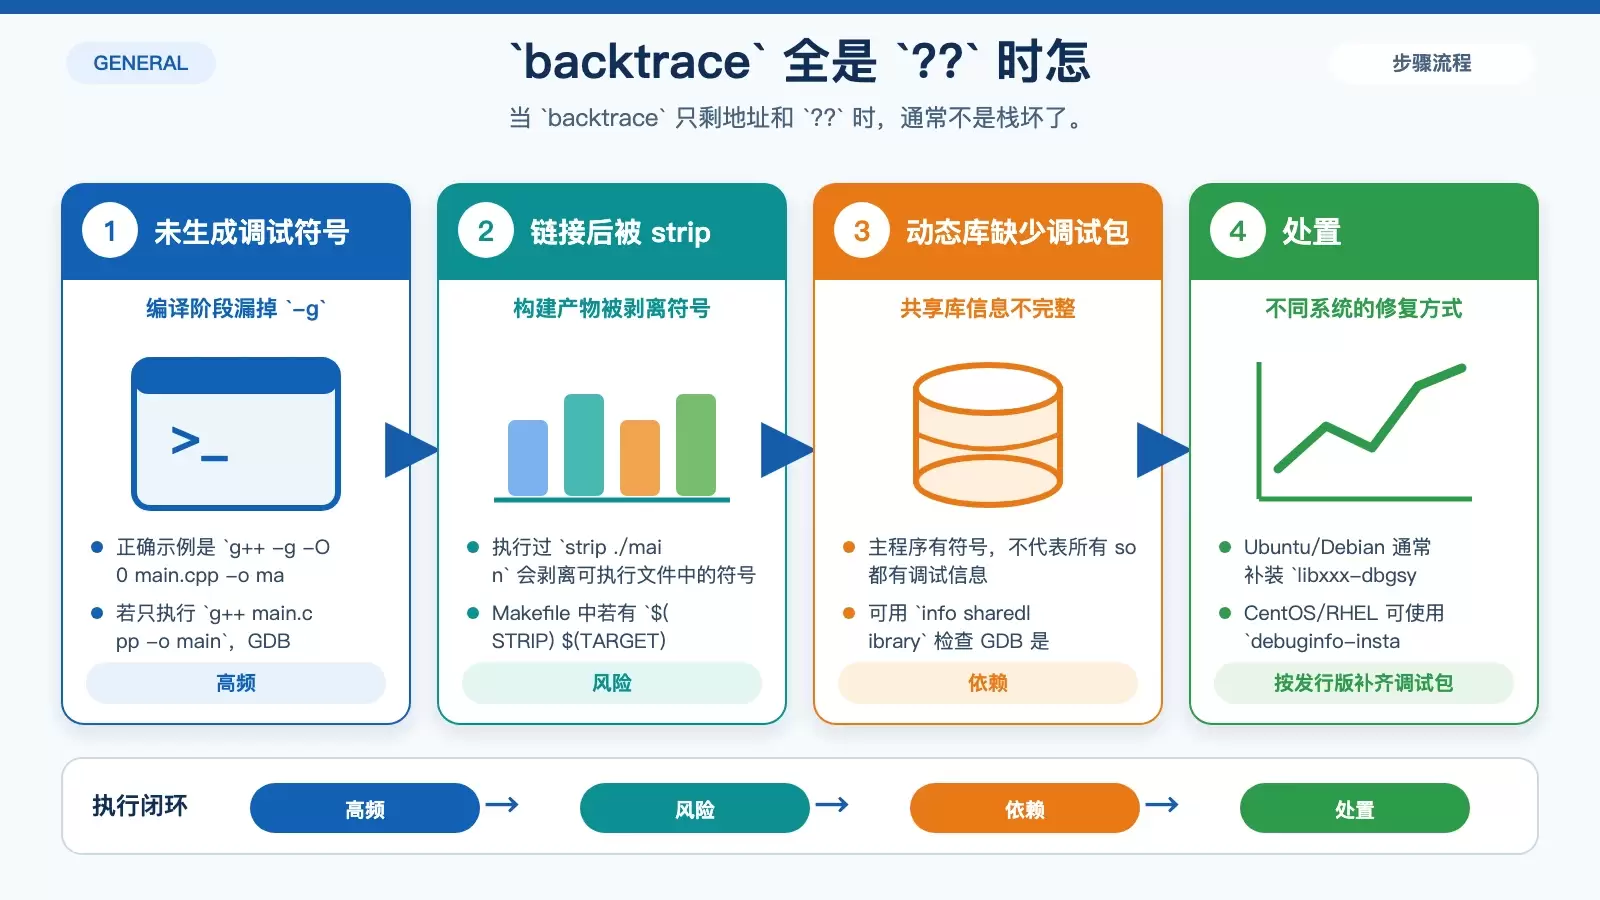
#0 0x... in ?? ()这基本就是符号表缺失的典型表现。GDB 认不出函数名,也拼不出完整调用栈,常见原因主要有三类。
1. 编译时漏了 -g
先回头检查编译命令,确认你实际执行的是:
g++ -g -O0 main.cpp -o main而不是:
g++ main.cpp -o main2. 链接后被 strip 过
有些构建流程会在生成可执行文件后剥离符号,这会直接让 GDB 失去可读信息。需要检查是否做过类似操作:
strip ./main如果是通过 Makefile 构建,也要留意是否存在这类语句:
$(STRIP) $(TARGET)3. 动态库没有加载对应调试信息
当问题发生在共享库内部时,即便主程序带了调试符号,也可能依旧看不到完整栈信息。可以在 GDB 里先检查共享库识别情况:
info sharedlibrary如果缺失相关调试信息,按发行版补装:
- Ubuntu/Debian:安装对应的
libxxx-dbgsym包 - CentOS/RHEL:使用
debuginfo-install
死循环里到底是谁卡住了,别只盯着循环变量
很多人排查死循环时,第一反应是 print i 看循环变量。但实际问题经常不在这个变量本身。程序可能是在等待硬件标志位,可能阻塞在 read(),也可能因为指针越界把旁边变量改坏了。
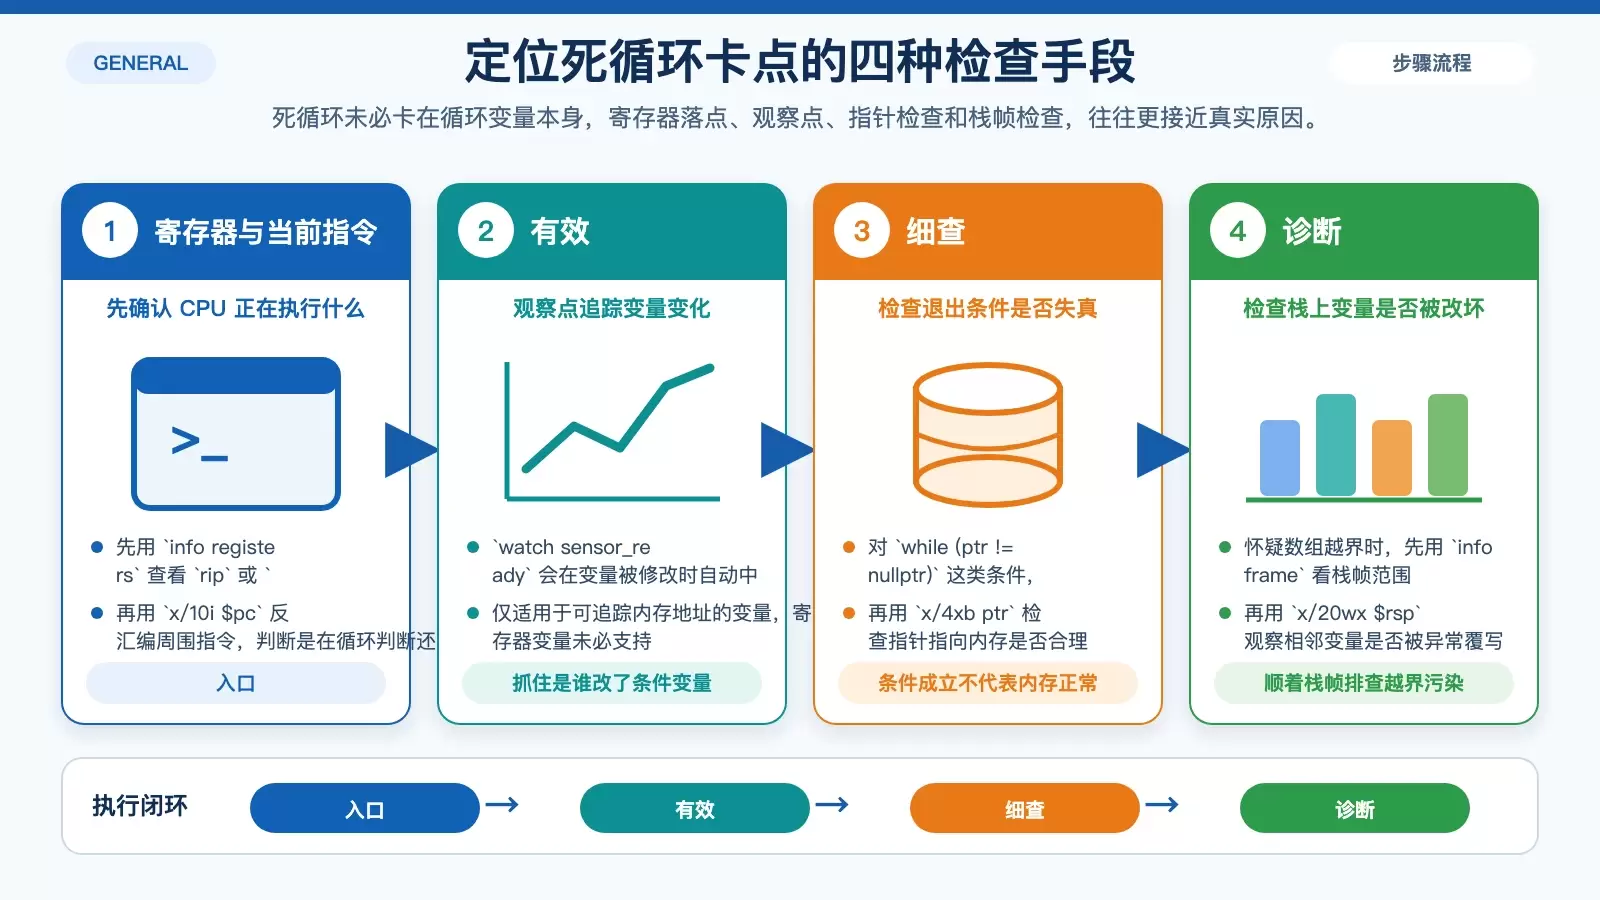
更稳妥的定位方法,是按下面这条线索往下查。
先看当前指令落点
程序停住后,先确认 CPU 当前到底在执行什么:
info registers重点看 rip(x86_64)或 pc(ARM)。然后围绕当前位置反汇编:
x/10i $pc这样可以先判断程序是在循环判断里空转,还是卡在某条等待、跳转或内存访问指令上。
对可疑条件变量设观察点
如果怀疑某个变量本该改变却一直没变,可以直接设置观察点:
watch sensor_ready一旦该变量被修改,GDB 会自动中断。这比反复 print 更适合排查“谁在改、什么时候改”。不过要注意,观察点只适用于能追踪内存地址的变量,局部寄存器变量不一定能用。
检查循环退出条件是否已经失真
如果循环条件本身依赖指针或外部状态,就不能只看语法表面。例如:
while (ptr != nullptr)这时应先看指针值:
print ptr再检查它指向的内存是否合理:
x/4xb ptr这样能更快判断是条件真的一直成立,还是指针已经指向异常区域。
怀疑越界改写时,顺着栈帧往外看
如果你怀疑数组越界、栈内存污染把循环相关变量覆写了,可以先查看当前栈帧范围:
info frame再直接检查栈上邻近内容:
x/20wx $rsp这类方法在“变量本来应该变化,但值莫名异常”时尤其有用。
为什么 step 进不去,next 却一下跳过去
这通常不是操作失误,而是编译器优化已经把函数内联了。函数一旦被展开成调用点附近的指令块,GDB 就没有办法再按照源码层面的“函数边界”去单步进入,所以 step 看起来像失效,next 也可能直接越过整段逻辑。
遇到这种情况,处理方式基本只有两种:
- 重新编译,加入
-O0,尽量保留原始调用结构。 - 接受当前二进制形态,改用汇编视角排查:
重点关注disassemblecmp、je、jne这类条件判断和跳转指令。
还有一个很容易误判的细节:在 Release 版本里,while(1) 很可能会被优化成类似 jmp .L2 的纯跳转指令。结果是 GDB 里的“当前行”可能长时间停在循环起始处,看起来像程序完全没动。此时不要过度依赖单步执行,watch 和 info registers 往往更可靠。
一条更实用的判断顺序
如果你只想尽快判断问题出在哪,可以按这个顺序执行:
- 先确认是否用
-g -O0重新编译。 - 进入 GDB 后执行
run,如果程序一直跑,就用Ctrl+C中断。 - 若停在汇编层,优先怀疑缺少调试符号或优化过高。
- 执行
backtrace,如果全是??,就回头检查-g、strip和动态库调试信息。 - 定位死循环原因时,不要只看循环变量,优先结合
info registers、x/10i $pc和watch判断程序真正卡在哪个条件上。
把这几步走顺,死循环问题通常就能从“程序卡住了”缩小到“符号缺失、优化干扰,还是某个条件永远不成立”这一级别,后面的修复才有依据。















