


SQL Server 分区表创建、分割与合并实战指南

在 SQL Server 企业版或开发版中,分区表通过将逻辑上的一个大表在物理上拆分为多个部分,存储于不同的磁盘或文件组中,从而提升大数据量下的查询效率并便于维护。本文将详细讲解如何利用分区函数(Partition Function)和分区构架(Partition Scheme)创建分区表,以及如何执行后续的分区分割与合并操作。
为什么选择表分区
在理解具体操作前,需明确分区的主要价值:
- 性能提升:将表分布到不同的硬盘或存储介质,可并行访问不同分区的数据,显著提高大型数据集的查询速度。
- 稳定性增强:某个分区出现故障时,仅影响该分区数据,其他分区仍可使用。
- 便于管理:针对超大型表,可按分区单独进行备份、恢复或索引重建,无需锁定整个表。
- 历史存档:将不常用的旧数据移至专门的文件组或服务器,保持活跃数据的高效性。
分区表核心概念
分区表在逻辑上表现为单张表,但在物理层面由多部分组成。用户使用时与普通表无异,无需关心底层的数据分布细节。
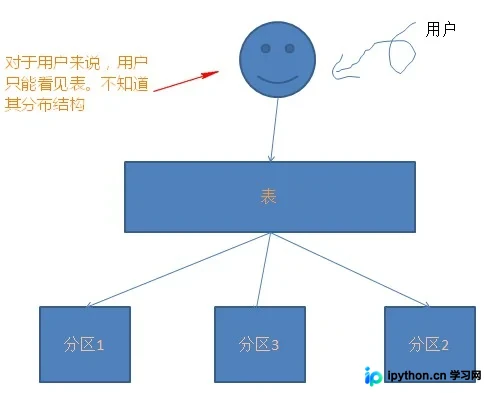
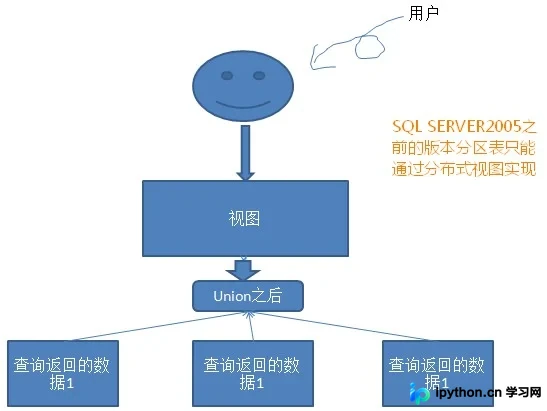
值得注意的是,早期 SQL Server 版本(2005之前)缺乏原生分区支持,所谓的“分区”往往是通过分布式视图(Union多个表)实现的。而现代分区机制是底层文件系统层面的隔离。
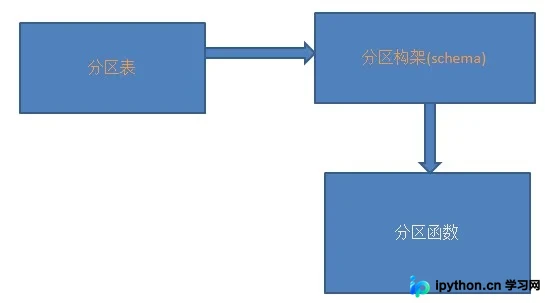
依赖关系:函数 → 构架 → 表
构建分区表涉及三个关键组件,它们之间存在严格的依赖链:
- 分区函数 (Partition Function):决定数据行根据什么条件被划分到哪个逻辑分区。它定义了边界值,但不指定数据存放的物理位置。
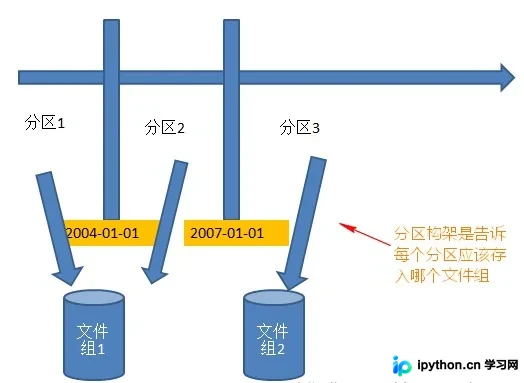
- 分区构架 (Partition Scheme):基于分区函数,将具体的逻辑分区映射到实际的
FILEGROUP(文件组)。即规定每个分区存在哪个硬盘/文件组上。 - 分区表 (Partition Table):最终创建的表对象,应用分区构架来决定其存储方式。
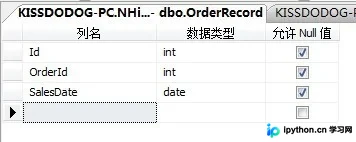
下文将以一个包含销售日期列的订单表为例,演示完整流程。
第一步:定义分区函数
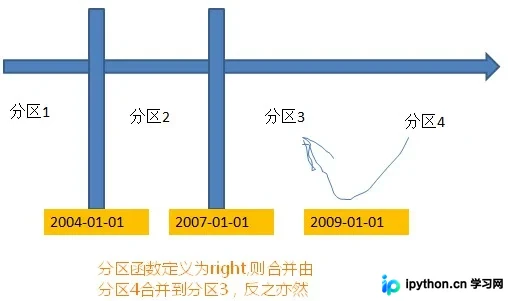
分区函数决定了数据的逻辑切割点。例如,按 SalesDate 字段划分,若设定两个边界值 '2004-01-01' 和 '2007-01-01',则数据会被分为三个逻辑区间。
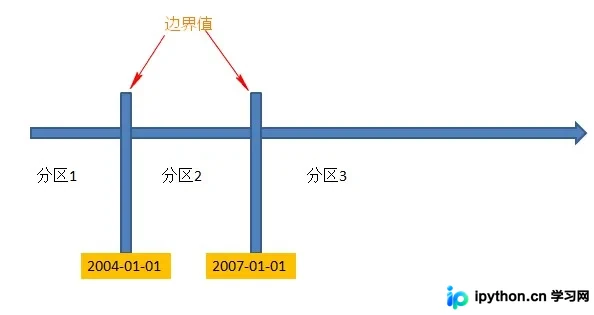
语法原型如下:
CREATE PARTITION FUNCTION partition_function_name ( input_parameter_type )
AS RANGE [ LEFT | RIGHT ]
FOR VALUES ( [ boundary_value [ ,...n ] ] )
其中 RANGE LEFT | RIGHT 用于界定等于边界值的数据归入左侧还是右侧分区。在实际操作中,我们先创建一个简单的分区函数:
-- 创建分区函数,以 DATE 类型为依据,RIGHT 表示边界值归入右区
CREATE PARTITION FUNCTION fnPartition(DATE)
   AS RANGE RIGHT
   FOR VALUES('2004-01-01','2007-01-01');

-- 验证创建成功
SELECT * FROM sys.partition_functions;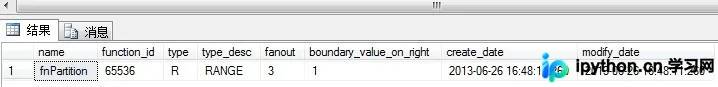
第二步:定义分区构架
有了函数,还需指定数据存放在哪里。分区构架将函数定义的逻辑分区一一映射到 FILEGROUP。假设有两个边界值产生三个分区,则需要提供三个文件组。
-- 创建分区构架,将 fnPartition 的三个分区分别映射到 FileGroup1, PRIMARY, FileGroup1
CREATE PARTITION SCHEME SchemaForParirion
	AS PARTITION fnPartition
	TO(FileGroup1,[primary],FileGroup1);

-- 验证构造方案
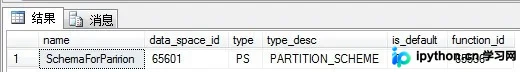
SELECT * FROM sys.partition_schemes;
第三步:创建分区表
当分区构架建立完毕后,即可在建表时应用它。**注意:只有在建表语句中指定 ON 架构名(分区列) 才能直接生成分区表,已存在的普通表无法后期直接转换为分区表。**
CREATE TABLE OrderRecords
    (
        Id int,
        OrderId int,
        SalesDate Date
    )
    ON SchemaForParirion(SalesDate); -- 指定应用上述构架,按 SalesDate 列分区
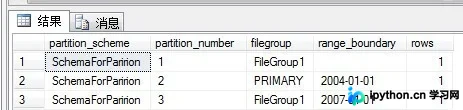
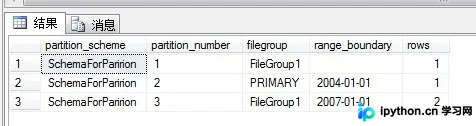
插入几条测试数据后,可以通过系统视图查看数据是否真实落入不同分区:
select convert(varchar(50), ps.name)                  as partition_scheme,
       p.partition_number,
       convert(varchar(10), ds2.name)                 as filegroup,
       convert(varchar(19), isnull(v.value, ''), 120) as range_boundary,
       str(p.rows, 9)                                 as rows
from   sys.indexes i
       join sys.partition_schemes ps on i.data_space_id = ps.data_space_id
       join sys.destination_data_spaces dds on ps.data_space_id = dds.partition_scheme_id
       join sys.data_spaces ds2 on dds.destination_id = ds2.data_space_id
       join sys.partitions p on dds.destination_id = p.partition_number and p.object_id = i.object_id
       join sys.partition_functions pf on ps.function_id = pf.function_id
       left join sys.partition_range_values v on pf.function_id = v.function_id and v.boundary_id = p.partition_number - pf.boundary_value_on_right
where  i.object_id = object_id('OrderRecords') and i.index_id in ( 0, 1 );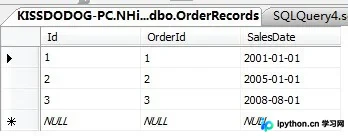
分割与合并分区
随着业务发展,可能需要新增时间点的数据区间(分割),或者清理旧数据(合并归档)。
1. 分割 (Split) 现有分区
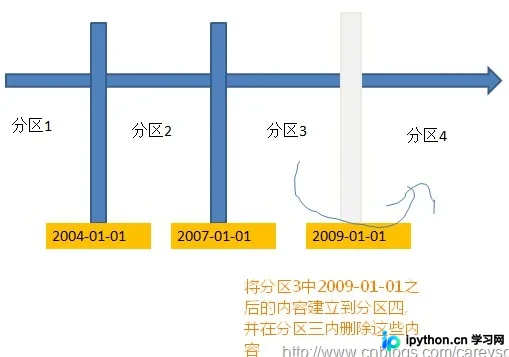
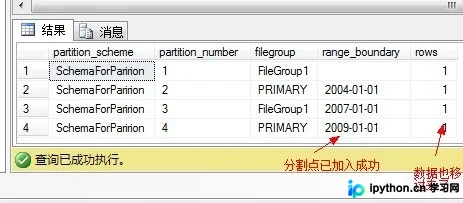
例如,我们要在 '2009-01-01' 增加一个新的切分点。这需要两步操作:
首先,告知系统新产生的第4个分区应放在哪个文件组(通常是 NEXT USED):
-- 指定新分区使用的文件组为 PRIMARY
ALTER PARTITION SCHEME SchemaForParirion
    NEXT USED 'PRIMARY';
随后,执行分割动作:
-- 添加新的分割点
ALTER PARTITION FUNCTION fnPartition()
    SPLIT RANGE('2009-01-01');
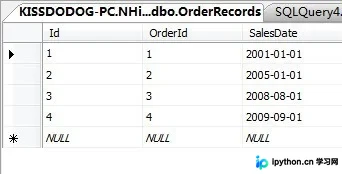
分割完成后,数据将被重新分布。若原分区内有数据横跨新旧边界,SQL Server 会将这部分数据复制到新分区并标记旧分区相应记录删除。
风险提示:如果源分区数据量巨大,分割操作会消耗大量 I/O 并生成分区数据的日志副本(约为数据量的数倍)。在业务高峰期应谨慎操作,避免阻塞读取。
2. 合并 (Merge) 相邻分区
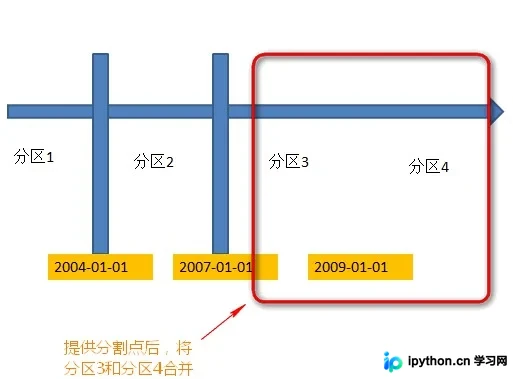
合并是将相邻的两个逻辑区间合二为一。这需要先知道分割点,且该分割点必须存在。比如合并掉刚才建立的 '2009-01-01':
ALTER PARTITION FUNCTION fnPartition()
    MERGE RANGE('2009-01-01');
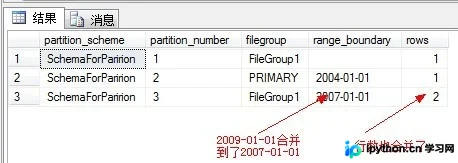
合并后,数据将回到同一片区中。至于数据最后留在原来的左分区还是右分区,完全取决于当初创建函数时的 LEFT 或 RIGHT 设置。
总结
合理运用分区表技术能有效应对海量数据带来的性能瓶颈。规划时应提前考虑未来的增长趋势,尽量一次设定好足够的边界值,以减少后期的分割频率和维护开销。以上就是 SQL Server 分区表从创建到维护的详细内容,更多关于数据库管理的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















