


Python Pandas处理CSV文件的核心技巧与可视化

面对含中文标注的CSV文件,直接读取常因编码冲突报错。通过正确配置Pandas读取参数、使用布尔索引筛选、迭代处理数据行,并衔接Matplotlib进行频次统计与直方图渲染,可形成稳定高效的数据清洗与分析闭环。
基础读取与数据概览
处理CSV的第一步是安全载入数据并确认内部结构。Pandas默认采用UTF-8解码,遇到GB2312等中文字符集时会抛出`UnicodeDecodeError`。显式声明编码或使用转义容错模式即可规避此问题。
第1步:配置编码参数读取CSV文件
目的:避免中文解析失败,获取完整的表头与类型信息。
入口:安装并导入`pandas`库。
动作:调用`read_csv`并传入`encoding`参数。
import pandas as pd

df = pd.read_csv("data.csv", encoding="GB2312")
# 备选方案:忽略编码错误
# df = pd.read_csv("data.csv", encoding="unicode_escape")

print(df.info())
重要参数:`encoding`(字符串编码格式)、`sep`(分隔符,默认逗号)。
完成状态:控制台输出包含行数、列名、Non-Null Count、Dtype及内存占用的结构报告,证明DataFrame已成功构建。
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 3840 entries, 0 to 3839
Data columns (total 16 columns):
# Column Non-Null Count Dtype
-- ------ -------------- ----- 0 实验时间批次 3840 non-null object
1 物镜倍数 3840 non-null object
7 孔拍摄位置 3840 non-null int64
dtypes: float64(1), int64(5), object(10)
memory usage: 480.1+ KB
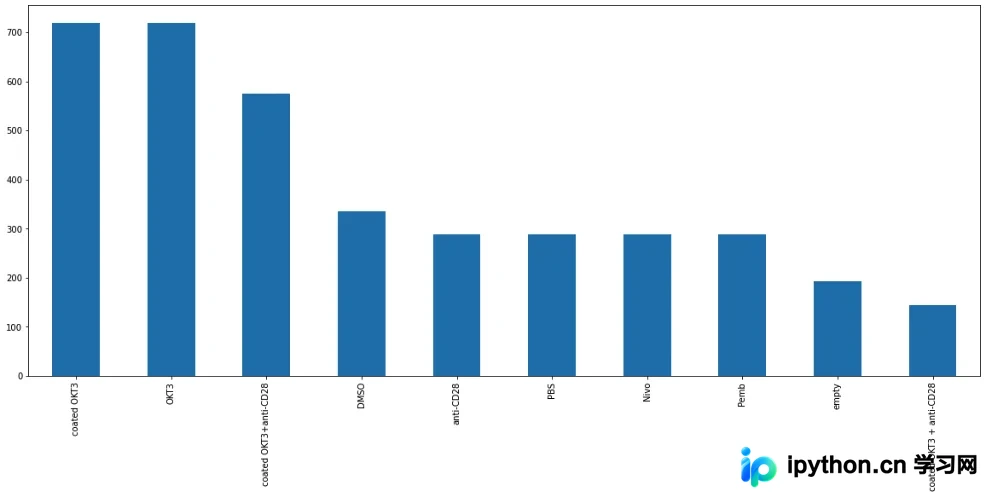
第2步:统计指定列的频次分布
目的:快速查看分类变量的样本比例,评估数据均衡性。
入口:已加载的DataFrame对象。
动作:对目标列执行`.value_counts()`,并将结果链式调用至绘图函数。
import matplotlib.pyplot as plt

# 取消notebook环境的图形内联限制(脚本运行无需此行)
# %matplotlib inline

plt.close("all")
plt.figure(figsize=(20, 8))
df["扰动类别"].value_counts().plot(kind="bar")
plt.xticks(rotation='vertical', fontsize=10)
plt.show()
第3步:按条件筛选目标数据集
目的:隔离特定样本进行独立分析或导出,减少冗余计算。
入口:原始DataFrame。
动作:构造布尔表达式并使用`.loc[]`进行切片赋值。
# 筛选板子编号为plate1的记录
df_plate1 = df.loc[df["板子编号"] == "plate1"]
print(df_plate1.info())

# 按需保存为新文件
# df_plate1.to_csv("subset_plate1.csv", index=False)
重要参数:左侧重布尔Series需与右侧DataFrame严格对齐索引。
完成状态:行数由3840降至1280,所有列的Non-Null Count同步缩减,表明切片精准生效。
第4步:逐行遍历并映射外部资源
目的:将CSV中的元数据转换为实际文件路径,执行批量图像读取等操作。
入口:过滤后的DataFrame。
动作:使用`.iterrows()`迭代,提取字段拼接路径后调用底层图像处理库。
for idx, row in df_plate1.iterrows():
    img_name = row["图名称"]
    # 模拟路径格式化逻辑
    img_ch_format = f"{img_name}_ch{{}}_{}.tif"
    for i in range(1, 7):
        img_path = os.path.join("/target_folder", img_ch_format.format(i))
        img = cv2.imread(img_path)
        print(f'[Info] img shape: {img.shape}')
    break  # 单行测试验证后即可移除
完成状态:终端连续打印6次相同的图像形状元组(如`(1080, 1080, 3)`),证明路径拼接与读取链路畅通。
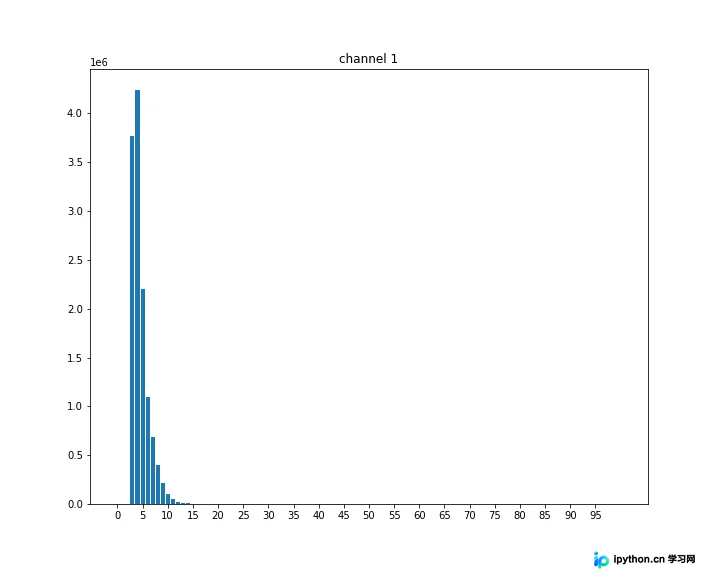
第5步:计算像素分布并渲染直方图
目的:在CSV记录对应图像的灰度值基础上,统计像素强度区间占比。
入口:已读取的单通道灰度矩阵。
动作:剔除背景噪声阈值,划分256级灰度桶计数,映射为字典后调用条形绘制。
import numpy as np
import cv2
import collections

# 估算并过滤背景色
pix_bkg = np.argmax(np.bincount(img_gray.ravel()))
img_clean = np.where(img_gray <= pix_bkg + 2, 0, img_gray).astype(np.uint8)

# 统计256级灰度频次
counts = cv2.calcHist([img_clean], [0], None, [256], [0, 256]).ravel()
hist_dict = collections.defaultdict(int)
for val, freq in enumerate(counts):
    hist_dict[val] += int(freq)

hist_dict[0] = 0  # 屏蔽背景零值干扰

fig, ax = plt.subplots(1, 1, figsize=(10, 8), facecolor='white')
ax.set_title('channel {}'.format(1))
n_bins = 100
ax.bar(range(n_bins + 1), [hist_dict.get(xtick, 0) for xtick in range(n_bins + 1)])
ax.set_xticks(range(0, n_bins, 5))

plt.savefig("distribution.png", dpi=150)
plt.show()
典型异常排查
在进行行列筛选或合并操作时,若左侧布尔条件的索引范围与右侧DataFrame不一致,会触发`Unalignable boolean Series`错误。修复方法是确保筛选源与目标共享相同索引,或在切片后使用`.reset_index(drop=True)`重置索引空间。
总结
掌握正确的编码声明、布尔索引切分与迭代映射,能够显著降低CSV数据预处理阶段的试错成本。配合Matplotlib完成的基础统计图,可为后续特征工程提供直观的分布依据。以上就是Python Pandas处理CSV文件核心技巧的详细内容,更多关于数据分析与可视化排错资料的关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















