


探究C#访问null对象字段抛出异常的底层原理

在C#开发中,尝试访问null对象的非静态成员(如字段或方法)总会抛出NullReferenceException。这一现象的根本原因不仅在于CLR的运行机制,更与底层JIT编译器的优化策略及操作系统虚拟内存布局密切相关。本文将深入汇编层级,解析为何小偏移量的字段访问会直接导致异常。
结果与目标:理解NullReferenceException的触发机制
当我们编写如下代码时,程序会在运行时立即崩溃:
namespace ConsoleApp2
{
    internal class Program
    {
        static Person person = null;

        static void Main(string[] args)
        {
            var age = person.age; // 此处抛出异常

            Console.WriteLine(age);
        }
    }

    public class Person
    {
        public int age;
    }
}
虽然错误提示很简单,但其背后的执行过程涉及从高级语言到机器指令的转化。要彻底理解它,我们需要观察编译器生成的汇编代码以及CPU如何解释这些指令。
准备条件:使用Visual Studio进行反汇编分析
我们可以通过Visual Studio的反汇编窗口来观察var age = person.age;这行代码在编译后的真实面目。在调试模式下设置断点,打开“反汇编”窗口,可以看到以下核心指令序列:
---------------- var age = person.age; ----------------
081D6154 mov ecx,dword ptr ds:[4C41F4Ch]
081D615A mov ecx,dword ptr [ecx+4]
081D615D mov dword ptr [ebp-3Ch],ecx
这三条指令的逻辑如下:
mov ecx,dword ptr ds:[4C41F4Ch]:从内存地址4C41F4Ch中取出person对象的引用值加载到寄存器ecx中。mov ecx,dword ptr [ecx+4]:计算age字段的内存地址。由于对象引用本身占4字节,age紧随其后,因此偏移量为+4。该指令试图从ecx+4的地址读取整数数据。mov dword ptr [ebp-3Ch],ecx将读取到的值存入局部变量栈位置。
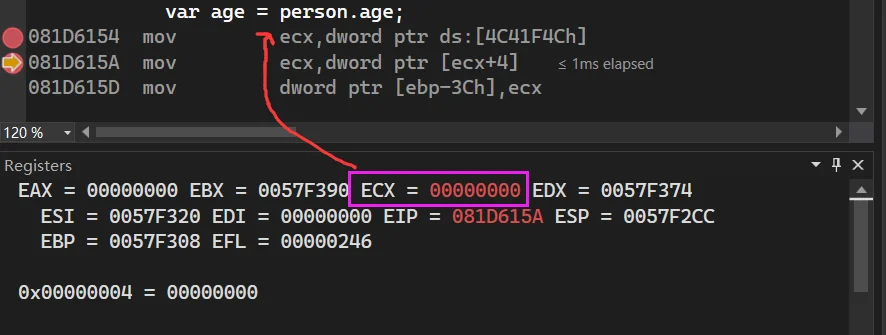
由于person为null,第一步读取到的值为0,即ecx=0x00000000。此时,第二条指令变为:mov ecx,dword ptr [00000000+4],即读取[00000004]处的内存数据。
在Windows及其他现代操作系统的虚拟内存管理中,进程的低地址空间(通常为0x00000000到0x0000FFFF)被标记为“空指针禁入区”(No-access page)。任何试图读取、写入或执行该区域内存的操作,都会由CPU硬件触发一个访问违例(Access Violation),进而转换为CLR层的NullReferenceException。
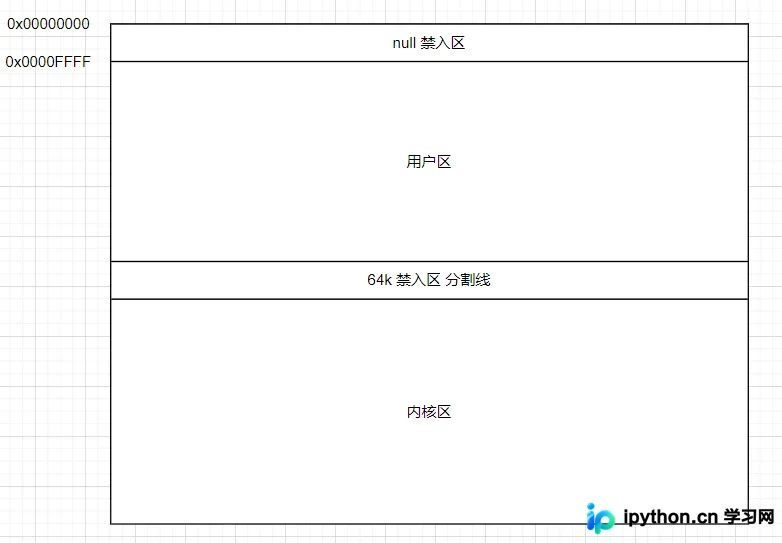
真实操作顺序:验证JIT编译器的边界检测策略
既然+4的偏移落在禁入区会导致异常,那么如果我们定义大量字段,使目标字段的偏移量远远超出FFFF界限,是否就能绕过这个检查并成功访问呢?让我们通过实验来验证。
第1步:生成包含大量字段的测试类
为了构造极端的偏移量,我们动态生成一个包含数万个字段的Person类。首先尝试生成10万个字段:
namespace ConsoleApp2
{
    internal class Program
    {
        static Person person = null;

        static void Main(string[] args)
        {
            // 动态生成代码
            var str = @"public class Person
                        {
                            {0}
                        }";

            var lines = Enumerable.Range(0, 100000).Select(m => $"public int age{m};");
            var fields = string.Join("\n", lines);
            var txt = str.Replace("{0}", fields);

            File.WriteAllText("Person.cs", txt);
            Console.WriteLine("person.cs 生成完毕");
        }
    }
}
当尝试编译此类时,CLR的类型加载器(ClassLoader)因无法处理过大的元数据而崩溃。我们将数量级调整为20000个字段重新编译,并再次查看访问最后一个字段age19999时的汇编代码:
internal class Program
{
    static Person person = null;

    static void Main(string[] args)
    {
        var age = person.age19999; // 偏移量巨大

        Console.WriteLine(age);
    }
}
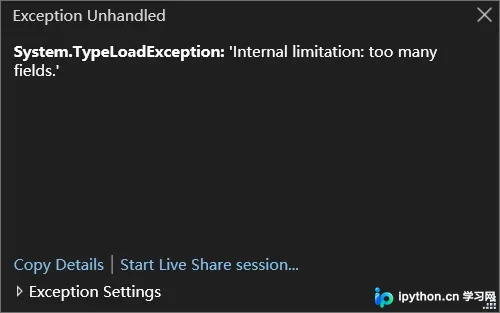
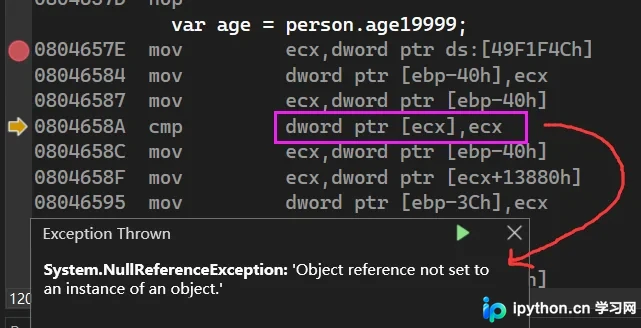
对应的反汇编代码发生了显著变化:
------------- var age = person.age19999; -------------
0804657E mov ecx,dword ptr ds:[49F1F4Ch]
08046584 mov dword ptr [ebp-40h],ecx
08046587 mov ecx,dword ptr [ebp-40h]
0804658A cmp dword ptr [ecx],ecx
0804658C mov ecx,dword ptr [ebp-40h]
0804658F mov ecx,dword ptr [ecx+13880h]
08046595 mov dword ptr [ebp-3Ch],ecx
注意关键的第4行:cmp dword ptr [ecx],ecx。这是一条经典的空指针检查指令。它试图读取ecx(即对象引用)指向的内存,如果ecx为0,则会触发异常。
完成判断与原理总结
通过对比两种情况,我们可以得出JIT编译器在生成访问字段代码时的决策逻辑:
- 小偏移量优化:当字段偏移量较小(通常在
0~FFFF范围内)时,JIT编译器认为直接读取[ecx+offset]必然落入空指针禁入区。为了减少指令数量、提升执行效率,JIT选择不生成显式的空值检查代码,而是直接发出取指指令。这正是NullReferenceException产生的瞬间原因——硬件拦截了非法内存访问。 - 大偏移量保护:当偏移量很大,可能指向合法内存地址时,JIT编译器无法确定该地址一定有效,因此必须生成完整的检查逻辑(如
cmp指令),以确保在访问前验证对象引用是否为null。
这种设计体现了JIT编译器在保证安全前提下的极致优化:对于最常见的浅层成员访问,通过利用操作系统的内存保护机制来隐式完成安全检查,而非显式编码。
以上就是探究C#访问null对象字段抛出异常详细内容的介绍,更多关于C#底层原理与JIT优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















