


C++ 单链表实现:创建、插入、删除与排序详解

掌握单链表是理解复杂数据结构的基础。本文将演示如何通过 C++ 代码实现单链表的增删改查及排序,详细解析头插法、尾插法构建逻辑以及带/不带头结点的差异。
不带头结点的单链表实现
在实际开发或面试中,有时需要处理不带头结点的链表,这意味着头指针直接指向第一个存储数据的节点。这种实现方式在插入或删除首节点时,需要特别注意修改头指针的指向。
第1步:结构体定义与内存分配
首先定义链表节点的结构体 node,包含整型数据域和指向下一节点的指针。typedef struct node node, *list; 语句简化了类型声明,其中 node 代表结构体本身,list 代表指向结构的指针。
第2步:使用尾插法创建链表
为了保持输入顺序与链表顺序一致,通常采用尾插法。程序会循环读取用户输入的数字,直到输入 0 为止。每次读取非零值后,动态分配一个新节点,并将其链接到当前链表的尾部。需要注意 head 变量在创建过程中的特殊处理,最终返回指向第一个有效数据的头指针。
第3步:节点插入逻辑
插入操作分为三种情况:头部插入、中间插入和尾部插入。
- 头部插入:当新节点的值小于等于当前第一个节点时,更新
head指针指向新节点,新节点指向原首节点。 - 中间插入:利用三个指针
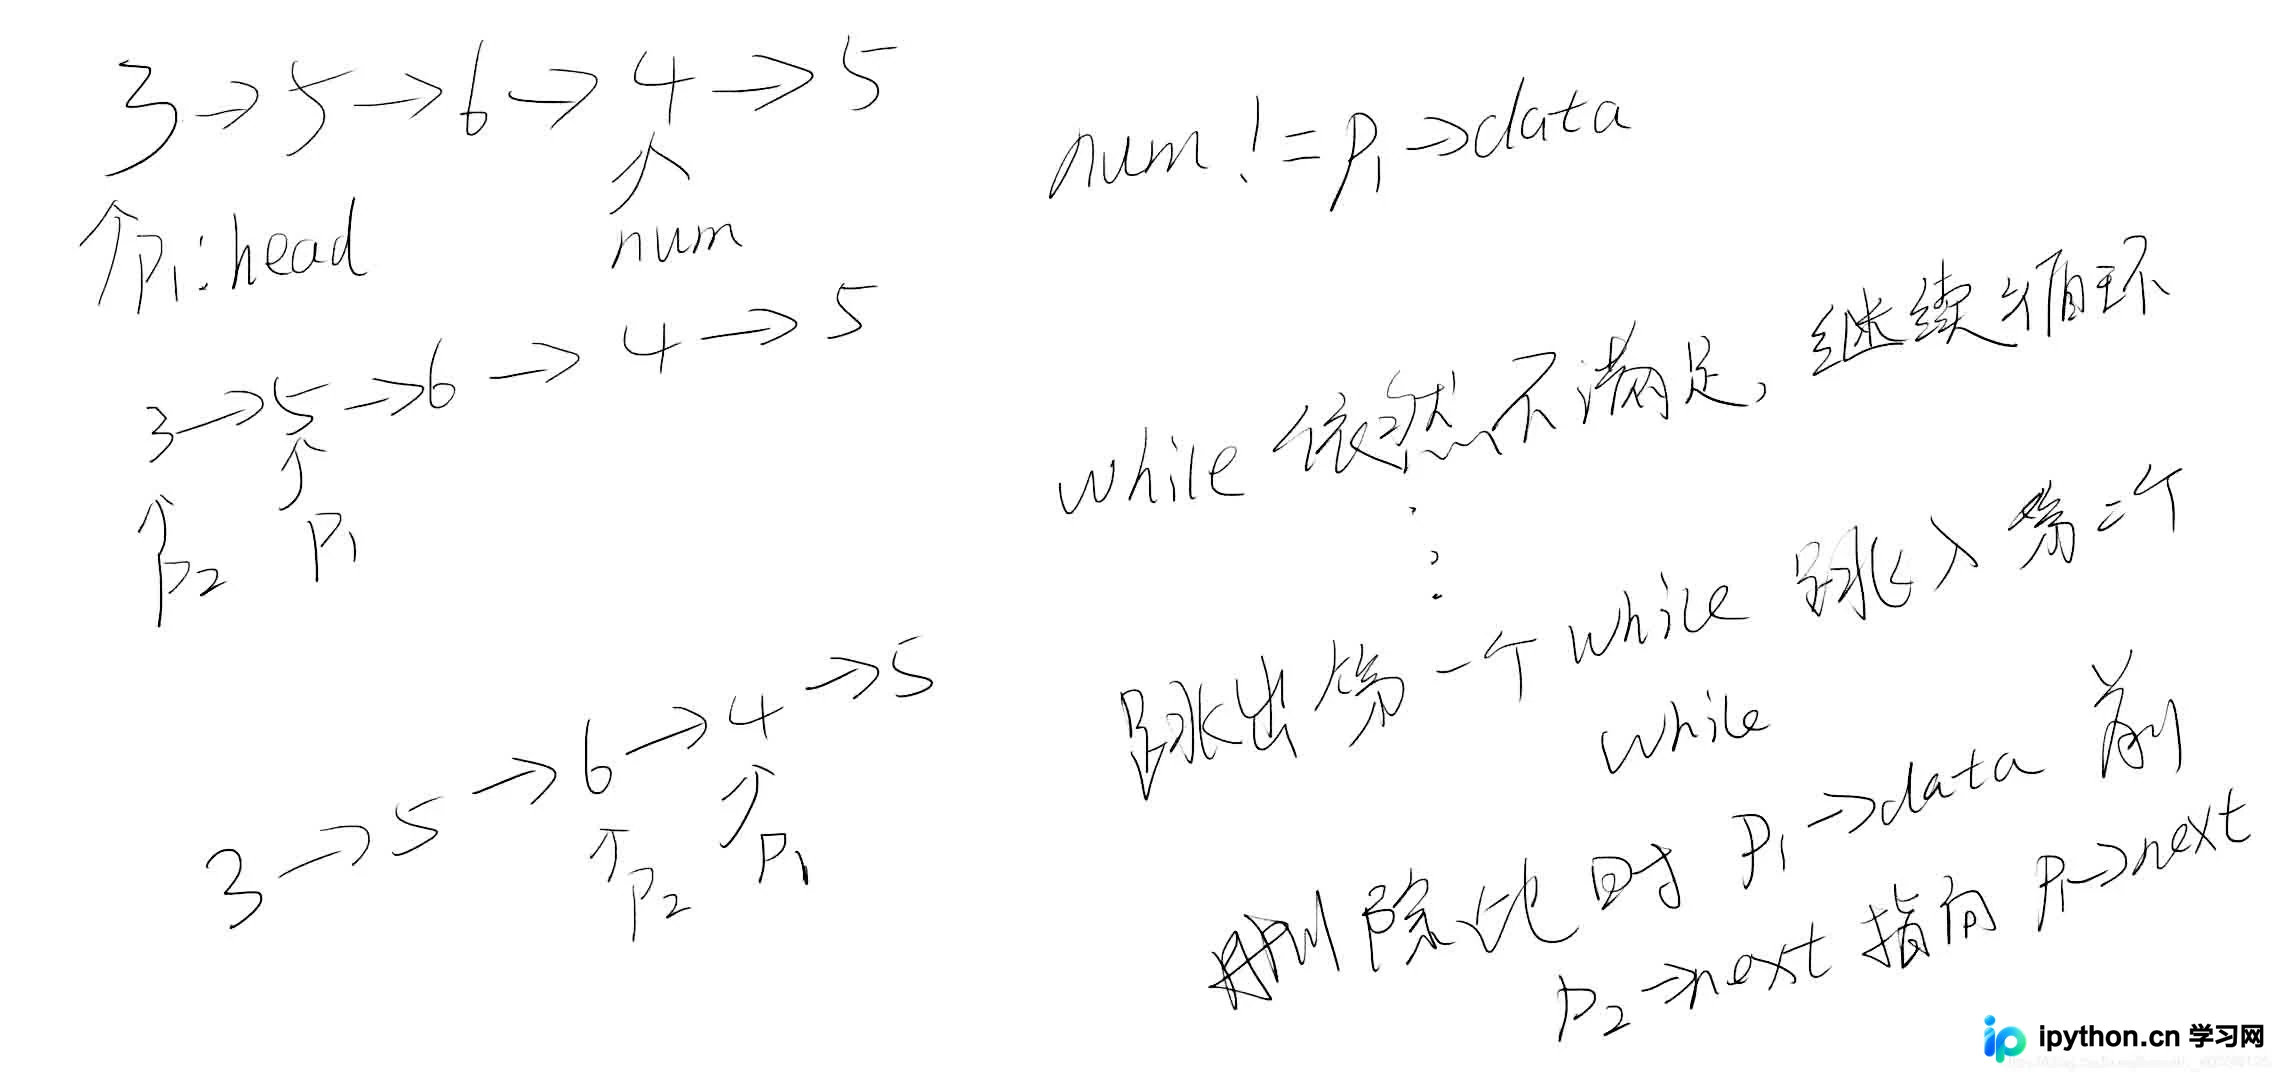
p0(新节点)、p1(遍历指针)、p2(前驱指针) 的关系,调整p2->next和p0->next。 - 尾部插入:当遍历到链表末尾且新节点值最大时,直接将最后一个节点的
next指向新节点。
第4步:节点删除逻辑
删除指定值的节点时,需先遍历找到目标节点及其前驱节点。若目标为头节点,直接释放头节点并将 head 指向下一个节点;否则,将前驱节点的 next 指向目标节点的后继,并释放目标节点的内存。若未找到指定值,则输出提示信息。
第5步:排序功能实现
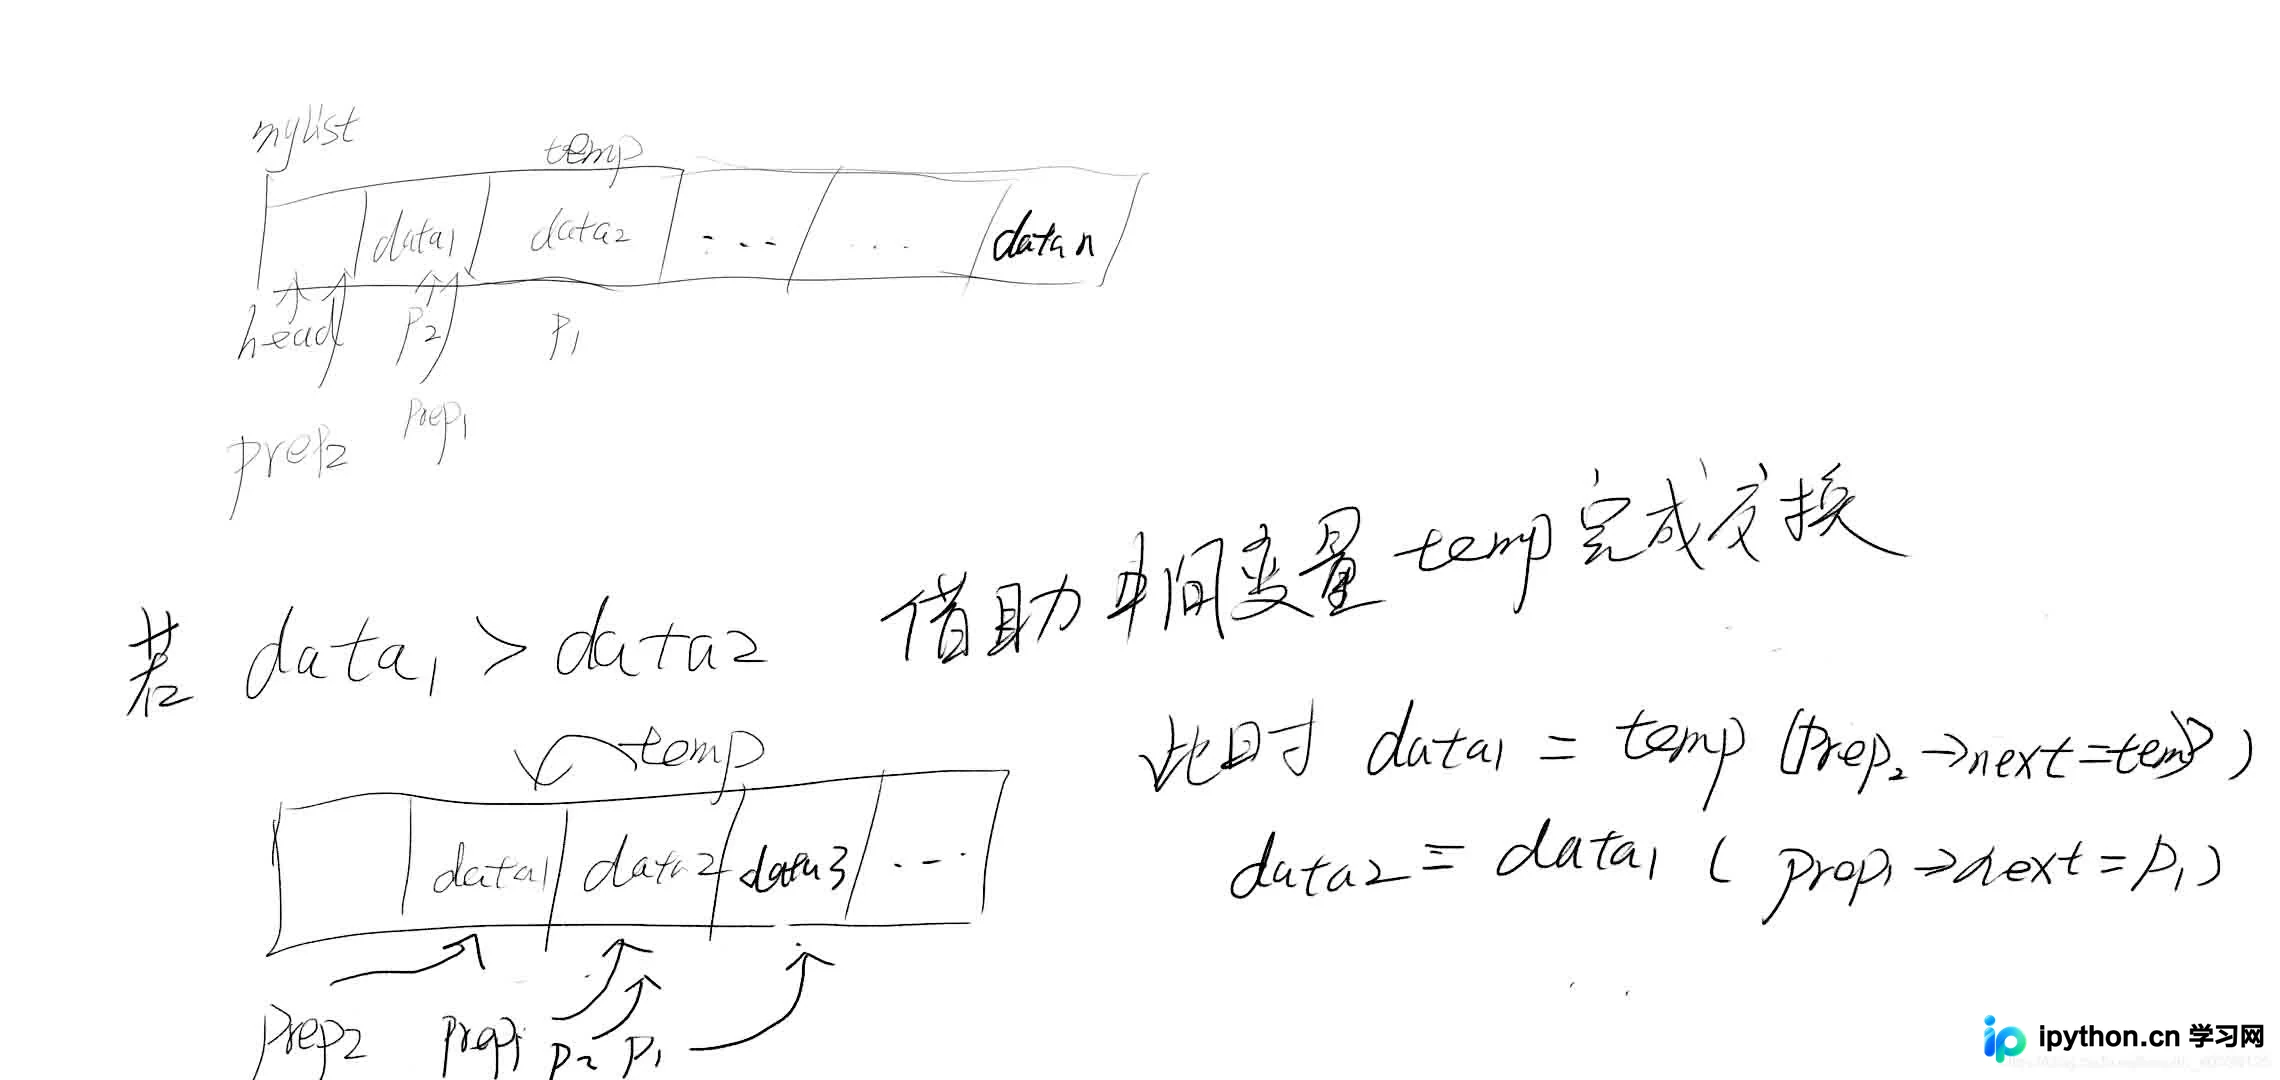
该实现包含一个插入排序版本。由于单向链表的局限性,对于未排序部分的节点,只能从头部开始扫描寻找合适的插入位置。虽然时间复杂度较高,但展示了原地排序的逻辑。
以下是包含创建、打印、插入、删除及排序的完整实现代码:
#include <iostream>
#include <stdio.h>
#include <string>
#include <conio.h>

using namespace std;

struct node
{
	int data;
	node *next;
};
typedef struct node node, *list;

// 创建单链表 (尾插法)
node *creat()
{
	node *head, *p;
	head = new node;
	p = head;

	int x, cycle = 1;
	while (cycle)
	{
		cout << "Please input the data for single linker : ";
		cin >> x;

		if (x != 0)
		{
			node *s = new node;
			s->data = x;
			p->next = s;
			p = s;
		}
		else
		{
			cycle = 0;
		}
	}

	head = head->next;
	p->next = NULL;
	return head;
}

// 获取长度
int length(node *head)
{
	int n = 0;
	node *p = head;
	while (p != NULL)
	{
		p = p->next;
		n++;
	}
	return n;
}

// 打印链表
void printL(node *head)
{
	node *p = head;
	while (p != NULL)
	{
		cout << "Single Linker data is " << p->data << endl;
		p = p->next;
	}
}

// 插入节点 (保持升序)
node *insert(node *head, int num)
{
	node *p0, *p1, *p2;
	p1 = head;
	p2 = new node;
	p0 = new node;
	p0->data = num;

	while (p0->data > p1->data && p1->next != NULL)
	{
		p2 = p1;
		p1 = p1->next;
	}

	if (p0->data <= p1->data)
	{
		if (p1 == head)
		{
			head = p0;
			p0->next = p1;
		}
		else
		{
			p2->next = p0;
			p0->next = p1;
		}
	}
	else
	{
		p1->next = p0;
		p0->next = NULL;
	}
	return head;
}

// 删除节点
node *del(node *head, int num)
{
	node *p1, *p2;
	p2 = new node;
	p1 = head;

	while (num != p1->data && p1->next != NULL)
	{
		p2 = p1;
		p1 = p1->next;
	}

	if (num == p1->data)
	{
		if (p1 == head)
		{
			head = p1->next;
			delete p1;
		}
		else
		{
			p2->next = p1->next;
			delete p1;
		}
	}
	else
	{
		cout << num << " could not been found!" << endl;
	}
	return head;
}

// 插入排序
node *insertSort( node *head )
{
	node  *p1, *prep1, *p2, *prep2, *temp;
	if(head == NULL || head->next == NULL) return head;

	prep1 = head->next;
	p1 = prep1->next;
	bool flag;

	while (p1 != NULL)
	{
		flag = true;
		temp = p1;
		for (prep2 = head, p2 = head->next; p2 != p1; prep2 = prep2->next, p2 = p2->next)
		{
			if (p2->data > p1->data)
			{
				p1 = p1->next;
				prep1->next = p1;
				prep2->next = temp;
				temp->next = p2;
				flag = false;
				break;
			}
		}
		if (flag)
		{
			prep1 = prep1->next;
			p1 = p1->next;
		}
	}
	return head;
}

int main()
{
	cout << "***创建单链表***" << endl;
	node *head = creat();
	cout << endl;

	cout << "***计算链表长***" << endl;
	int n = length(head);
	cout << "The length of input single linker is " << n << "." << endl;
	cout << endl;

	cout << "***打印单链表***" << endl;
	printL(head);
	cout << endl;

	cout << "****插入节点****" << endl;
	cout << "Please input the data for inserting operate : ";
	int inData;
	cin >> inData;
	head = insert(head, inData);
	printL(head);
	cout << endl;

	cout << "****删除节点****" << endl;
	cout << "Please input the data for deleting operate : ";
	int outData;
	cin >> outData;
	head = del(head, outData);
	printL(head);
	cout << endl;

	cout << "****进行排序****" << endl;
	head = insertSort(head);
	printL(head);

	return 0;
}
在上述代码的运行过程中,我们通过具体的操作日志观察节点的变化。例如,在进行特定数值插入时,系统会自动查找其在有序序列中的正确位置。
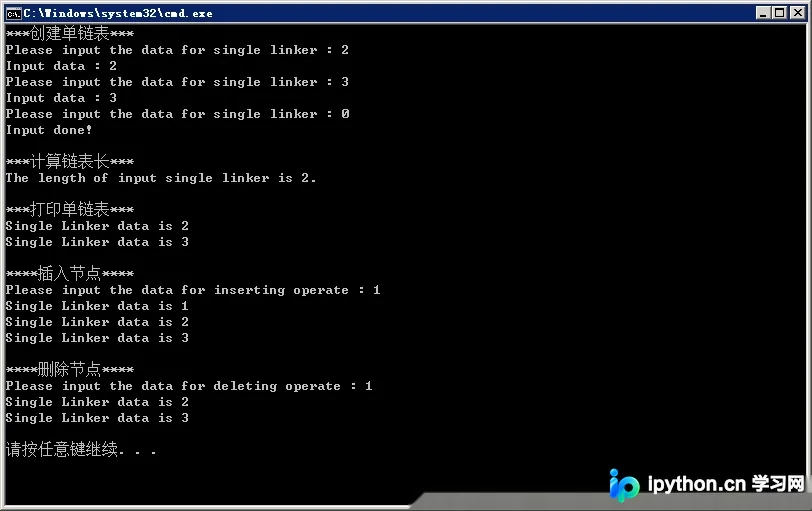
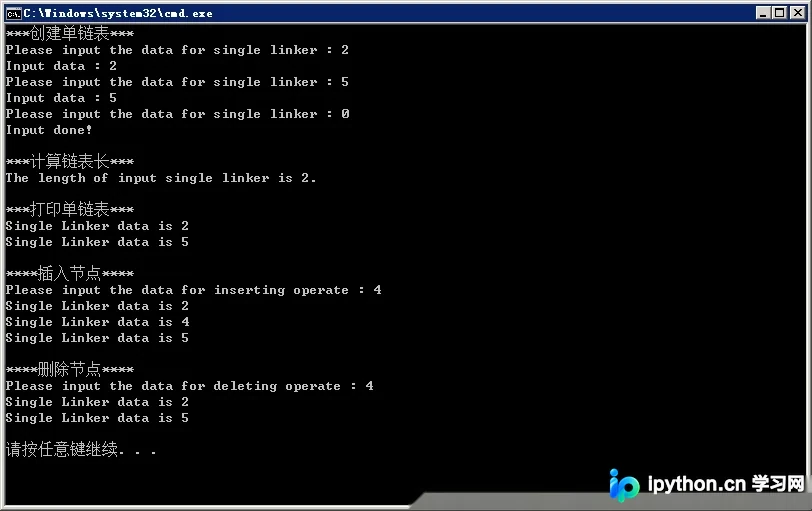
这是头部插入或首个节点被处理时的典型输出表现。接下来展示的是在链表中间插入节点的情况,可以看到原有节点位置发生了偏移。
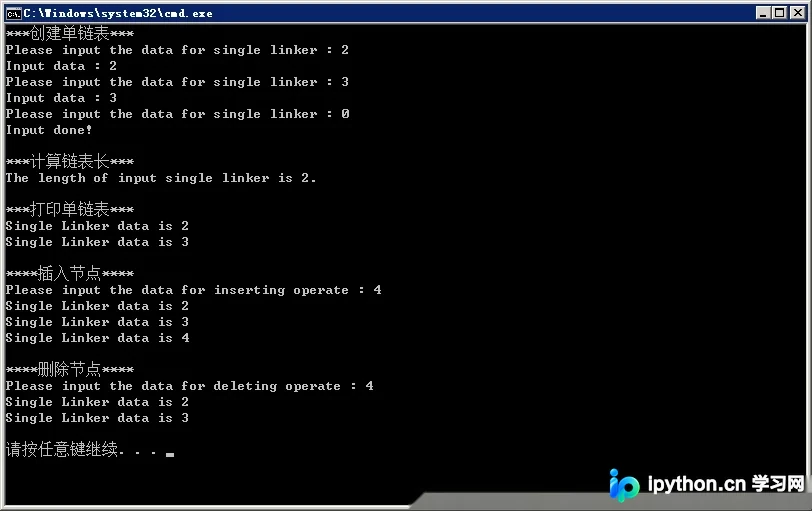
当插入节点位于链表末尾时,其前驱节点的 next 指针会被重新指向新节点,而新节点的 next 置为空。
删除操作同样会在控制台打印出剩余的数据,验证链表结构的完整性。
排序完成后的结果展示,节点按照数值大小重新排列。
带头结点的标准单链表实现
在大多数教材和工程实践中,为了提高代码的一致性和减少边界条件的判断,通常会引入一个“不存数据”的头结点。这样,头指针始终指向头结点,无论链表是否为空,对第一个实际节点的访问都遵循相同的逻辑。
第1步:初始化与基本查询
InitList 函数负责创建一个新节点作为头结点,并将其 next 置为 NULL。GetElem 实现了按位序查找,通过循环移动指针 j 次到达第 i 个节点。这种按位查找的时间复杂度为 O(n)。
第2步:建表策略对比
- 头插法 (
List_HeadInsert):每输入一个元素,都将其插入到头结点和旧的首元节点之间。这种方法生成的链表顺序与输入顺序相反,因为它是典型的后进先出逻辑。 - 尾插法 (
List_TailInsert):维持一个尾指针r,新节点总是附加在r->next处,并更新r。这种方式保持了输入数据的原始顺序。
第3步:高效的前插与后插
对于已知指针 p 的操作:
InsertNextNode 直接在 p 之后插入,这是最自然的插入方式。
InsertPriorNode 在 p 之前插入。由于单链表无法反向访问,这里采用了“偷天换日”的技巧:创建新节点 s,让 s 指向 p->next,将 p 的数据拷贝给 s,然后将 p 的数据修改为新值。时间复杂度降至 O(1)。
第4步:删除操作的优化
DeleteNode 同样利用了数据覆盖技术。若要删除节点 p,且已知其存在后继节点 s,我们可以将 s 的数据拷贝到 p,然后删除 s。这需要特别注意的是,如果 p 是最后一个节点,它没有后继,此时该方法失效,必须从前驱节点入手或使用 DeleteNextDNode。
以下是基于头结点的标准化实现代码,涵盖了上述所有高级操作:
#include <iostream>
#include <stdio.h>
#include <string>
using namespace std;

struct LNode {
    int data;
    LNode *next;
};
typedef LNode LNode;
typedef LNode *LinkList;

void InitList(LinkList &L) {
    L = new LNode;
    L->next = NULL;
}

bool Empty(LinkList &L) {
    return L->next == NULL;
}

int GetLength(LinkList &L) {
    LNode *p = L->next;
    int length = 0;
    while (p != NULL) {
        p = p->next;
        length++;
    }
    return length;
}

LNode *GetElem(LinkList &L, int i) {
    if (i < 0) return NULL;
    LNode *p = L;
    int j = 0;
    while (p != NULL && j < i) {
        p = p->next;
        j++;
    }
    return p;
}

LinkList List_HeadInsert(LinkList &L) {
    LNode *s;
    int e;
    cin >> e;
    while (e != 9999) {
        s = new LNode;
        s->data = e;
        s->next = L->next;
        L->next = s;
        cin >> e;
    }
    return L;
}

LinkList List_TailInsert(LinkList &L) {
    LNode *r = L;
    int e;
    cin >> e;
    while (e != 9999) {
        LNode *s = new LNode;
        s->data = e;
        r->next = s;
        r = s;
        cin >> e;
    }
    r->next = NULL;
    return L;
}

bool InsertNextNode(LNode *p, int e) {
    if (!p) return false;
    LNode *q = new LNode;
    q->data = e;
    q->next = p->next;
    p->next = q;
    return true;
}

bool DeleteNextDNode(LNode *p) {
    if (!p || !p->next) return false;
    LNode *s = p->next;
    p->next = s->next;
    delete s;
    return true;
}

void TraverseList(LinkList &L) {
    LNode *p = L->next;
    while (p != NULL) {
        cout << p->data << " ";
        p = p->next;
    }
    cout << endl;
}

int main() {
    LinkList L;
    InitList(L);
    // 测试尾插法
    cout << "请输入数据 (以9999结束):" << endl;
    List_TailInsert(L);

    TraverseList(L);

    // 测试在第二个位置插入数据 (即在第1个元素后插入)
    LNode *pos = GetElem(L, 1);
    InsertNextNode(pos, 8888);
    TraverseList(L);

    // 测试删除
    // ...省略部分测试逻辑
    return 0;
}
总结与最佳实践
在 C++ 开发中,合理使用头结点可以极大地简化代码逻辑,特别是避免了针对第一个元素的单独条件分支。需要注意的是,在函数传参时,如果可能改变头指针本身(如不带头结点的链表的头插/头删),必须使用引用或二级指针;而对于带头结点的链表,只需传递头指针即可,因为头结点地址固定不变,我们只修改其后续指针。
以上就是 C++ 单链表创建、插入、删除和排序的详细内容,更多关于 C++ 数据结构与算法的资料请关注本站其它相关文章!本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















