


MySQL数据去重的三种常用方法详解

在涉及多角色数据对比或复杂报表生成时,消除冗余记录至关重要。本文深入解析MySQL中三种核心去重策略:基础的DISTINCT关键字、聚合层面的GROUP BY,以及高级的ROW_NUMBER()窗口函数,帮助开发者根据具体场景选择最优方案。
场景背景:为何需要去重
在实际业务联调中,常遇到从多个数据源汇总信息的需求。例如,将不同角色下的权限数据进行合并,仅保留最新状态或唯一标识的记录。若直接查询,往往会产生大量重复数据,此时必须通过有效的去重手段来清洗结果集。
一、使用 DISTINCT 简单过滤
DISTINCT 是 MySQL 中最直观的去重关键字,它强制查询结果返回唯一的行组合。
1. 基础查询行为
如果不加任何修饰,SELECT 语句会返回所有匹配的行,包括重复值:
SELECT t.age FROM t_user t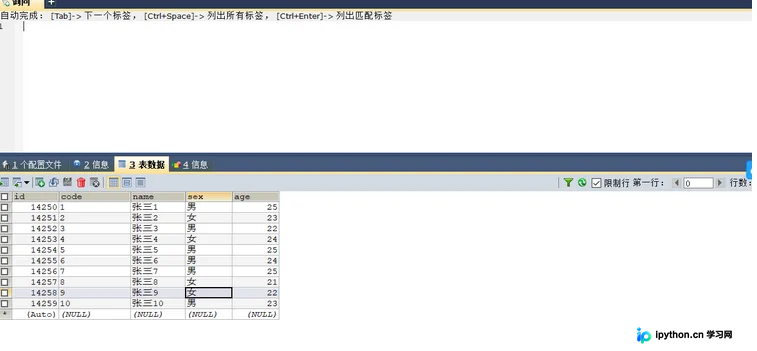
如上所示,查询可能返回多条包含相同 age 值的记录。当我们需要对年龄分布进行统计或展示唯一名单时,这些重复项即为干扰数据。
2. 应用 DISTINCT 去重
在 SELECT 后添加 DISTINCT 即可消除重复:
SELECT DISTINCT <字段名> FROM <表名>;
-- 示例:
SELECT DISTINCT t.age FROM t_user t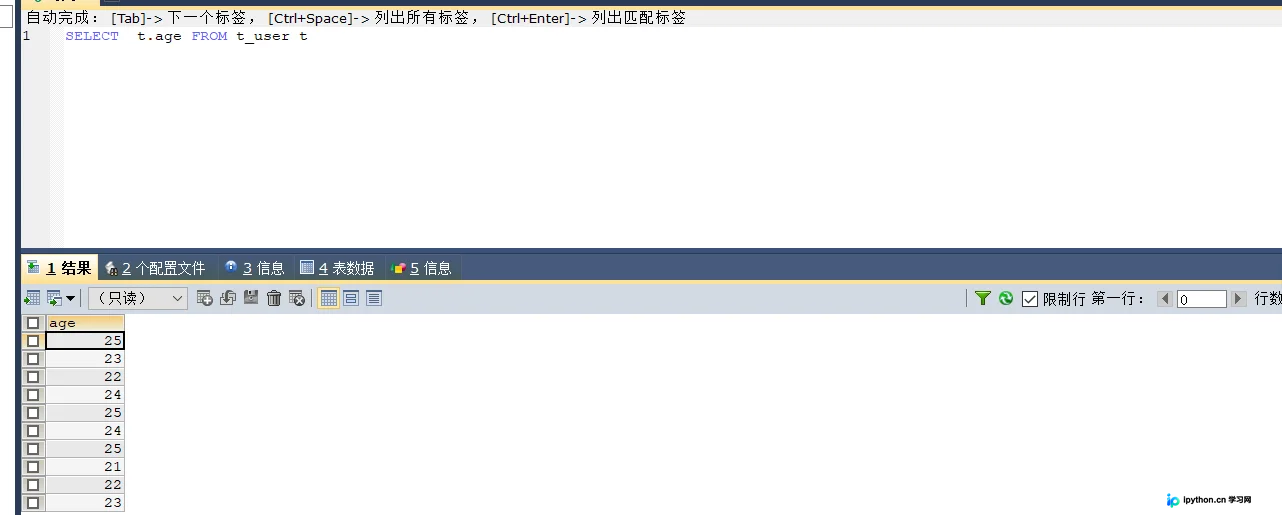
执行后,结果集将只包含唯一的 age 值。其核心规则如下:
- 作用范围:
DISTINCT仅用于SELECT语句,且必须位于所有字段的最前方。 - 多字段组合去重:若指定多个字段(如
SELECT DISTINCT age, name ...),系统会对这些字段的组合进行去重。只有当所有指定字段的值完全一致时,才会被视为重复记录并被剔除。
二、使用 GROUP BY 分组去重
GROUP BY 通常用于聚合统计,但利用其“按组归类”的特性,也可以实现去重效果。它与 DISTINCT 在单一字段去重时功能相似,但在涉及聚合函数时更具灵活性。
操作语法:
SELECT <字段名> FROM <表名> GROUP BY <字段名>;实例演示:
SELECT t.age FROM t_user t GROUP BY t.age;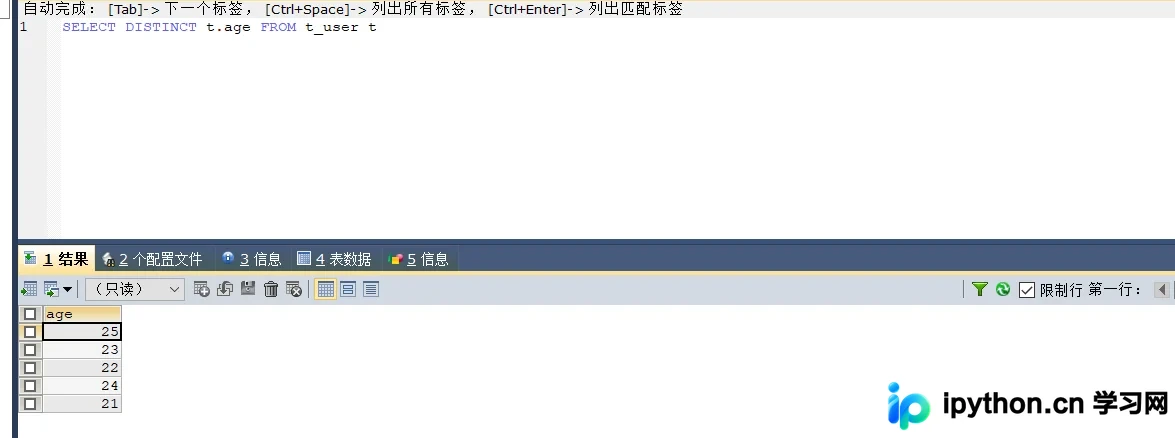
对比分析:
虽然结果可能与 DISTINCT 一致,但在处理逻辑上存在差异:GROUP BY 允许在处理重复键的同时提取各组的其他聚合信息(如 MAX(), COUNT()),适合更复杂的预处理场景。
三、使用 ROW_NUMBER() 精准去重
对于现代业务需求,简单的唯一性判断往往不够。我们通常需要根据某一列的值(如更新时间)来决定保留哪一条记录。此时,窗口函数 ROW_NUMBER() 是最佳选择。
1. 核心语法
ROW_NUMBER() OVER (
  PARTITION BY <用于分组的字段名>
  ORDER BY <用于组内排序的字段名>
)
该函数会为每个分组内的行分配一个唯一的序号(1, 2, 3...)。配合子查询,我们可以轻松提取每组的第一条记录。
2. 实战案例:保留最新权限数据
假设需要从 mdm_data_authority_view_info 表中,针对特定分类和角色,保留每条记录的最新版本:
SELECT * FROM (
    SELECT
        t.*,
        ROW_NUMBER() OVER(
            PARTITION BY t.children_id
            ORDER BY t.update_time DESC
        ) AS rn
    FROM mdm_data_authority_view_info t
    WHERE t.DATA_CLASS_ID = '分类id'
      AND t.DATA_ROLE_ID IN ('角色id', '角色id')
) AS subquery
WHERE subquery.rn = 1;
逻辑解析:
- 内部查询:首先筛选出目标数据,并使用
PARTITION BY按子ID分组,在组内按更新时间倒序排列,生成序号rn。 - 外部查询:仅选取
rn = 1的记录,即每个分组中时间最新的唯一一条数据。
总结
Mysql数据去重并非只有一种解法。DISTINCT 适用于快速筛选唯一值;GROUP BY 兼顾聚合统计与去重;而 ROW_NUMBER() 则提供了基于业务规则(如“取最新”、“取最大”)的高级去重能力。开发者应根据数据量级及具体业务逻辑灵活选用。
以上就是MySQL数据去重三种方式的详细内容,更多关于MySQL高效查询优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















