


Python 使用 python-docx 读取与解析 Word 文档

本文详细演示如何使用 Python 的 python-docx 库加载 .docx 文件,通过 core_properties 获取作者与创建日期等元数据,遍历 paragraphs 过滤空行并提取纯文本,同时利用 runs 属性精准判断粗体与斜体样式。全程提供可运行的代码示例,适用于自动化文档解析与内容抓取场景。
操作目标与前置条件
本文将指导如何通过 Python 自动读取 Word 文档的结构与内容。开始前需确保已安装第三方库 python-docx。在终端执行以下命令完成环境准备:
$ pip install python-docx第1步:加载 Word 文档并检查元数据
导入模块后,使用 Document() 方法载入目标文件。加载成功后即可通过 core_properties 访问内置元数据(如标题、关键词、修改时间)。需注意,并非所有 Word 文件都完整填充了这些字段,部分由工具生成的文档可能为空值。
>>> import docx
>>>> doc = docx.Document('document_1.docx')
>>>> doc.core_properties.title
'Research Overview of Adversarial Attacks and Defenses on Graphs'
>>>> doc.core_properties.keywords
'Abstract'
>>>> doc.core_properties.modified
datetime.datetime(2020, 8, 1, 3, 11)
第2步:遍历段落并筛选有效文本
Word 文档的数据按段落(paragraphs)结构化存储,而非按页。由于存在大量换行符或空白字符,直接打印会导致冗余输出。建议遍历列表时判断 paragraph.text 是否为真值,从而跳过空段落:
>>> for index, paragraph in enumerate(doc.paragraphs):
...     if paragraph.text:
...             print(index, paragraph.text)
若需精确提取特定位置的文本,可直接传入索引值。例如获取第 5 段(主标题)和第 6 段(摘要标识)的内容:
>>> doc.paragraphs[5].text
'Research Overview of Adversarial Attacks and Defenses on Graphs'
>>>> doc.paragraphs[6].text
'Abstract '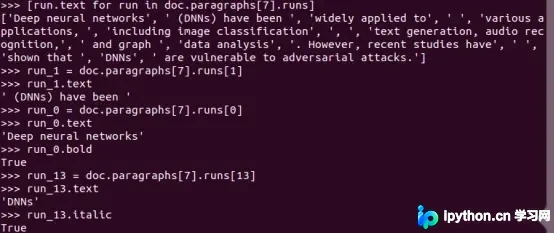
第3步:解析段落内的样式属性(Runs)
paragraph 内部进一步划分为多个 runs 对象。同一视觉样式的连续文字会被合并为一个 run,而中途改变格式的文字则会被拆分为新的 run。通过访问 run 对象的 bold 和 italic 属性,即可检测加粗或斜体状态:
>>> doc.paragraphs[5].runs[0].bold
True
>>>> doc.paragraphs[7].runs[0].text
'Deep neural networks'
>>>> doc.paragraphs[7].runs[0].bold
True
>>>> doc.paragraphs[7].runs[13].text
'DNNs'
>>>> doc.paragraphs[7].runs[13].italic
True
完成判断与常见问题排查
- 元数据缺失:若读取
core_properties返回空字符串或报错,说明该 Word 文件未保留底层元数据,属正常现象。 - 样式断裂:Word 排版中频繁切换字体或大小会导致一个自然段被切分成数十个 runs。处理复杂样式表时,建议先按
runs分组再聚合文本,避免丢失格式标记。
总结
以上就是使用 Python 配合 python-docx 库读取与解析 Word 文档的详细内容,更多关于自动化提取文档元数据、段落文本及富文本样式的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















