


ClickHouse常用表引擎详解:MergeTree家族与日志引擎

ClickHouse的高性能查询能力依赖于合适的表引擎选择。本文深入解析以MergeTree为核心的存储机制,涵盖排序、主键稀疏索引、分区管理及TTL数据生命周期配置;同时说明ReplacingMergeTree的后台去重逻辑与SummingMergeTree的预聚合特性,并提供TinyLog、Memory等轻量级引擎的使用建议。
表引擎的作用与分类
表引擎(Engine)是ClickHouse中最关键的部分,它决定了数据的存储位置、读写方式、索引结构以及并发控制策略。选择合适的引擎可以直接影响查询性能和数据管理的便利性。
第1步:理解核心概念
不同引擎在处理数据时有显著差异,以下是主要特性对比:
- TinyLog:最简单的列式存储引擎,不支持索引,适合小批量中间数据。
- Memory:数据保存在内存中,读写极快但重启丢失,无索引支持。
- MergeTree系列:单节点默认引擎,支持列存、分区、稀疏索引及高并发写入。
合并树家族(MergeTree Family)
MergeTree家族是ClickHouse最常用的引擎,具备以下共同特点:
- 快速插入大量数据并异步进行后台处理。
- 支持数据复制和高可用。
- 支持数据分区,缩小扫描范围。
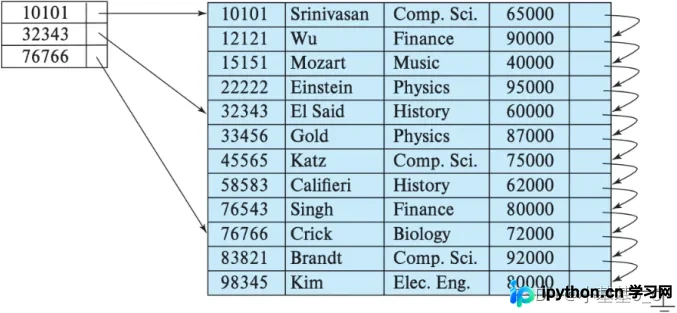
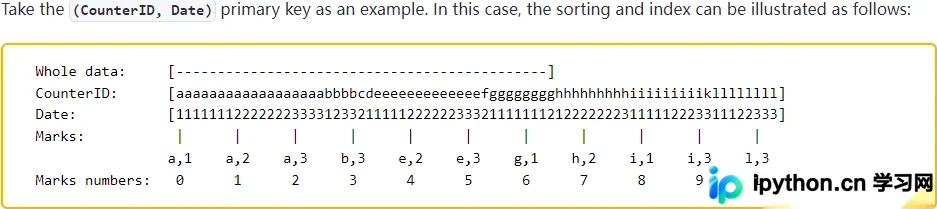
- 利用稀疏索引提升查询效率,同时节省存储空间。
第2步:基础MergeTree建表语法
标准建表语句需明确指定关键字参数:
CREATE TABLE [IF NOT EXISTS] [db.]table_name [ON CLUSTER cluster](
    name1 [type1] [DEFAULT|MATERIALIZED|ALIAS expr1] [TTL expr1],
    ... INDEX index_name expr TYPE type(...) GRANULARITY value,
) ENGINE = MergeTree()
ORDER BY expr
[PARTITION BY expr]
[SAMPLE BY expr]
[TTL expr [DELETE|TO DISK 'xxx'|TO VOLUME 'xxx'], ...]
[SETTINGS name=value, ...];关键参数说明:ENGINE指定引擎类型;ORDER BY定义数据排序规则(必选);PARTITION BY用于分区;PRIMARY KEY设置稀疏索引主键。
第3步:配置排序键与主键
排序键(ORDER BY):必须指定。若不需特定排序,可使用 ORDER BY tuple() 保持插入顺序。按有序数据存储可显著提升压缩率。
主键(PRIMARY KEY):默认与排序键相同。主键并非唯一约束,而是构建稀疏索引以提升查询速度。若需自定义主键,必须为排序列的前缀,例如 ORDER BY (a,b) 时,主键只能是 (a) 或 (a,b)。
第4步:管理数据分区
PARTITION BY用于将大表拆分为多个物理目录。新建的数据批次会先落入临时分区,随后后台自动合并。建议分区粒度按月(如 toYYYYMMDD(create_time)),过细的分区会导致文件数量激增,降低查询效率。
可以使用 OPTIMIZE TABLE t1 FINAL; 强制触发分区合并。
第5步:设置数据生命周期(TTL)
通过 TTL 子句可实现数据的时间管理:
- 列级别TTL:过期后将该列值替换为默认值。
- 表级别TTL:满足条件后删除整行数据(如
TTL d + INTERVAL 1 MONTH DELETE)。
第6步:ReplacingMergeTree去重处理
ReplacingMergeTree 适用于需要实时获取最新状态的去重场景(如订单更新)。它在后台合并时,按照排序键过滤重复记录:
- 未指定版本列
ver:保留最后写入的行。 - 指定
ver:保留版本号最大的行。
注意:由于合并是非实时的,查询时需确保已执行合并或使用聚合函数。
第7步:SummingMergeTree预聚合
当业务只需维度汇总结果而不关心明细时,使用 SummingMergeTree(columns)。在合并过程中,指定数值列会自动求和。由于聚合滞后,建议使用 SUM(column) 进行查询而非直接取列值。
其他常见引擎
日志家族(TinyLog, Log, StripeLog)
此类引擎适用于测试或小规模数据(百万行以内)。它们简单地将追加数据到文件,不提供索引且写操作会锁定表。异常断电可能导致数据损坏。
-- 示例:使用默认的TinyLog
CREATE TABLE t_small (
    event_date Date,
    event_text String
) ENGINE = TinyLog();
内存引擎(Memory)
所有数据均在运行内存中处理,读取速度快且不阻塞,但服务器重启后数据即刻消失。不支持索引,常用于中间计算结果的临时存储。
CREATE TABLE t_mem (
    id UInt32,
    val Float64
) ENGINE = Memory();
总结
掌握MergeTree家族的配置(尤其是排序与分区策略)是发挥ClickHouse性能的关键。对于无需持久化的分析任务可选用Memory引擎,而简单的流水账记录则适合TinyLog。根据具体的访问模式和存储需求选择正确的表引擎,能有效平衡查询速度与资源开销。
以上就是ClickHouse常用表引擎的详细内容,更多关于ClickHouse优化配置的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















